Modèle de concours de recrutement des ingénieurs d'État du 1er grade — Conseil Supérieur du Pouvoir Judiciaire 2019 — Informatique décisionnelle
⬇️ Télécharger le PDF Adresse permanente : wadifa-info.com/fr/modele-concours/3363
En bref
Ce document est une ancienne épreuve écrite du concours de Ingénieur d'État du 1er grade organisé par Conseil Supérieur du Pouvoir Judiciaire (2019), publiée sur Wadifa Info en consultation et téléchargement PDF gratuits, avec une correction proposée.
- Organisme
- Conseil Supérieur du Pouvoir Judiciaire
- Grade
- Ingénieur d'État du 1er grade
- Spécialité
- Systèmes décisionnels (BI)
- Année
- 2019
- Pages
- 6
- Langue des questions
- français
- Correction
- correction proposée disponible sur cette page
- Ajouté au site
- 05/10/2026
Correction proposée : Modèle de concours de recrutement des ingénieurs d'État du 1er grade — Conseil Supérieur du Pouvoir Judiciaire 2019 — Informatique décisionnelle
Il s'agit d'une correction proposée, rédigée par l'équipe wadifa-info pour vous aider à comprendre la méthode — ce n'est pas un corrigé officiel de l'administration organisatrice.
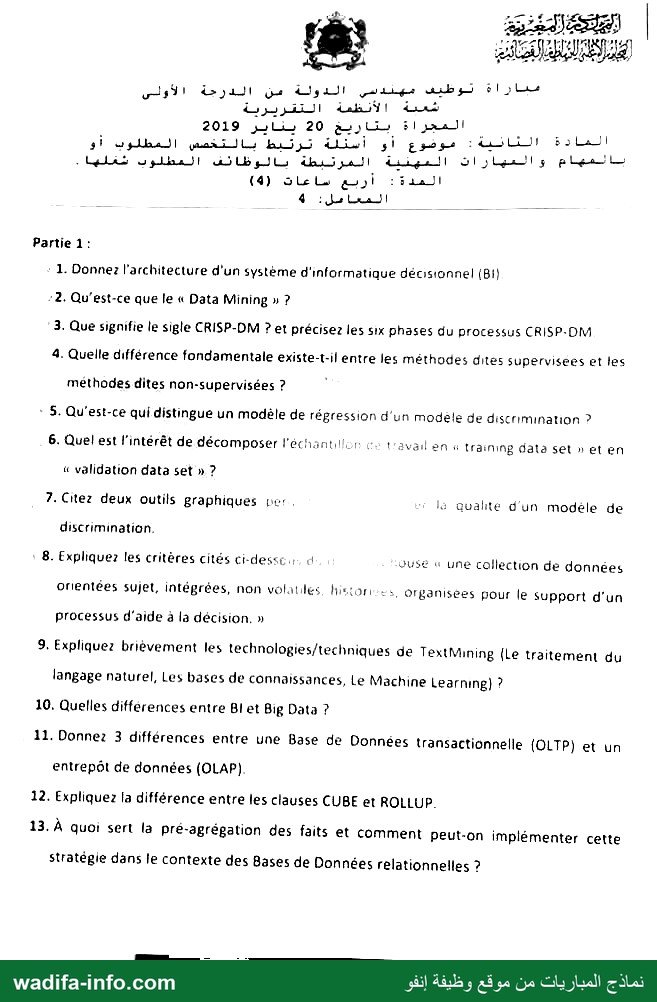
Ce modèle est la deuxième épreuve (épreuve de spécialité) du concours de recrutement d'ingénieurs d'État du 1er grade du Conseil Supérieur du Pouvoir Judiciaire, filière systèmes décisionnels, session du 20 janvier 2019. Durée : 4 heures ; coefficient 4. Le sujet (6 pages) comporte une partie 1 de 15 questions de cours (BI, data mining, entrepôts de données, OLAP) et une partie 2 de 6 exercices : cube MOLAP/ROLAP, arbre de décision ID3, SQL analytique Oracle et trois modélisations en étoile.
💡 ID3 : le jury note les calculs. Écrivez l'entropie de départ, puis le gain de chaque attribut sous forme de tableau. Un attribut dont toutes les branches sont pures (entropie nulle) l'emporte presque toujours. Vérifiez vos sommes d'effectifs avant de calculer les logarithmes.
Partie 1 : questions de cours
- Architecture BI : sources (ERP, bases OLTP, fichiers, données externes) → ETL (extraction, transformation, chargement, dans une zone de préparation) → entrepôt de données (et ses magasins de données) avec ses métadonnées → serveur OLAP (cubes MOLAP/ROLAP/HOLAP) → restitution (rapports, tableaux de bord, analyse ad hoc, data mining).
- Data mining : processus d'extraction automatique ou semi-automatique de connaissances (modèles, règles, tendances) non triviales et utiles à partir de grands volumes de données, par des méthodes statistiques et d'apprentissage : classification, régression, segmentation, règles d'association.
- CRISP-DM = Cross-Industry Standard Process for Data Mining. Six phases : (1) compréhension du métier ; (2) compréhension des données ; (3) préparation des données ; (4) modélisation ; (5) évaluation ; (6) déploiement. Le processus est itératif.
- Supervisé ou non : une méthode supervisée apprend à partir d'exemples dont la variable cible (étiquette) est connue, pour la prédire (classification, régression). Une méthode non supervisée n'a pas de variable cible : elle cherche des structures dans les données (clustering, règles d'association, ACP).
- Régression ou discrimination : la régression prédit une variable cible quantitative continue (un montant) ; la discrimination (classement) prédit une variable qualitative, c'est-à-dire une classe (admis/non admis).
- Échantillon d'apprentissage et de validation : on construit le modèle sur le training set et on mesure sa performance sur des données qu'il n'a pas vues (validation set). On obtient ainsi une estimation honnête de l'erreur en généralisation, on détecte le sur-apprentissage et on peut régler les paramètres.
- Outils graphiques de qualité d'un modèle de discrimination : la courbe ROC (et son aire, l'AUC) et la courbe de gain (lift) ; la matrice de confusion est l'outil tabulaire associé. Les mots centraux de l'énoncé sont effacés sur le scan, mais la question reste claire.
- Définition d'Inmon : orientées sujet : organisées par thème métier (client, vente), pas par application ; intégrées : codifications, formats et unités homogénéisés entre sources ; non volatiles : pas de mise à jour ni de suppression, on ajoute seulement des données (lecture seule) ; historisées : on garde l'historique daté pour suivre les évolutions ; organisées pour l'aide à la décision : structure pensée pour l'analyse (agrégats, dimensions).
- Text mining : le traitement du langage naturel (tokenisation, lemmatisation, étiquetage morpho-syntaxique, reconnaissance d'entités nommées) transforme le texte en données exploitables ; les bases de connaissances (thésaurus, ontologies) apportent le sens et les relations entre termes ; le machine learning classe, regroupe ou analyse les sentiments des documents à partir de représentations (TF-IDF, embeddings).
- BI et Big Data : la BI analyse des données surtout structurées, historisées et nettoyées, dans un entrepôt relationnel, pour du reporting et de l'analyse a posteriori. Le Big Data traite des volumes, une variété (non structuré) et une vélocité (flux) qui dépassent les outils classiques, avec des architectures distribuées (Hadoop, Spark, NoSQL). Les deux sont complémentaires.
- OLTP ou OLAP : (1) usage : transactions courantes (insertions, mises à jour) contre analyse ; (2) modèle : normalisé (3FN) contre dénormalisé (étoile, flocon) ; (3) données : actuelles et détaillées contre historisées et agrégées ; (4) requêtes : courtes, nombreuses, sur peu de lignes, contre complexes, sur de gros volumes, essentiellement en lecture ; (5) utilisateurs : opérationnels contre décideurs.
- CUBE ou ROLLUP : GROUP BY ROLLUP(a, b, c) calcule les sous-totaux hiérarchiques de droite à gauche : (a,b,c), (a,b), (a), () ; soit n+1 regroupements. GROUP BY CUBE(a, b, c) calcule toutes les combinaisons : 2n = 8 regroupements.
- Pré-agrégation : elle calcule et stocke à l'avance des agrégats fréquemment demandés pour accélérer les requêtes OLAP (au prix d'espace disque et de temps de rafraîchissement). En relationnel : vues matérialisées (Oracle : CREATE MATERIALIZED VIEW … ENABLE QUERY REWRITE, rafraîchissement FAST/COMPLETE), tables d'agrégats alimentées par l'ETL, GROUP BY ROLLUP/CUBE au chargement.
- Modèle dimensionnel ou entité-relation (contexte analytique) : il est simple à comprendre pour les utilisateurs (faits et axes d'analyse) et donne de meilleures performances en lecture (moins de jointures, agrégations faciles, optimisation par jointure en étoile).
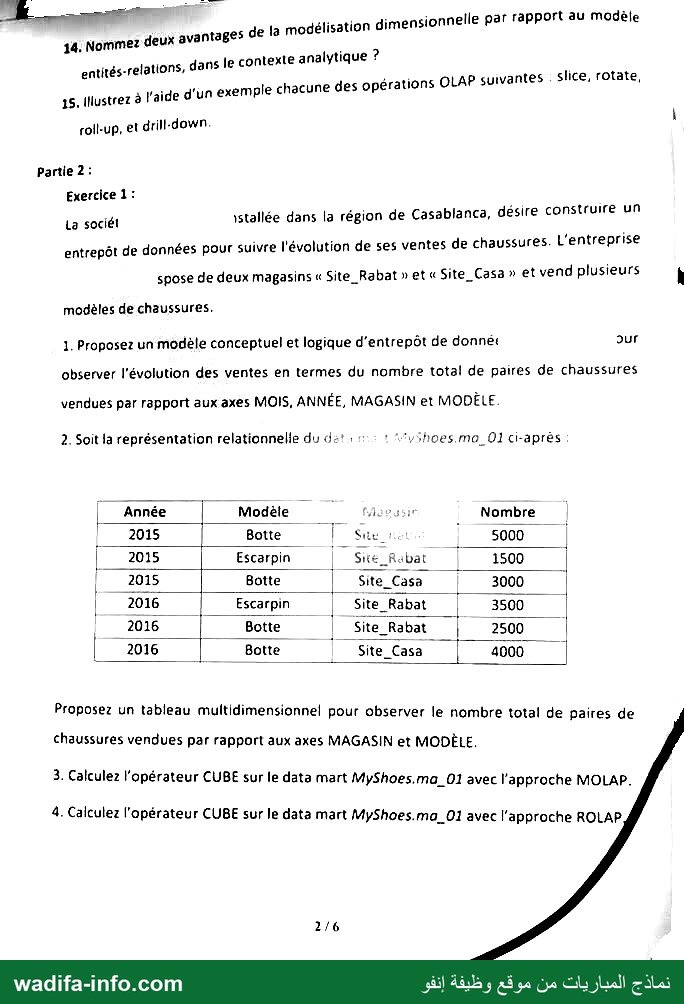
- Opérations OLAP (cube ventes : produit × magasin × temps) : slice = fixer une dimension (ventes de 2016 seulement), on obtient une tranche ; rotate (pivot) = permuter les axes affichés (produits en colonnes et magasins en lignes) ; roll-up = agréger vers un niveau supérieur (mois → année, ville → région) ; drill-down = détailler vers un niveau inférieur (année → trimestre → mois).
Partie 2
Exercice 1 : magasin de données des ventes de chaussures
- Modèle : conceptuel : fait VENTE (mesure : nombre de paires) avec les axes Temps (mois → année), Magasin, Modèle. Logique (étoile) : FAIT_VENTE(#id_temps, #id_magasin, #id_modele, nb_paires) ; DIM_TEMPS(id_temps, mois, annee) ; DIM_MAGASIN(id_magasin, nom_site, ville) ; DIM_MODELE(id_modele, libelle).
- Tableau multidimensionnel Magasin × Modèle (somme 2015 + 2016) :
Magasin \ Modèle Botte Escarpin Total Site_Rabat 7 500 5 000 12 500 Site_Casa 7 000 0 7 000 Total 14 500 5 000 19 500 - CUBE en MOLAP : on ajoute à chaque dimension une valeur ALL et on remplit le tableau 3D (Année × Modèle × Magasin) avec tous les agrégats. Par année : 2015 : Botte 8 000 (Rabat 5 000, Casa 3 000), Escarpin 1 500 (Rabat), total 9 500 (Rabat 6 500, Casa 3 000) ; 2016 : Botte 6 500 (Rabat 2 500, Casa 4 000), Escarpin 3 500 (Rabat), total 10 000 (Rabat 6 000, Casa 4 000). Tranche Année = ALL : le tableau de la question 2 (total général 19 500).
- CUBE en ROLAP : SELECT Annee, Modele, Magasin, SUM(Nombre) FROM MyShoes_ma_01 GROUP BY CUBE(Annee, Modele, Magasin) ; on obtient une table relationnelle où ALL apparaît en NULL : les 6 lignes de base, puis (Année, Modèle) : 2015-Botte 8 000, 2015-Escarpin 1 500, 2016-Botte 6 500, 2016-Escarpin 3 500 ; (Année, Magasin) : 2015-Rabat 6 500, 2015-Casa 3 000, 2016-Rabat 6 000, 2016-Casa 4 000 ; (Modèle, Magasin) : Botte-Rabat 7 500, Botte-Casa 7 000, Escarpin-Rabat 5 000 ; (Année) : 9 500 et 10 000 ; (Modèle) : Botte 14 500, Escarpin 5 000 ; (Magasin) : Rabat 12 500, Casa 7 000 ; (ALL, ALL, ALL) : 19 500.
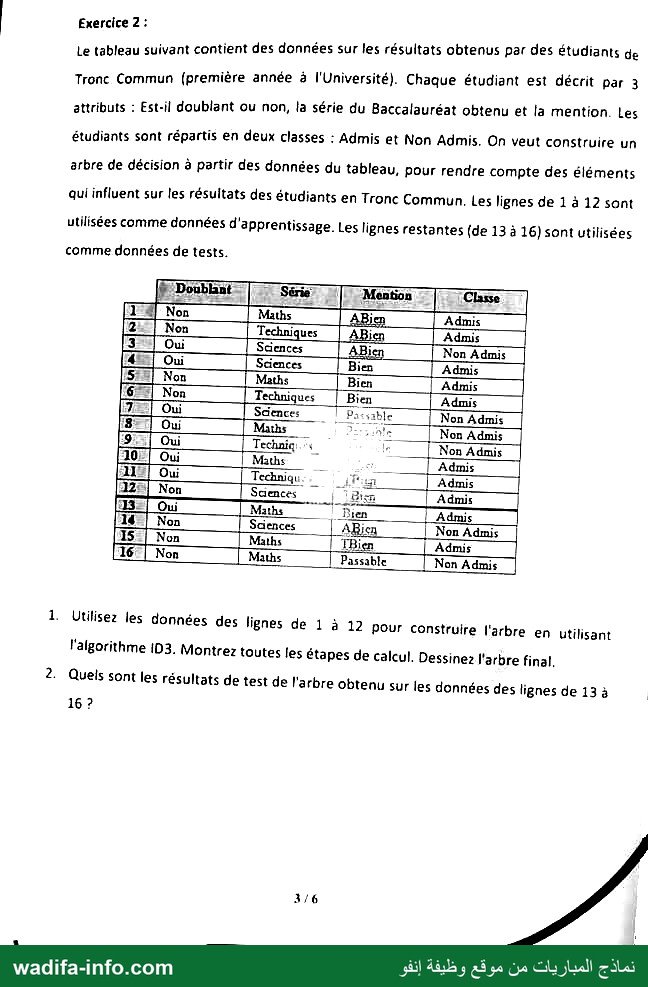
Exercice 2 : arbre de décision ID3 (lignes 1 à 12 : 8 Admis, 4 Non admis). Sur le scan, les mentions des lignes 8 à 12 sont en partie masquées ; on lit Passable (8, 9) et TBien (11, 12), et la ligne 10 est Bien ou TBien. Le calcul est identique dans les deux cas.
- Entropie initiale : H(S) = −(8/12)log2(8/12) − (4/12)log2(4/12) = 0,918.
Racine = Mention. Les branches Bien et TBien donnent Admis, la branche Passable donne Non admis. Branche ABien (lignes 1, 2, 3) : Doublant (Non → Admis, Oui → Non admis) et Série (Maths, Techniques → Admis ; Sciences → Non admis) donnent tous deux un gain maximal de 0,918 ; à égalité, on retient le premier attribut, Doublant.Attribut Partition (Admis/Non admis) Entropie pondérée Gain Doublant Non : 5/0 ; Oui : 3/4 7/12 × 0,985 = 0,575 0,344 Série Maths 3/1 ; Techniques 3/1 ; Sciences 2/2 0,270 + 0,270 + 0,333 = 0,874 0,044 Mention ABien 2/1 ; Bien 3/0 (ou 4/0) ; Passable 0/3 ; TBien 3/0 (ou 2/0) 3/12 × 0,918 = 0,230 0,689
Arbre final : Mention = Bien ou TBien → Admis ; Mention = Passable → Non admis ; Mention = ABien → Doublant = Non → Admis, Doublant = Oui → Non admis. - Test (lignes 13 à 16) : 13 (Oui, Maths, Bien) → Admis, juste ; 14 (Non, Sciences, ABien) → Admis, alors que la classe réelle est Non admis : erreur ; 15 (Non, Maths, TBien) → Admis, juste ; 16 (Non, Maths, Passable) → Non admis, juste. Taux de réussite : 3/4 = 75 %. Si l'on départage la branche ABien par la Série, la ligne 14 est bien classée (100 %), ce qui montre la fragilité d'un arbre appris sur 12 exemples.
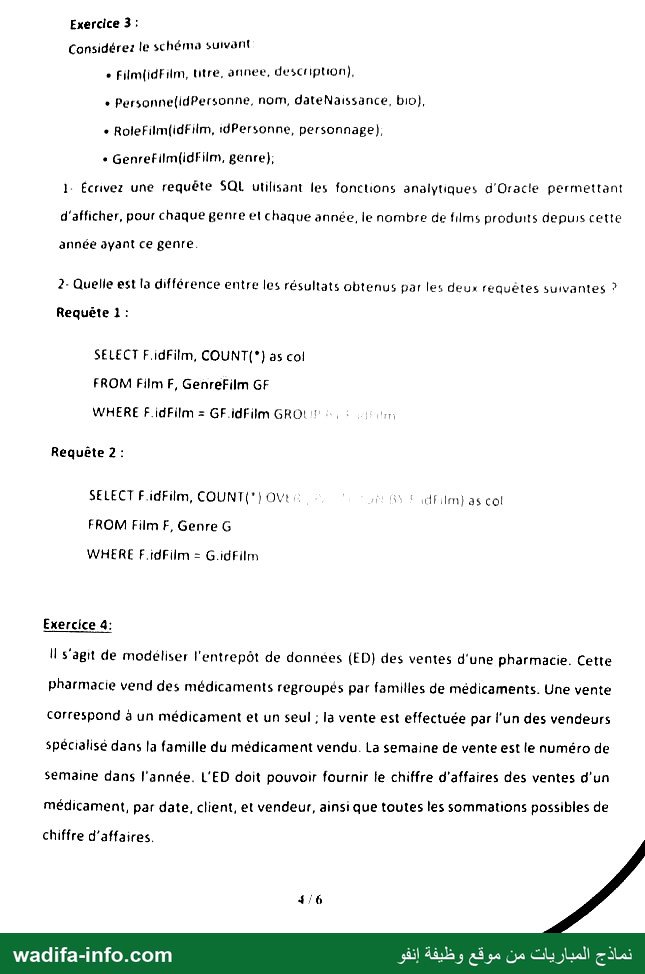
Exercice 3 : SQL analytique (Oracle)
- Requête :
SELECT DISTINCT gf.genre, f.annee,
COUNT(*) OVER (PARTITION BY gf.genre ORDER BY f.annee RANGE BETWEEN CURRENT ROW AND UNBOUNDED FOLLOWING) AS nb_films_depuis
FROM Film f JOIN GenreFilm gf ON f.idFilm = gf.idFilm
ORDER BY gf.genre, f.annee;
La fenêtre compte, pour chaque genre, les films dont l'année est supérieure ou égale à l'année de la ligne. - Différence : la requête 1 (GROUP BY) renvoie une ligne par film avec son nombre de genres. La requête 2 (COUNT(*) OVER (PARTITION BY F.idFilm)) ne regroupe pas : elle renvoie une ligne par couple film-genre, chaque film étant répété autant de fois qu'il a de genres, avec la même valeur col sur chaque ligne. Il faudrait DISTINCT pour retrouver le résultat de la requête 1. La requête 2 nomme la table « Genre G » : c'est GenreFilm.
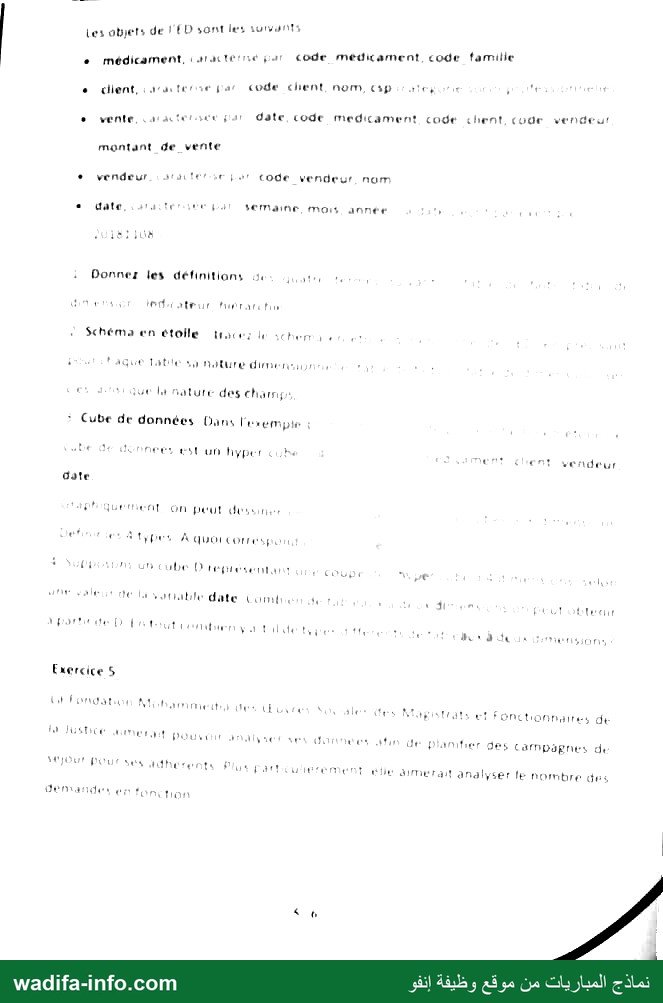
Exercice 4 : entrepôt des ventes d'une pharmacie. Les phrases des questions 3 et 4 sont en partie effacées sur le scan ; on y lit les mots-clés « hypercube », « médicament, client, vendeur, date », « 4 types », « coupe selon une valeur de date », « tableaux à deux dimensions ».
- Définitions : fait : sujet d'analyse, ici la vente ; table de faits : table centrale contenant les clés des dimensions et les mesures (montant_de_vente), au grain d'une vente ; table de dimension : axe d'analyse décrivant le contexte (médicament, client, vendeur, date) ; indicateur (mesure) : valeur numérique additive analysée (chiffre d'affaires) ; hiérarchie : niveaux d'agrégation d'une dimension (semaine → mois → année ; médicament → famille).
- Schéma en étoile : FAIT_VENTE(#code_medicament, #code_client, #code_vendeur, #id_date, montant_de_vente) ; DIM_MEDICAMENT(code_medicament, libellé, code_famille, libellé_famille) ; DIM_CLIENT(code_client, nom, csp) ; DIM_VENDEUR(code_vendeur, nom, code_famille_spécialité) ; DIM_DATE(id_date, jour, semaine, mois, année). Champs # = clés étrangères ; montant = mesure numérique additive ; les autres champs sont des attributs descriptifs.
- Cube de données (réponse probable, énoncé partiellement effacé) : l'hypercube a 4 dimensions (médicament, client, vendeur, date). Graphiquement, on ne dessine que des cubes à 3 dimensions, en fixant ou en agrégeant la 4e : il y a C(4,3) = 4 types de cubes : (médicament, client, vendeur), (médicament, client, date), (médicament, vendeur, date), (client, vendeur, date). Chacun correspond au chiffre d'affaires vu selon trois axes, la quatrième dimension étant fixée (une tranche) ou sommée.
- Cube D (coupe de l'hypercube pour une valeur de date) : il reste 3 dimensions, donc C(3,2) = 3 tableaux à deux dimensions (médicament × client, médicament × vendeur, client × vendeur). Pour l'hypercube complet, il y a C(4,2) = 6 types de tableaux à deux dimensions.
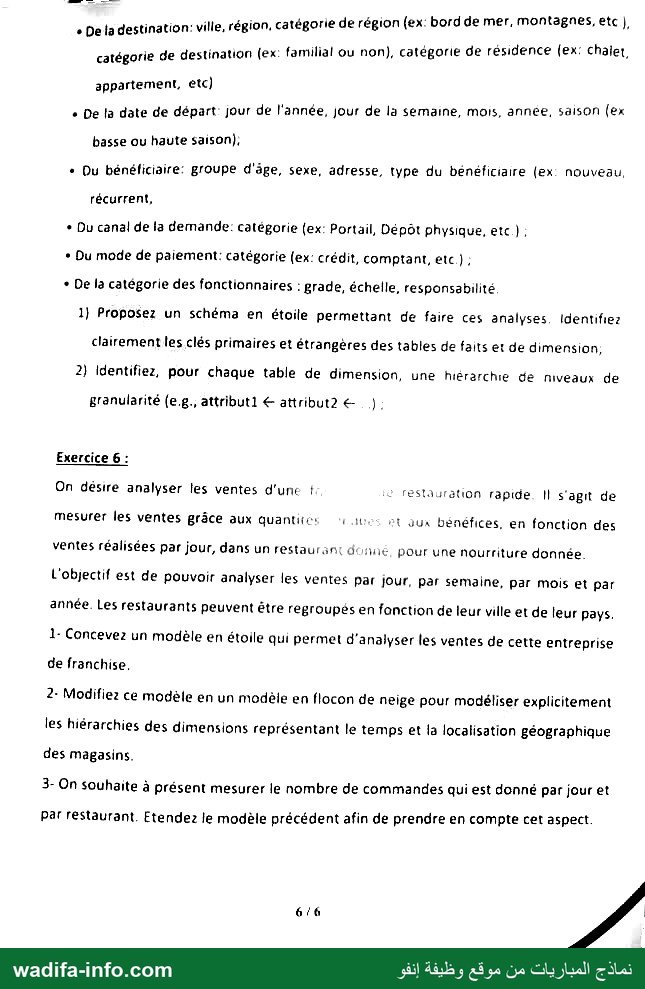
Exercice 5 : demandes de séjour (Fondation Mohammedia des Œuvres Sociales des Magistrats et Fonctionnaires de la Justice)
- Étoile : FAIT_DEMANDE(#id_destination, #id_date_depart, #id_beneficiaire, #id_canal, #id_mode_paiement, #id_categorie, nb_demandes), clé primaire composée des six clés étrangères ; DIM_DESTINATION(id_destination, ville, region, categorie_region, categorie_destination, categorie_residence) ; DIM_DATE(id_date, jour_annee, jour_semaine, mois, saison, annee) ; DIM_BENEFICIAIRE(id_beneficiaire, groupe_age, sexe, adresse, type_beneficiaire) ; DIM_CANAL(id_canal, categorie) ; DIM_PAIEMENT(id_mode_paiement, categorie) ; DIM_CATEGORIE_FONCT(id_categorie, grade, echelle, responsabilite).
- Hiérarchies : Destination : ville ← région ← catégorie de région ; Date : jour ← mois ← saison ← année (et jour ← jour de la semaine) ; Bénéficiaire : bénéficiaire ← groupe d'âge (ou ← type) ; Catégorie : grade ← échelle ; Canal et Paiement : un seul niveau (catégorie).
Exercice 6 : franchise de restauration rapide
- Étoile : FAIT_VENTE(#id_jour, #id_restaurant, #id_produit, quantite, benefice) ; DIM_TEMPS(id_jour, date, semaine, mois, annee) ; DIM_RESTAURANT(id_restaurant, nom, ville, pays) ; DIM_PRODUIT(id_produit, libelle, type_nourriture).
- Flocon : on normalise les hiérarchies : DIM_JOUR(id_jour, date, #id_semaine, #id_mois) → SEMAINE(id_semaine, num, #id_annee) et MOIS(id_mois, mois, #id_annee) → ANNEE(id_annee) ; DIM_RESTAURANT(id_restaurant, nom, #id_ville) → VILLE(id_ville, nom, #id_pays) → PAYS(id_pays, nom).
- Nombre de commandes : son grain est différent (jour × restaurant, sans produit). On ajoute donc une seconde table de faits FAIT_COMMANDE(#id_jour, #id_restaurant, nb_commandes), qui partage les dimensions Temps et Restaurant (dimensions conformes) : on obtient un schéma en constellation. Ne pas mettre nb_commandes dans FAIT_VENTE, où il serait compté plusieurs fois.
Questions fréquentes : Modèle de concours de recrutement des ingénieurs d'État du 1er grade — Conseil Supérieur du Pouvoir Judiciaire 2019 — Informatique décisionnelle
Le sujet du concours « Ingénieur d'État du 1er grade » est-il téléchargeable gratuitement ?
Le corrigé est-il inclus avec le sujet du concours « Ingénieur d'État du 1er grade » ?
Quel organisme et quel grade concerne ce sujet ?
De quelle session s'agit-il et dans quelle langue ?
Où trouver d'autres sujets du même concours ?
📝 Texte des questions (extrait automatiquement des pages scannées)
Ce texte est extrait automatiquement des images de l'épreuve et peut contenir des erreurs de lecture — les images ci-dessus font foi.
ere” نه
مباراة توظيف مهندسي الدولة من الدرجة الأولى
ne الأنظمة التقريرية
. . | المجراة بتاريخ 20 يناير 2019
المادة الثانية: موضوع أو أسئلة ترتبط بالتخصص المطلوب أو
بالمهام والمهارات المهنية المرتبطة بالوظائف المطلوب شغلها.
الهمدة: أربع ساعات )4(
- 0 المعا مل 4
Partie 1:
Donnez l'architecture d’un système d'informatique décsionnel (Bi) .1 :
Qu'est-ce que le « Data Mining » ? .2-
Que signifie le sigle CRISP-DM ? et précisez les six phases du processus CRISP-DM .3
Quelle différence fondamentale existe-t-il entre les méthodes dites supervisees et les .4
méthodes dites non-supervisées ? |
٠ 5. Qu'est-ce qui distingue un modèle de régression d'un modele de discrimination ?
6. Quel est l'intérêt de décomposer l'échantillie de travail on « training data set » et en
“ validation data set » ?
7. Citez deux outils graphiques ner. l& quahte d'un modéle de
discrimination.
8. Expliquez les critères cités ممصمل «à ouse « une collection de données
orientées sujet, intégrées, non volatiles. histori :. Organisees pour le support d'un
processus d'aide à la décision. »
9. Expliquez brièvement les technologies/techniques de TextMining (Le traitement du
langage naturel, Les bases de connaissances, Le Machine Learning) ?
10. Quelles differences entre BI et Big Data ?
11. Donnez 3 différences entre une Base de Données transactionnelle (OLTP) et un
entrepôt de données (OLAP)
12. Expliquez la différence entre les clauses CUBE et ROLLUP.
13. À quoi sert la pré-agrégation des faits et comment peut-on implémenter cette
stratégie dans le contexte des Bases de Données relationnelles ?
D dl je ve i ar rapport au modèl
antages de la modélisation dimensionnelle paf raPP e
14, Nommez deux av :
nalytique :
entités-relations, dans le contexte analyÿtiq meatmmilenats
, érations sut È 2 !
15. Illustrez à l'aide d'un exemple chacune des op
roll-up, et drill-down. à
Partie 2:
Exercice 1:
La sociét ystallée dans la région de Casablanca, désire construire un
entrepôt de données pour suivre l'évolution de ses ventes de chaussures. L'entreprise
spose de deux magasins « Site_Rabat » et « Site_Casa » et vend plusieurs ١
modèles de chaussures.
1. Proposez un modèle conceptuel et logique d’entrepôt de donnet our
observer l'évolution des ventes en termes du nombre total de paires de chaussures
vendues par rapport aux axes MOIS, ANNÉE, MAGASIN et MODÈLE.
2. Soit la représentation relationnelle du dits: ! 05006500 0[ ci-après:
[ - Année | Modèle fAecgsir Nombre |
أ 2015 Botte F Sue | 9000 |
|__2015 Escarpin | Sie _Rabat 1500 |
| 2015 Botte M Site_Casa | 3000 |
|2006 | Escarpin | Site Rabat | 73500 |
2016 Botte | Site Rabat | 2500
| 2016 | Botte Site_Casa 4000 |
Proposez un tableau multidimensionnel pour observer le nombre total de paires de
chaussures vendues par rapport aux axes MAGASIN et MODÈLE.
3. Calculez l'opérateur CUBE sur le data mart MyShoes.ma_01 avec l'approche MOLAP.
4. Calculez l'opérateur CUBE sur le data mart MyShoes.ma_01 avec l'approche ROLAP
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
| Exercice 2 : ,
Le tableau suivant contient des données sur les résultats obtenus par des étudiants de
Tronc Commun (première année à l'Université). Chaque étudiant est décrit par 3
attributs : Est-il doublant ou non, la série du Baccalauréat obtenu et la mention. Les
étudiants sont répartis en deux classes : Admis et Non Admis. On veut construire un
arbre de décision à partir des données du tableau, pour rendre compte des éléments
qui influent sur les résultats des étudiants en Tronc Commun. Les lignes de 1 à 12 sont
utilisées comme données d'apprentissage. Les lignes restantes {de 13 à 16) sont utilisées
comme données de tests.
RE TT pes es
F2= [Non 7] Techniques | Ain | Admis
AT Oui 77 | Sciences | Bien Admis
ET Non Mais Bin | Adms
EST Non 777] Techniques | Bien
[TT Où | Sciences | Pise Non Admis
[BE T Où Ms >. 2] Non Admis
[SET Oui | Technie ٠ : [Non Admis
[107] Oui [Mas 0 5 | Admis
Oui Techniqu: 0_ jfn Admis |
on Saences | Dig Àdmis
[AT N mur |
[132] Qui | Mas Bien | Admis
14] Non Saences _| عه |_Non Admis
[IS] Non Maths TBia Admis
HET Non _ | Maths Passable Non Admis
1. Utilisez les données des lignes de 1 à 12 pour Construire l'arbre en utilisant
l'algorithme 1D3. Montrez toutes les étapes de calcul. Dessinez l'arbre final.
2. Quels sont les résultats de test de l'arbre obtenu sur les données des lignes de 13 à
Re Si) نماذج المباريات من موقع وظيفة
wadifa-info.com #5 جح قع
Exercice 3:
Considérez le schéma suivant
e Film{idFiim, btre, annee, description),
+ PersonnelidPersonne, nom, dateNaissance, bio),
+ RoleFilmlidFilm, 1dPersonne, personnage),
+ GenreFilm(idFilm, genre);
1. Écrivez une requête SQL utilisant les fonctions analytiques d'Oracle permettant
d'afficher, pour chaque genre et chaque année, le nombre de films produits depuis cette
annéé ayant ce genre.
2- Quelle est la différence entre les résultats obtenus par les deux requêtes suivantes ?
Requête 1:
SELECT F.idFilm, COUNT(°) as col
FROM Film F, GenreFilm GF
WHERE F.idFilm = GF.idFilm 66011 0 ni
Requête 2 :
SELECT FidFilm, COUNT('} 7 à dFilm} as col
FROM Film F, Genre G
WHERE F.idFilm = G.idFilm
Exercice 4:
١١ s'agit de modéliser l'entrepôt de données (ED) des ventes d'une pharmacie. Cette
pharmacie vend des médicaments regroupés par familles de médicaments. Une vente
Correspond 4 un médicament et un seul ; la vente est effectuée par l'un des vendeurs
Spécialisé dans la famille du médicament vendu. La semaine de vente est le numéro de
Semaine dans l'année. L'ED doit pouvoir fournir le chiffre d'affaires des ventes d'un
médicament, par date, client, et vendeur, ainsi que toutes les sommations possibles de
chiffre d’affaires.
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
tes نعل جاعريان D sant les aurvunts
*» médicament, saractetneé par code medicament, code famille
° client, مخضا ينب par Code chent, nom, بعتن تت نرق "1"
*« vente, saracteroue pat date, code medicament code تمعبل code vendeur
montant de vente
* vendeur staitet se ju! code vendeur nom
e date. suite CRC Er Semaine, Mois année , ل :
: Donnez les définitions .د 1 8 - D
يط بض اباد كم ا لا
Sehéma en étoile traces le با وض ‘
î taGue latte sy Notre diner, , è
‘ ١١ اا a nature des نفل
: Cube de données On: | trempe ٠
«be de صضاع عمجل hyper يان 5
‘ 67:1 vendeur
dote
tp Quettent on !34و uso
ones A types Aquorcorres por
‘ 01 0 D Cube Oieguesentanx ri Coup: ve à PEUR
ane sales de bi sorti date "0111 “7 . 4 > الم terre
Exercice S
LENS نومركي its à Eure er des Magistratset Fonctionnaires dé
8 نكال nest الل ناا ana et ser düinnues لكل de planter des « arnpäpnes de
MOBuE peut ses Adhérents Plus PAT ieteMmeENt le aimerai analyser fe nombre des
demandes es ton tion
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
+ De وا destination: ville, région, catégorie de région (ex: bord de mer, montagnes, etc ],
catégorie de destination {ex: familial ou non), catégorie de résidence (ex: chaiet,
appartement, etc)
٠ De la date de départ: jour de l'année, jour de la semaine, mois, annee, saison (ex
basse ou haute saison),
+ Du bénéficiaire: groupe d'âge, sexe, adresse, type du bénéficiaire (ex: nouveau,
récurrent,
+ Du canal de la demande: catégorie (ex: Portail, Dépôt physique, etc ) :
* Du mode de paiement: catégorie (ex: crédit, comptant, etc.) :
* De la catégorie des fonctionnaires : grade, échelle, responsabilité.
1} Proposez un schéma en étoile permettant de faire ces analyses. Identifiez
clairement les clés primaires et étrangères des tables de faits et de d imension,
2} Identifiez, pour chaque table de dimension, une hiérarchie de niveaux de
granularité (e.g., attribut1 > attribut2 6
Exercice 6 :
On désire analyser les ventes d'une ١ نا restauration rapide. ١١ s'agit de
mesurer les ventes grâce aux quantités ‘ue 01 ونه bénéfices, en fonction des
ventes réalisées par jour, dans un restaurant donné Pour une nourriture donnée.
L'objectif est de pouvoir analyser les ventes par jour, Par semaine, par mois et par
année. Les restaurants peuvent être regroupés en fonction de leur ville et de leur pays.
1- Concevez un modèle en étoile qui permet d'analyser les ventes de cette entreprise
de franchise.
2. Modifiez ce modèle en un modèle en flocon de neige pour modéliser explicitement
les hiérarchies des dimensions représentant le temps et la localisation géographique
des magasins.
3- On souhaite à présent mesurer le nombre de commandes qui est donné par jour et
Par 1651301301. Etendez le modèle précédent afin de prendre en compte cet aspect.
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
🔗 Citer ce sujet sur votre site, blog ou forum
Copiez ce lien (le PDF reste à jour sur la page) :
Vous préparez ce concours ?
Modèles similaires
Organisme : Conseil Supérieur du Pouvoir Judiciaire · 20/01/2019 — Copie issue de : archive de modèles de concours — document archivé tel que reçu ; l'avis officiel du concours fait foi.
}Citer cette page
Journaliste, blogueur, enseignant : copiez la référence ci-dessous et mettez un lien vers cette page.
Adresse permanente : https://www.wadifa-info.com/fr/modele-concours/3363/modele-de-concours-de-recrutement-des-ingenieurs-d-etat-du-1er-grade-conseil-superieur-d