

Modèle de concours de recrutement — ingénieurs d'État — Caisse Nationale de Sécurité Sociale (CNSS) — Test professionnel — Ingénieur d'État
⬇️ Télécharger le PDF Adresse permanente : wadifa-info.com/fr/modele-concours/2493
En bref
Ce document est une ancienne épreuve écrite du concours de ingénieurs d'État organisé par la Caisse Nationale de Sécurité Sociale (CNSS), publiée sur Wadifa Info en consultation et téléchargement PDF gratuits, avec une correction proposée.
- Organisme
- la Caisse Nationale de Sécurité Sociale (CNSS)
- Grade
- ingénieurs d'État
- Spécialité
- Test professionnel — Ingénieur d'État
- Pages
- 17
- Langue des questions
- français
- Correction
- correction proposée disponible sur cette page
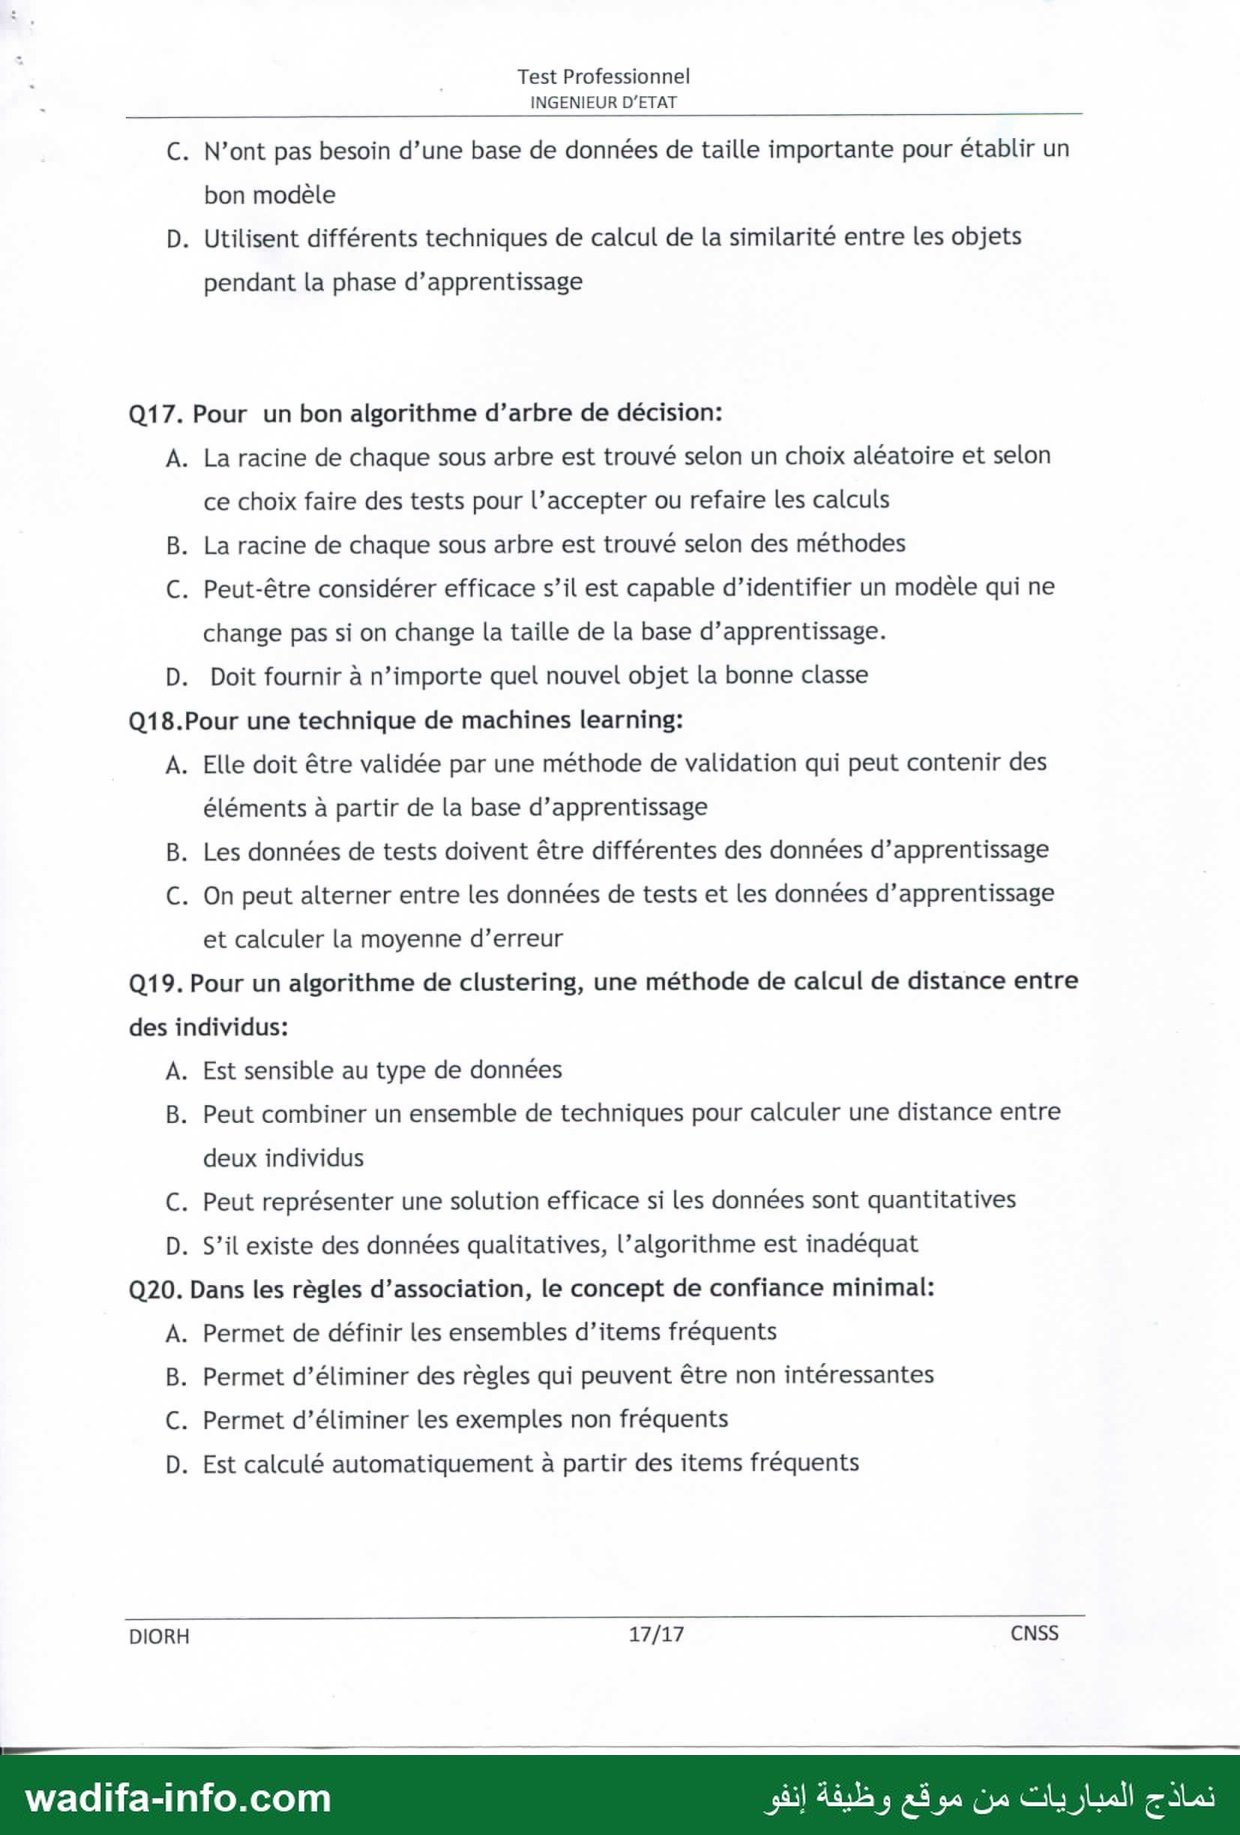
📝 Texte des questions (extrait automatiquement des pages scannées)
Ce texte est extrait automatiquement des images de l'épreuve et peut contenir des erreurs de lecture — les images ci-dessus font foi.
Test Professionnel 1
INGENIEUR D'ETAT
PARTIE COMMUNE
Répondez aux questions suivantes en choisissant la ou les réponse(s) les plus appropriées
Merci de reporter vos réponses sur la grille (partie commune)
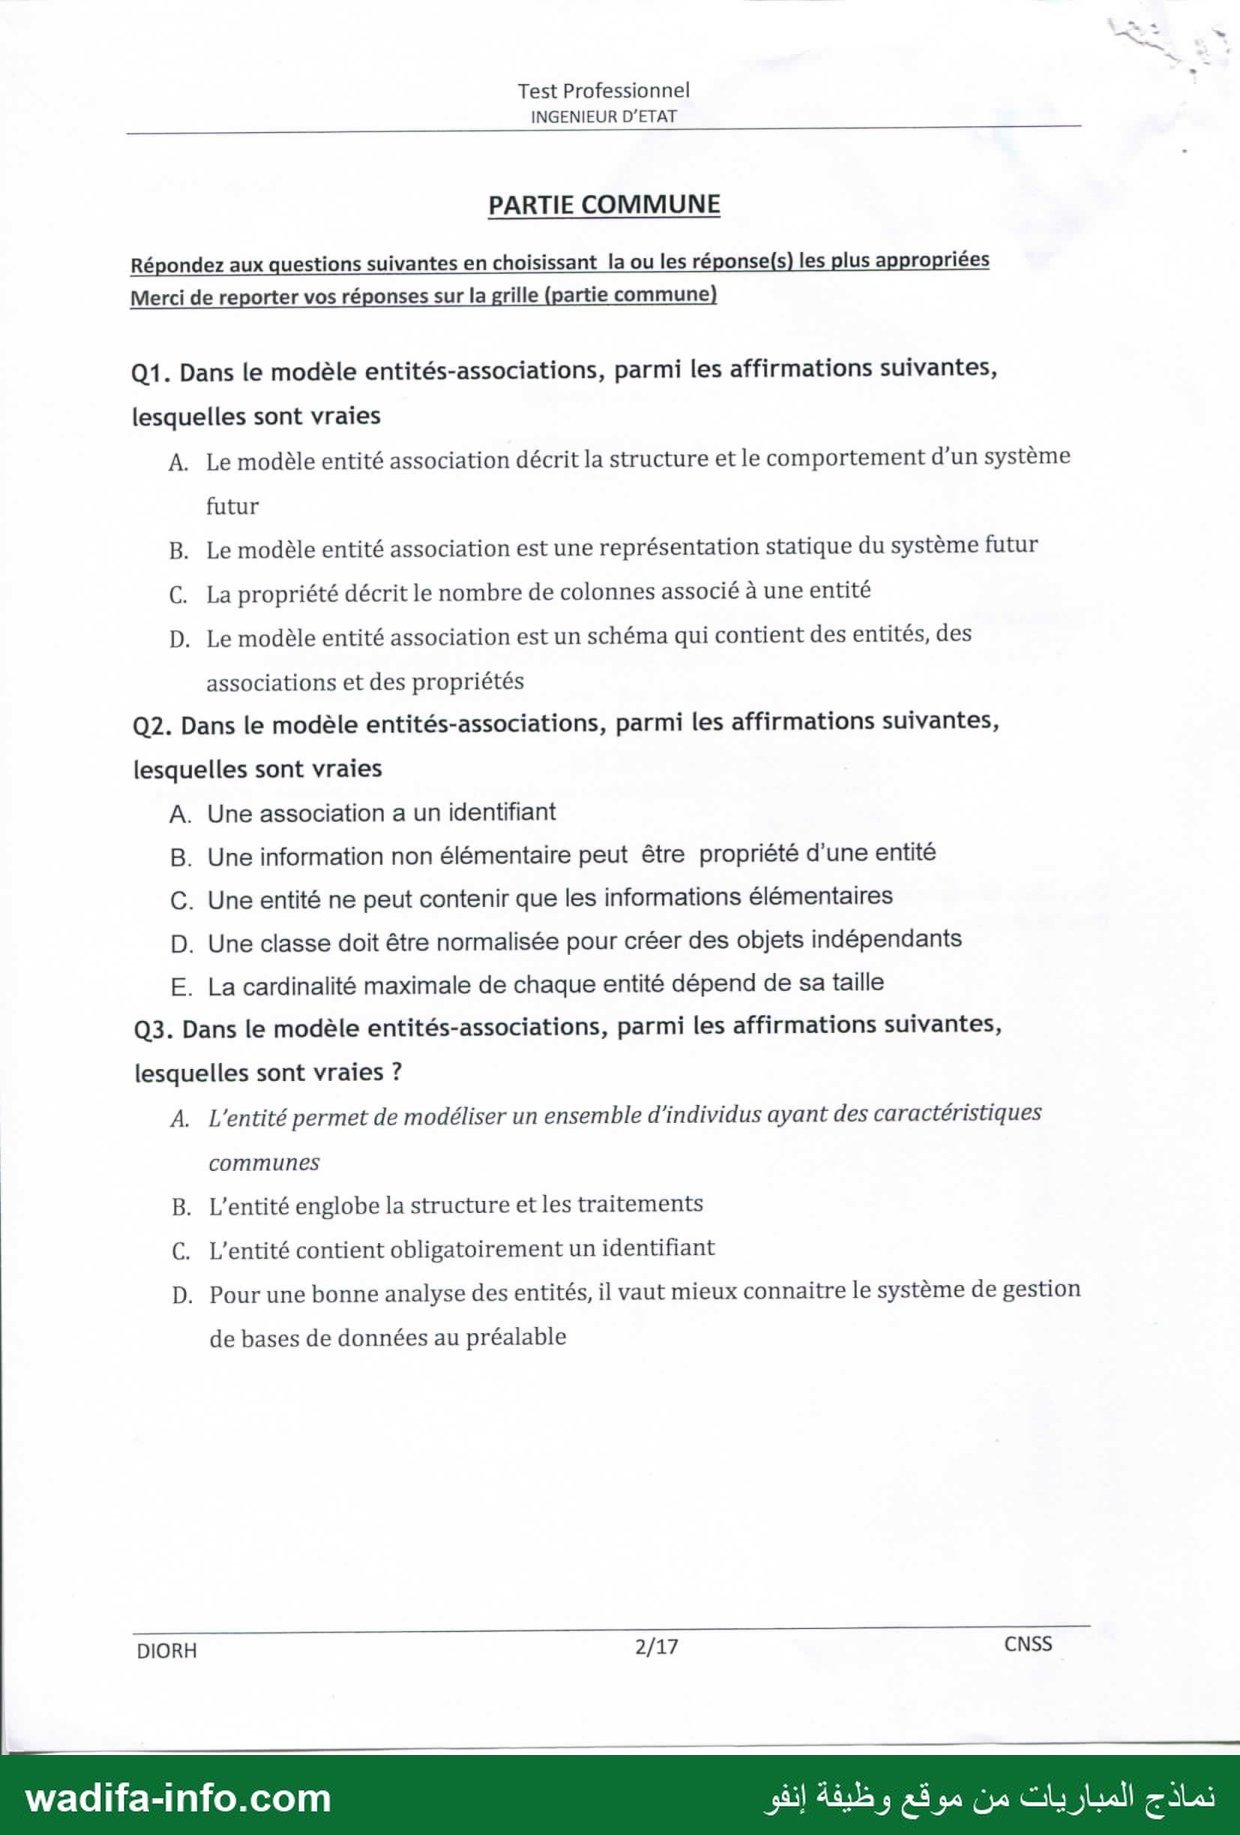
Q1. Dans le modèle entités-associations, parmi les affirmations suivantes,
lesquelles sont vraies
A. Le modèle entité association décrit la structure et le comportement d’un système
futur
B. Le modèle entité association est une représentation statique du système futur
C. La propriété décrit le nombre de colonnes associé à une entité
D. Le modèle entité association est un schéma qui contient des entités, des
associations et des propriétés
Q2. Dans le modèle entités-associations, parmi les affirmations suivantes,
lesquelles sont vraies
A. Une association a un identifiant
B. Une information non élémentaire peut être propriété d'une entité
C. Une entité ne peut contenir que les informations élémentaires
D. Une classe doit être normalisée pour créer des objets indépendants
E. La cardinalité maximale de chaque entité dépend de sa taille
Q3. Dans le modèle entités-associations, parmi les affirmations suivantes,
lesquelles sont vraies ?
A. L'entité permet de modéliser un ensemble d'individus ayant des caractéristiques
communes
B. L'entité englobe la structure et les traitements
C. L'entité contient obligatoirement un identifiant
D. Pour une bonne analyse des entités, il vaut mieux connaitre le système de gestion
de bases de données au préalable
DIORH 2/17 CNSS
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
2 1 Test Professionnel
INGENIEUR D'ETAT
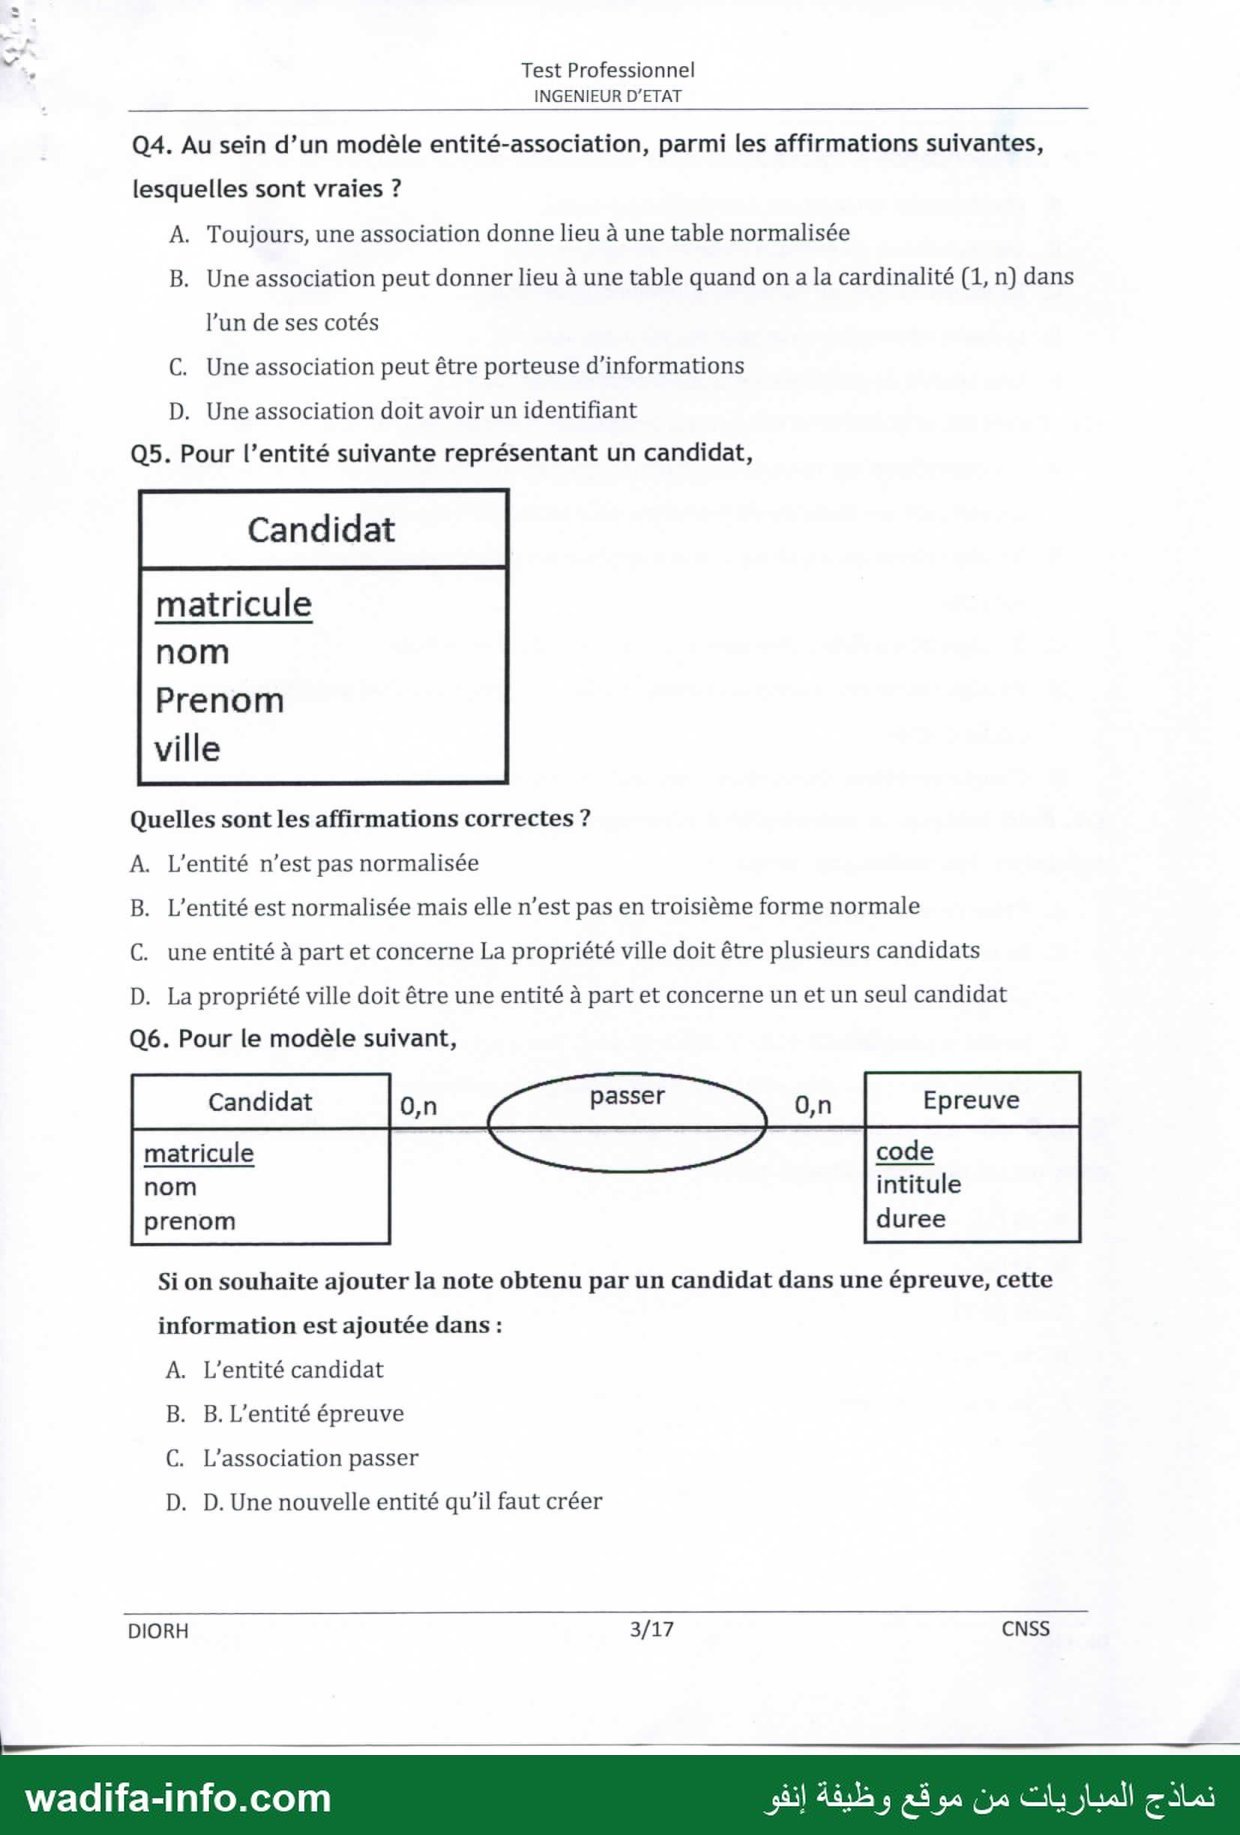
Q4. Au sein d’un modèle entité-association, parmi les affirmations suivantes,
lesquelles sont vraies ?
A. Toujours, une association donne lieu à une table normalisée
B. Une association peut donner lieu à une table quand on a la cardinalité (1, n) dans
l’un de ses cotés
C. Une association peut être porteuse d'informations
D. Une association doit avoir un identifiant
Q5. Pour l’entité suivante représentant un candidat,
matricule
nom
Prenom
ville
Quelles sont les affirmations correctes ?
A. L'entité n’est pas normalisée
B. L'entité est normalisée mais elle n’est pas en troisième forme normale
C. une entité à part et concerne La propriété ville doit être plusieurs candidats
D. La propriété ville doit être une entité à part et concerne un et un seul candidat
Q6. Pour le modèle suivant,
matricule RE صا code
nom intitule
prenom duree
Si on souhaite ajouter la note obtenu par un candidat dans une épreuve, cette
information est ajoutée dans :
A. L’'entité candidat
B. B. L'entité épreuve
C. L'association passer
D. D. Une nouvelle entité qu'il faut créer
©080.. 7 3 -- 9 +. 7 . 090 0-90 - -- - 7
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
Test Professionnel 8
INGENIEUR D'ETAT
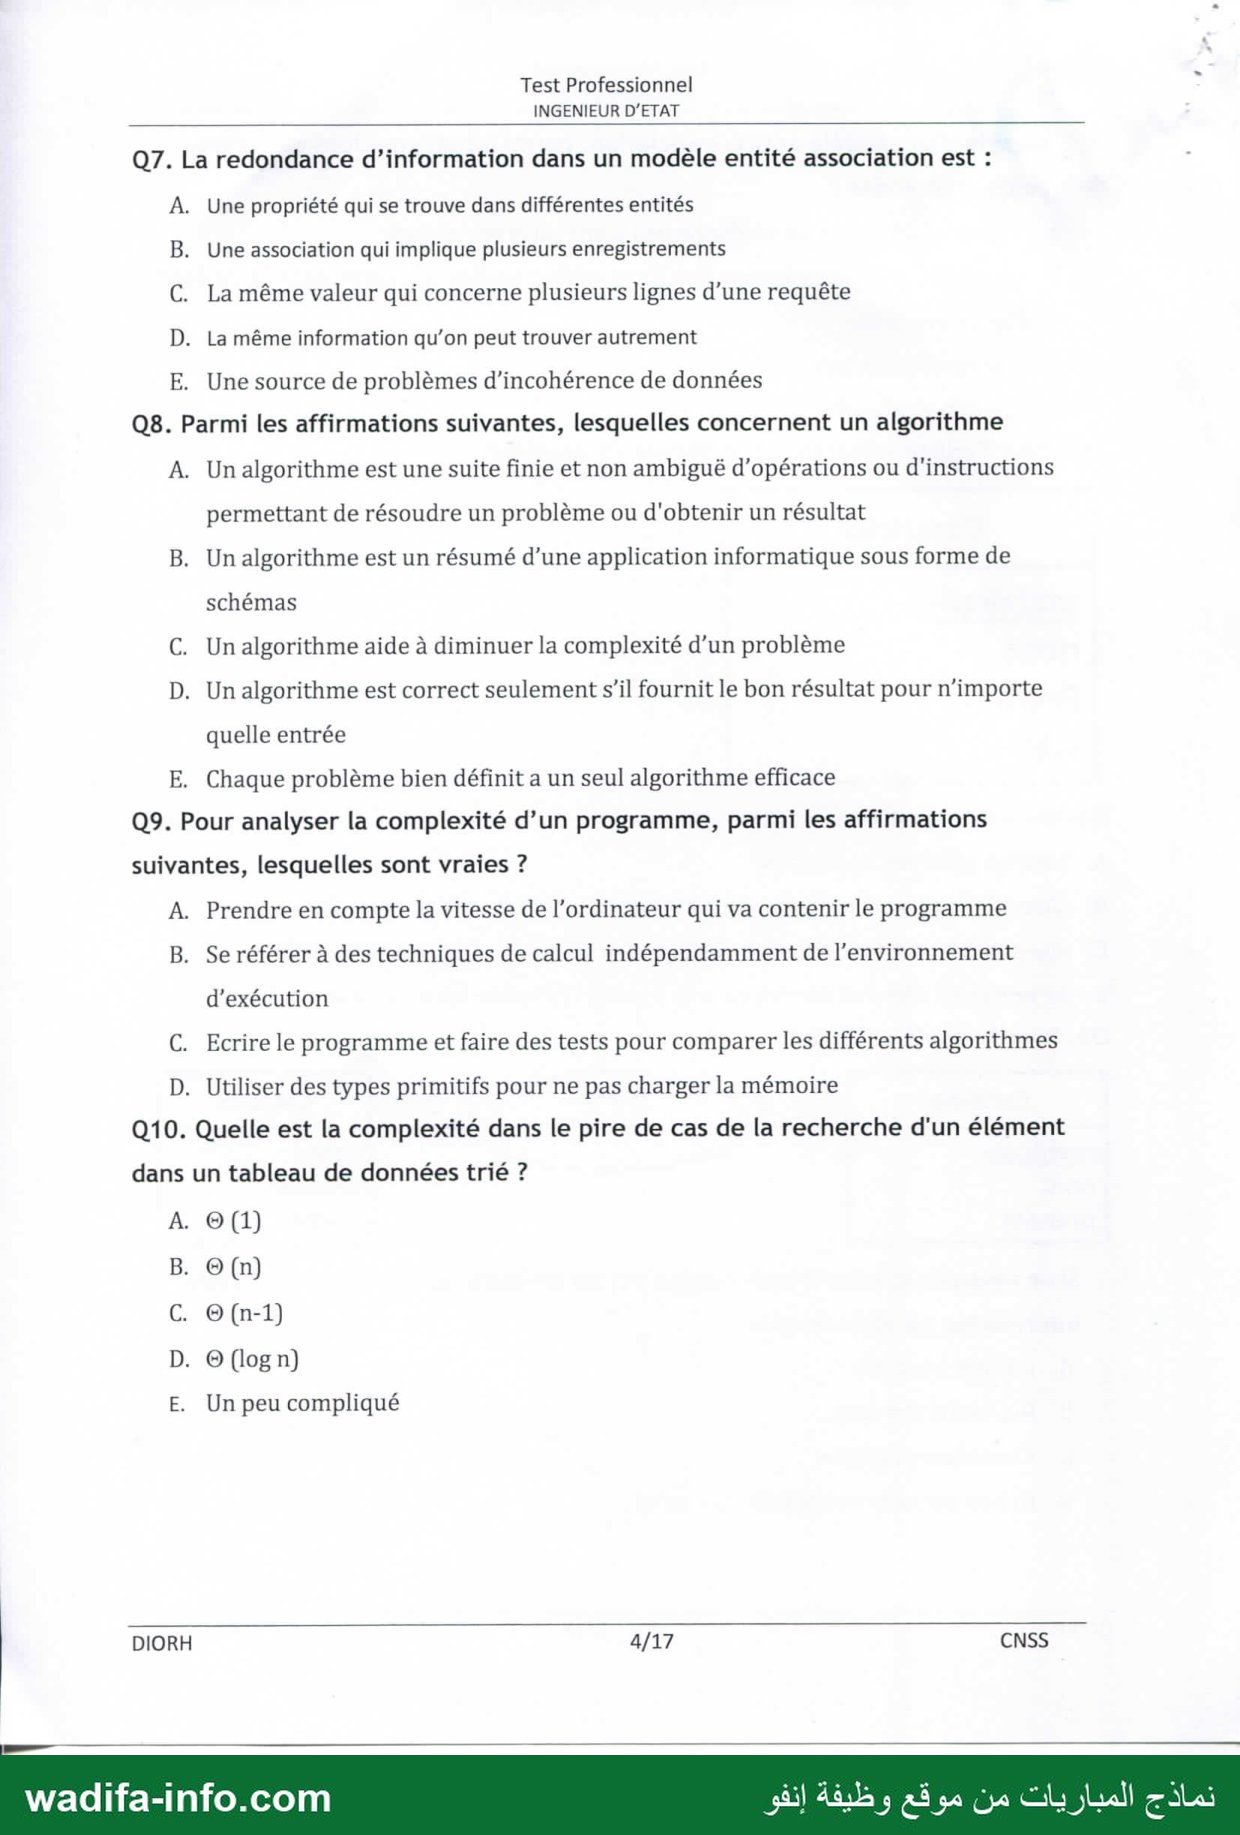
Q7. La redondance d’information dans un modèle entité association est :
A. Une propriété qui se trouve dans différentes entités
B. Une association qui implique plusieurs enregistrements
C. La même valeur qui concerne plusieurs lignes d’une requête
D. La même information qu’on peut trouver autrement
E. Une source de problèmes d’incohérence de données
Q8. Parmi les affirmations suivantes, lesquelles concernent un algorithme
A. Unalgorithme est une suite finie et non ambiguë d'opérations ou d'instructions
permettant de résoudre un problème ou d'obtenir un résultat
B. Un algorithme est un résumé d’une application informatique sous forme de
schémas
C. Un algorithme aide à diminuer la complexité d’un problème
D. Un algorithme est correct seulement s’il fournit le bon résultat pour n'importe
quelle entrée
E. Chaque problème bien définit a un seul algorithme efficace
Q9. Pour analyser la complexité d’un programme, parmi les affirmations
suivantes, lesquelles sont vraies ?
A. Prendre en compte la vitesse de l’ordinateur qui va contenir le programme
B. Se référer à des techniques de calcul indépendamment de l’environnement
d'exécution
C. Ecrire le programme et faire des tests pour comparer les différents algorithmes
D. Utiliser des types primitifs pour ne pas charger la mémoire
Q10. Quelle est la complexité dans le pire de cas de la recherche d'un élément
dans un tableau de données trié ?
C. @(n-1)
D. © (log n)
E. Un peu compliqué
DR Or, ١> OÙ 0
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
٠ Test Professionnel
! INGENIEUR D'ETAT
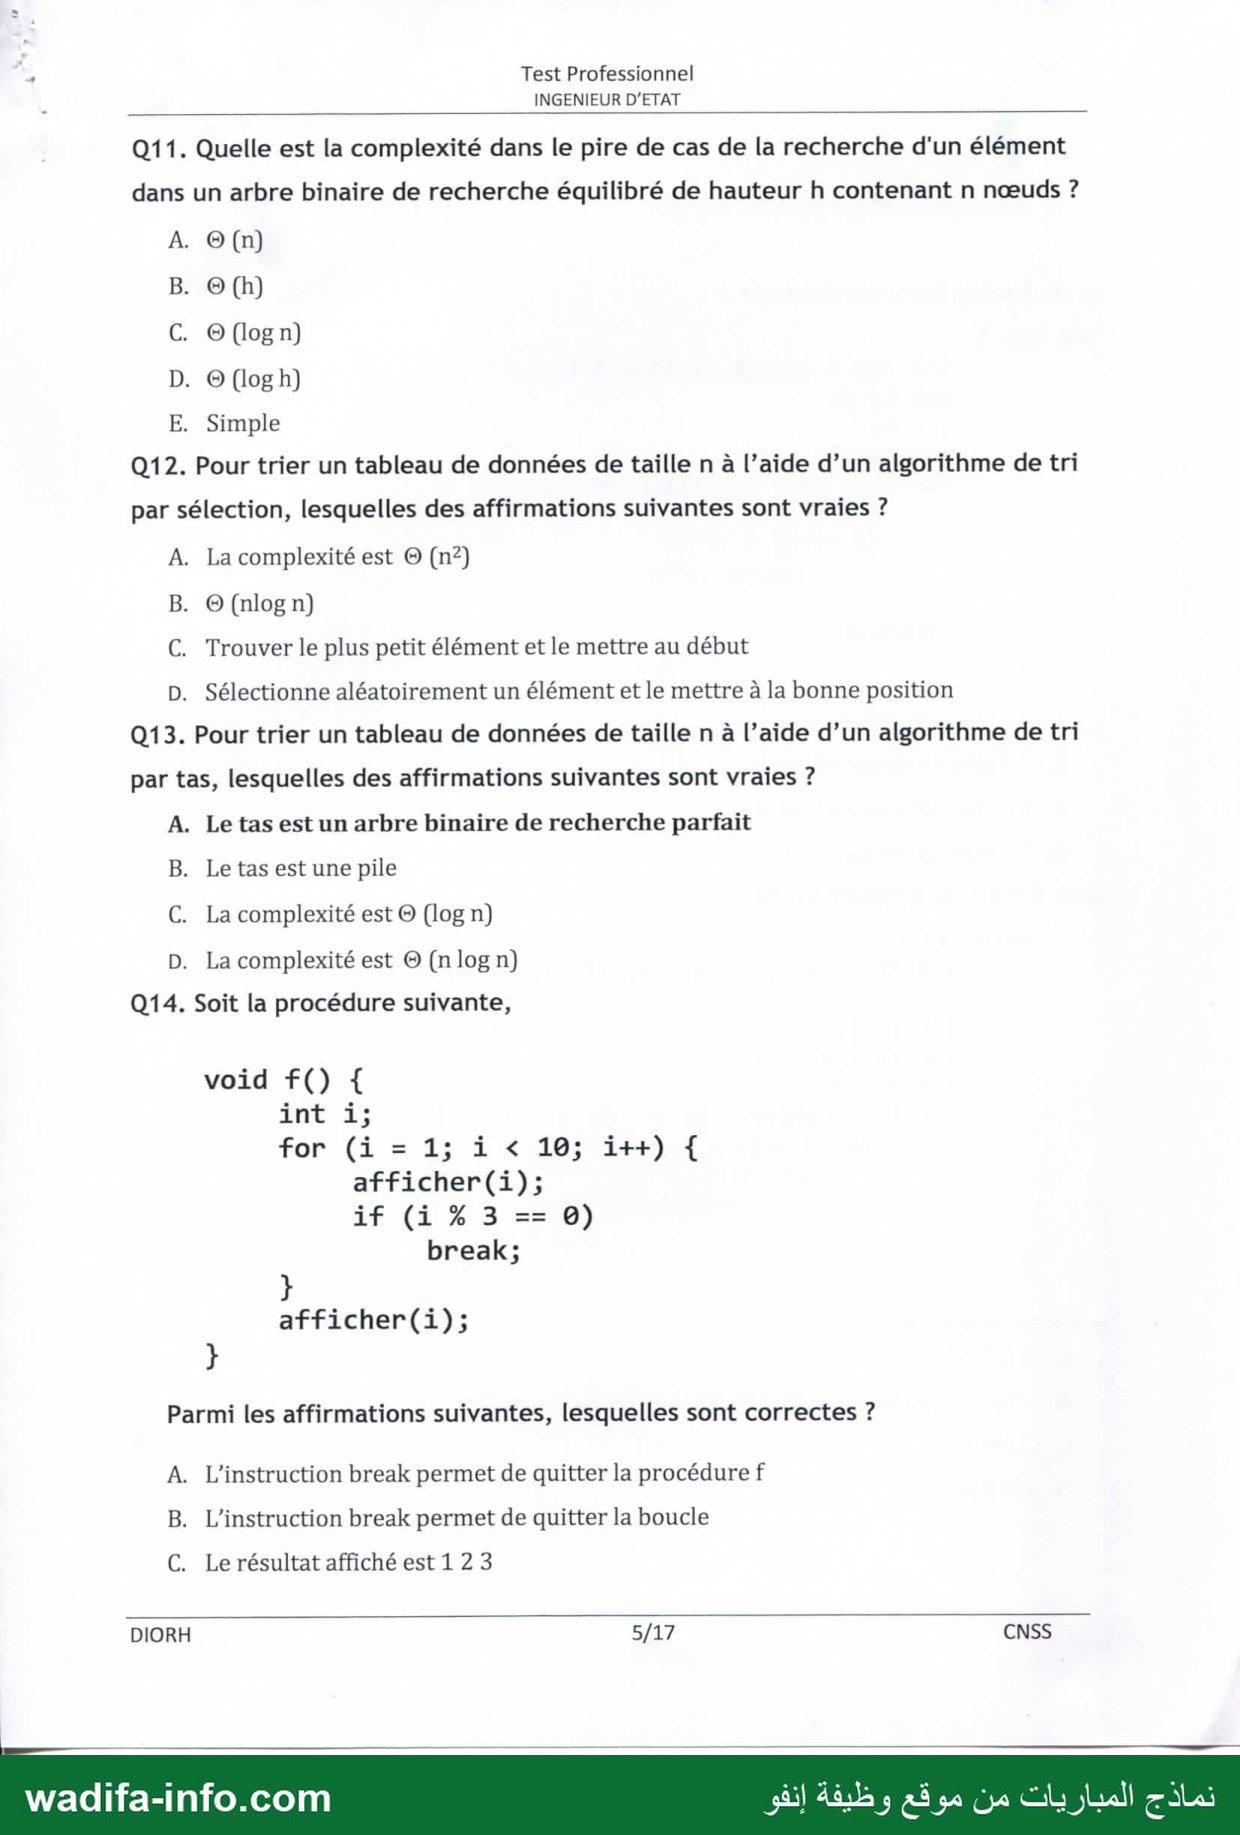
Q11. Quelle est la complexité dans le pire de cas de la recherche d'un élément
dans un arbre binaire de recherche équilibré de hauteur h contenant n nœuds ?
C. © (logn)
D. © (log h)
E. Simple
Q12. Pour trier un tableau de données de taille n à l’aide d’un algorithme de tri
par sélection, lesquelles des affirmations suivantes sont vraies ?
A. La complexité est © (n2)
B. © (nlog n)
C. Trouver le plus petit élément et le mettre au début
D. Sélectionne aléatoirement un élément et le mettre à la bonne position
Q13. Pour trier un tableau de données de taille n à l’aide d’un algorithme de tri
par tas, lesquelles des affirmations suivantes sont vraies ?
A. Le tas est un arbre binaire de recherche parfait
B. Le tas est une pile
C. La complexité est © (log n)
D. La complexité est © (nlogn)
Q14. Soit la procédure suivante,
void f() +
int ji;
for (1 = و1 1 > 105 ire) +
afficher(i);
if (1 4 3 == 0)
break;
afficher(i);
Parmi les affirmations suivantes, lesquelles sont correctes ?
A. L’instruction break permet de quitter la procédure f
B. L’instruction break permet de quitter la boucle
C. Le résultat affiché est 1 2 3
DIORH SZ CNSS
Test Professionnel :
وا ا ا ا اس ا اا حا ا حال ا ا ل
D. Le résultat affiché est 1 2 3 3
E. Le résultat affiché est1233456
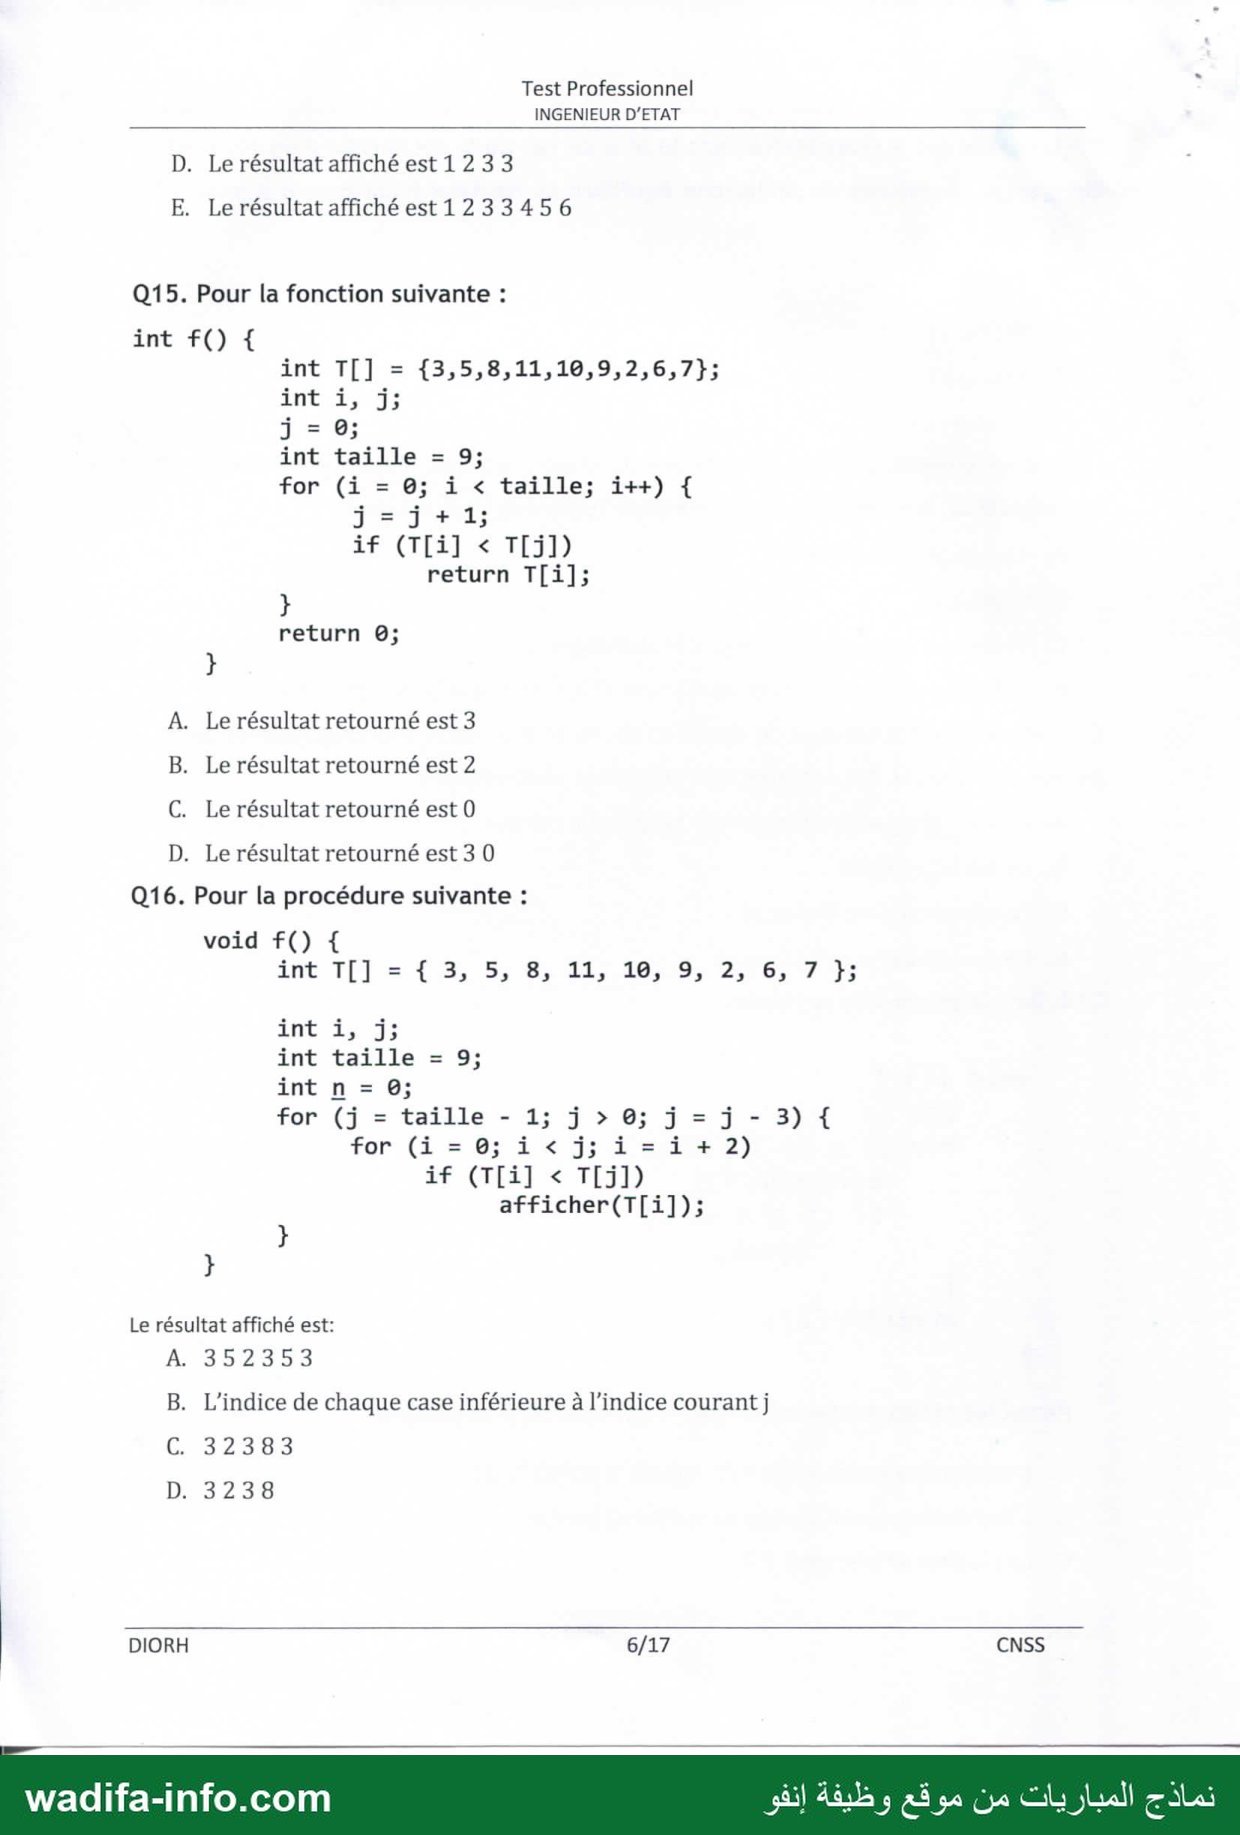
Q15. Pour la fonction suivante :
int f() +
int T[] = {3,5,8,11,10,9,2,6,7};
Ant 1. ول
int taille = 9;
for (i = @; i > taille; i++) {
if (TLi] > 7151)
return T[i];
return ©;
A. Le résultat retourné est 3
B. Le résultat retourné est 2
C. Le résultat retourné est 0
D. Le résultat retourné est 3 0
Q16. Pour la procédure suivante :
void f() +
10+ Ta 4 3. و 7 و6 و2 ,9 ,18 .11 ,8 و5
Int ل .و1
int taille = 9;
int n = 0;
for (1 = taille - و1 À > 0; ل[ = [ - 3) +
for )1 - 90: 1 > و[ 1 < 1 + 2(
1+ (TEST > ](
afficher(T[i]);
Le résultat affiché est:
A: 352353
B. L'indice de chaque case inférieure à l'indice courant j
CE 32383
D: 3238
DIORH 6/17 CNSS
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
Test Professionnel ب
INGENIEUR D'ETAT
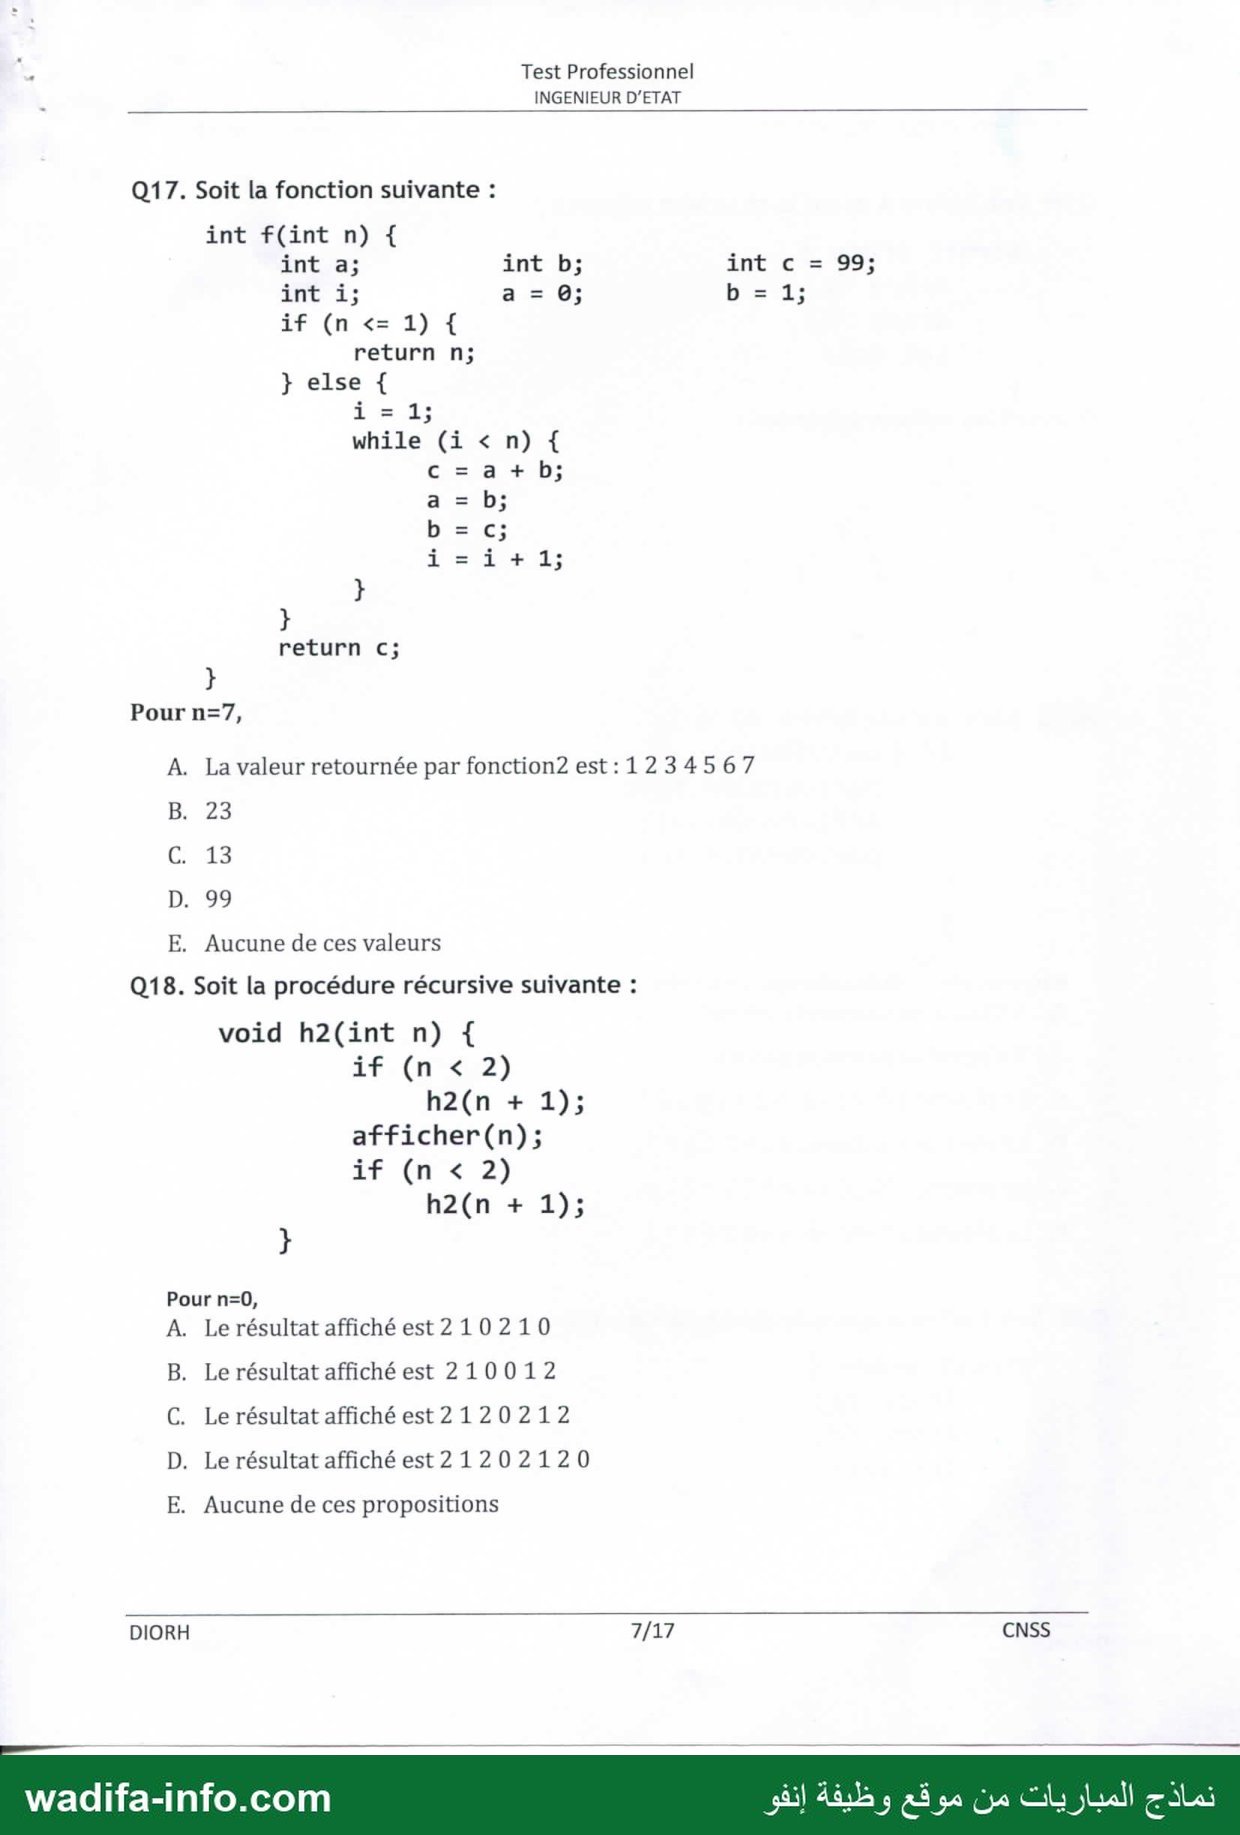
Q17. Soit la fonction suivante :
int f(int n) +
int 3 int b; int © = 99;
int i; a = 0; be 1:
(n <= 1) { +1
return n;
else { }
while (i > n) {
ونا + 8 = C
وا = a
يع = b
و + 1 - 1
return c;
Pour n=7,
A. La valeur retournée par fonction2 est:1234567
B, 23
É. 43
D. 99
E. Aucune de ces valeurs
Q18. Soit la procédure récursive suivante :
void h2(int n) +
if (n < 2)
h2(n + 1);
afficher(n);
if (n < 2)
h2(n + 1);
Pour n=0,
A. Le résultat affiché est 210210
B. Le résultat affiché est 210012
C. Le résultat affiché est 2120212
D. Le résultat affiché est 21202120
E. Aucune de ces propositions
DIORH 7/17 CNSS
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
Test Professionnel :
INGENIEUR D'ETAT
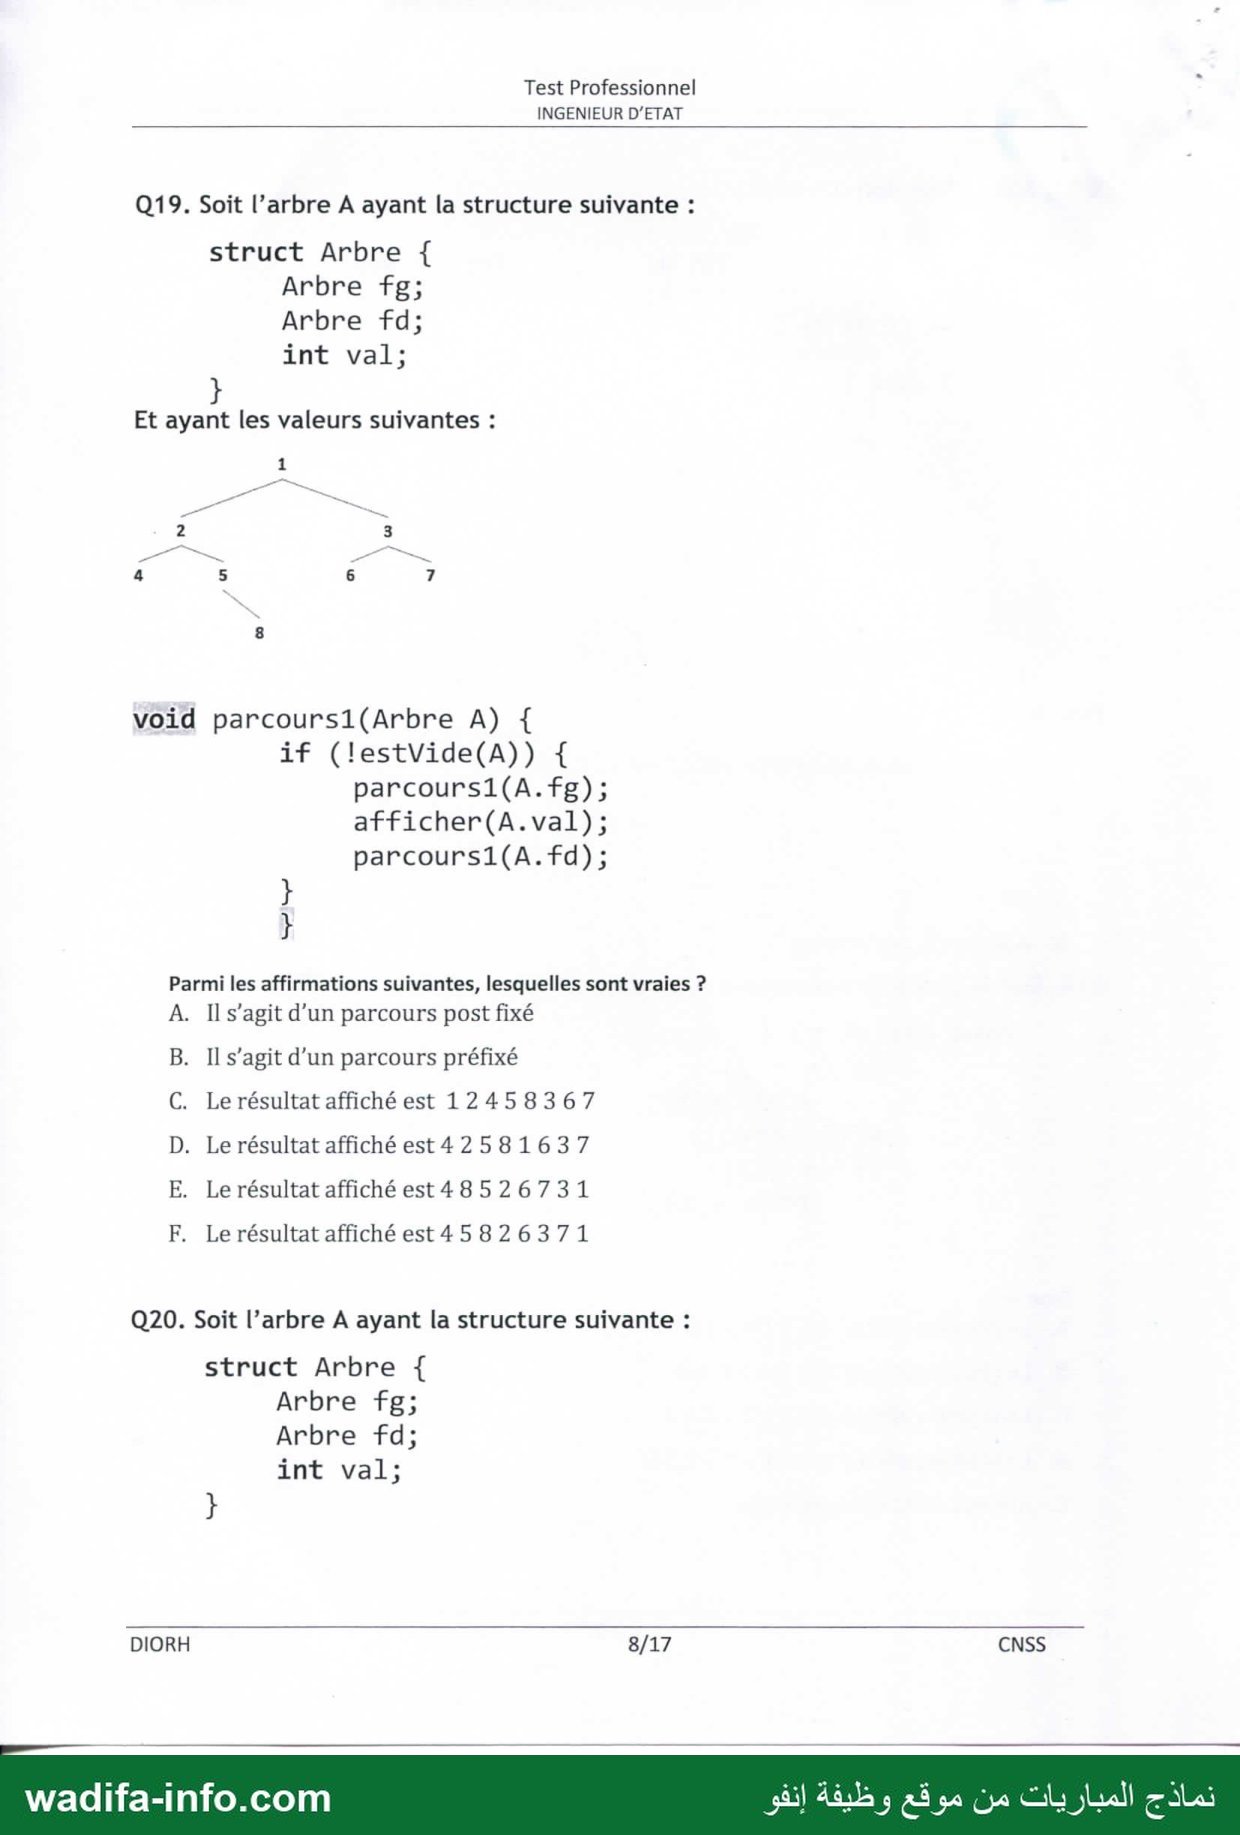
Q19. Soit l’arbre A ayant la structure suivante :
struct Arbre {
Arbre fg;
Arbre fd;
int val;
Et ayant les valeurs suivantes :
rs 5 8 7
void parcours1(Arbre A) +
if (lestVide(A)) {
parcours1(A.fg);
afficher(A.val);
parcours1(A.fd);
Parmi les affirmations suivantes, lesquelles sont vraies ?
A. Il s’agit d'un parcours post fixé
B. Il s’agit d'un parcours préfixé
C. Le résultat affiché est 12458367
D. Le résultat affiché est42581637
E. Le résultat affiché est48526731
F. Le résultat affiché est45 826371
Q20. Soit l’arbre A ayant la structure suivante :
struct Arbre {
Arbre fg;
Arbre fd;
int val;
DIORH 8/17 CNSS
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
‘ Test Professionnel
1 INGENIEUR D'ETAT
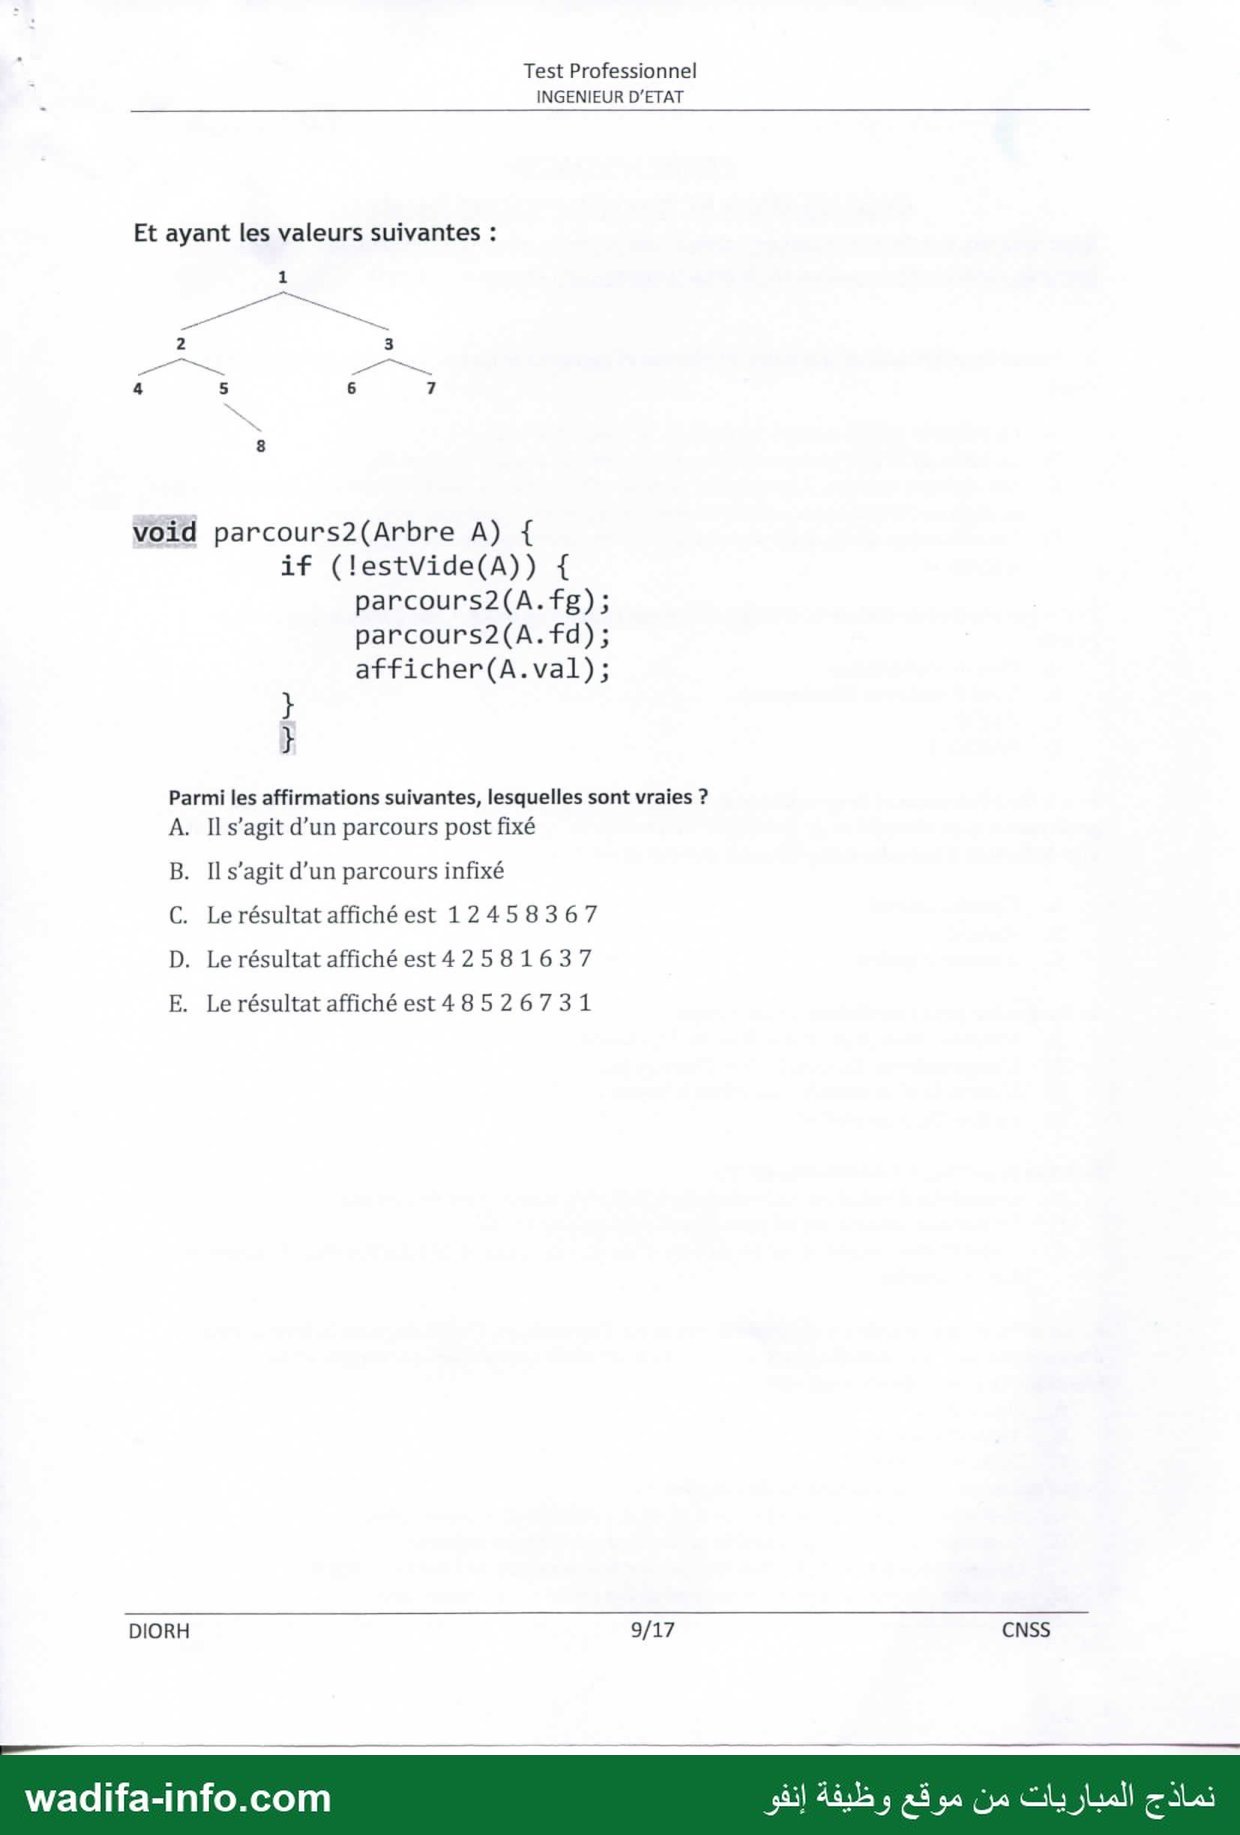
Et ayant les valeurs suivantes :
4 5 8 7
void parcours2(Arbre A) {
if (lestVide(A)) +
parcours2(A.fg);
parcours2(A.fd);
afficher(A.val);
Parmi les affirmations suivantes, lesquelles sont vraies ?
A. Il s’agit d’un parcours post fixé
B. Il s’agit d'un parcours infixé
C. Le résultat affiché est 12458367
D. Le résultat affiché est42581637
E. Le résultat affiché est48526731
DIORH 9/17 CNSS
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
Test Professionnel
INGENIEUR D'ETAT
PARTIE SPECIALITE
ORGANISATION ET QUALITE PROCESS (au choix
Répondez aux questions suivantes en choisissant la ou les réponse(s) les plus appropriées
Merci de reporter vos réponses sur la grille (Organisation et qualité process)
1 - Parmi les affirmations suivantes, choisissez et entourez le numéro de celle qui vous semble
vraie :
A. La méthode SMED permet de diminuer le nombre de réglages
B. La méthode SMED permet de diminuer la durée du réglage des machines
C. Les réglages externes (qui peuvent se faire sans arrêter la machine) doivent être transformés
en réglages internes (qui peuvent se faire uniquement en arrêtant la machine)
D. L'amélioration du transport des outillages et des pièces permet de diminuer les temps d'arrêt de
la machine.
2- Ce qui permet de définir la criticité et classer la priorité des actions à mener pour éviter
l'arrêt.
A. Plan de maintenance
B. Total Productive Maintenance
C. AMDEC
D. PARETO
3— « L'établissement et la spécification des critères de coût de la qualité et des niveaux de
performance, de sécurité et de fiabilité d’un produit devant donner satisfaction au client » est
une définition à laquelle s’applique les notions suivantes ?
A. Contrôle qualité
B. Qualité
C. Assurance qualité.
4- La qualité peut être définie comme étant :
A. L'amélioration de la productivité de l’entreprise,
B. L'augmentation des bénéfices de l’entreprise,
C. -L’aptitude d’un produit à satisfaire le besoin
D. La fiabilité d’un produit.
5- selon la norme, l’autocontrôle est-il :
A. Le contrôle délégué par une entreprise cliente à une entreprise fournisseur,
B. Le contrôle effectué par un opérateur sur son propre travail,
C. L'état dûment repéré d’un produit ou d’un service quant à la situation dans l’exécution du
plan de contrôle.
6- La définition suivante : « Aptitude à retrouver l'historique, l’utilisation ou la localisation
d’un article ou d’une activité, ou d’articles ou d’activités semblables, au moyen d’une
identification enregistrée » est celle :
A. Du contrôle
B. De la traçabilité
C. De la vérification
7- Qu'est-ce que la production en flux tendus ?
A. on établit des plans de production à partir des prévisions commerciales
B._ on établit des plans de production en fonction des besoins exprimés
©. on établit des plans de production à partir des contraintes de l’environnement
D. on établit des plans de production à partir des choix de la concurrence
اسم ااال
DIORH 10/17 CNSS
wadifa-I TR 3 اا ل
ifa-info.com نماذج المباريات من موقع وظيفة إنفو
: Test Professionnel
INGENIEUR D'ETAT
8- La qualité des produits / services de l’entreprise est la responsabilité
A. du département marketing
B. du département de la production
C. de tous les départements de l’entreprise
9- Un indicateur qualité :
A. Est un élément mesurable permettant de surveiller la production.
B. Permet de s’assurer de l’atteinte des objectifs.
C. Est un membre du personnel, non connu, chargé de rapporter tout défaut à la direction.
D. Doit être communiqué régulièrement à l’ensemble du personnel.
10- Pour repérer le plus rapidement possible les défauts de fabrication il faut :
A. Effectuer des contrôles techniques
B. Recenser les motifs d'insatisfaction des clients
C. Effectuer des contrôles finaux.
D. Faire une étude de marché.
11 - Les certificats de l'AFAQ indiquent que:
A. Les produits de l'entreprise sont de qualité supérieure.
B. L'entreprise respecte les règles de fabrication et de contrôle définis par la norme.
C. L'entreprise respecte les règles de sécurité européenne définis par la norme.
D. L'entreprise fabrique les meilleurs produits de ce type.
12- Le manuel qualité est-il l'expression
A. Du chef d’entreprise
B. Du responsable qualité
C De l’ensemble des acteurs de l’entreprise
13- La finalité d'un 5110 est de :
A. Réduire les coûts
B. Respecter les délais.
C. Accroître la satisfaction des clients internes.
D. Accroître la satisfaction des clients externes.
14- La norme ISO 9001 pour un système de management de la qualité définit:
A. Les exigences.
B. Les lignes directrices pour l’audit qualité et environnement
C. Les principes essentiels.
D. Les exigences dans l’industrie automobile
15- Les cartes de contrôle servent à :
A. Surveiller l’évolution du processus de la production avant son lancement
B. Surveiller l’évolution du processus de la production après son lancement
C. Surveiller l’évolution du processus de la production au cours de son exécution
D. Surveiller l’évolution du processus de la production avant et après son lancement
16- Quelle est la définition de l’assurance qualité
A. ensemble approprié de dispositions préétablies et systématiques destinées à donner confiance
en l’obtention de la qualité requise,
B. C’est un accord entre donneur d’ordre et fournisseur sur le planning de livraison, la quantité et
la qualité des pièces à livrer.
DIORH 11/17 CNSS
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
Test Professionnel ٍ
INGENIEUR D'ETAT
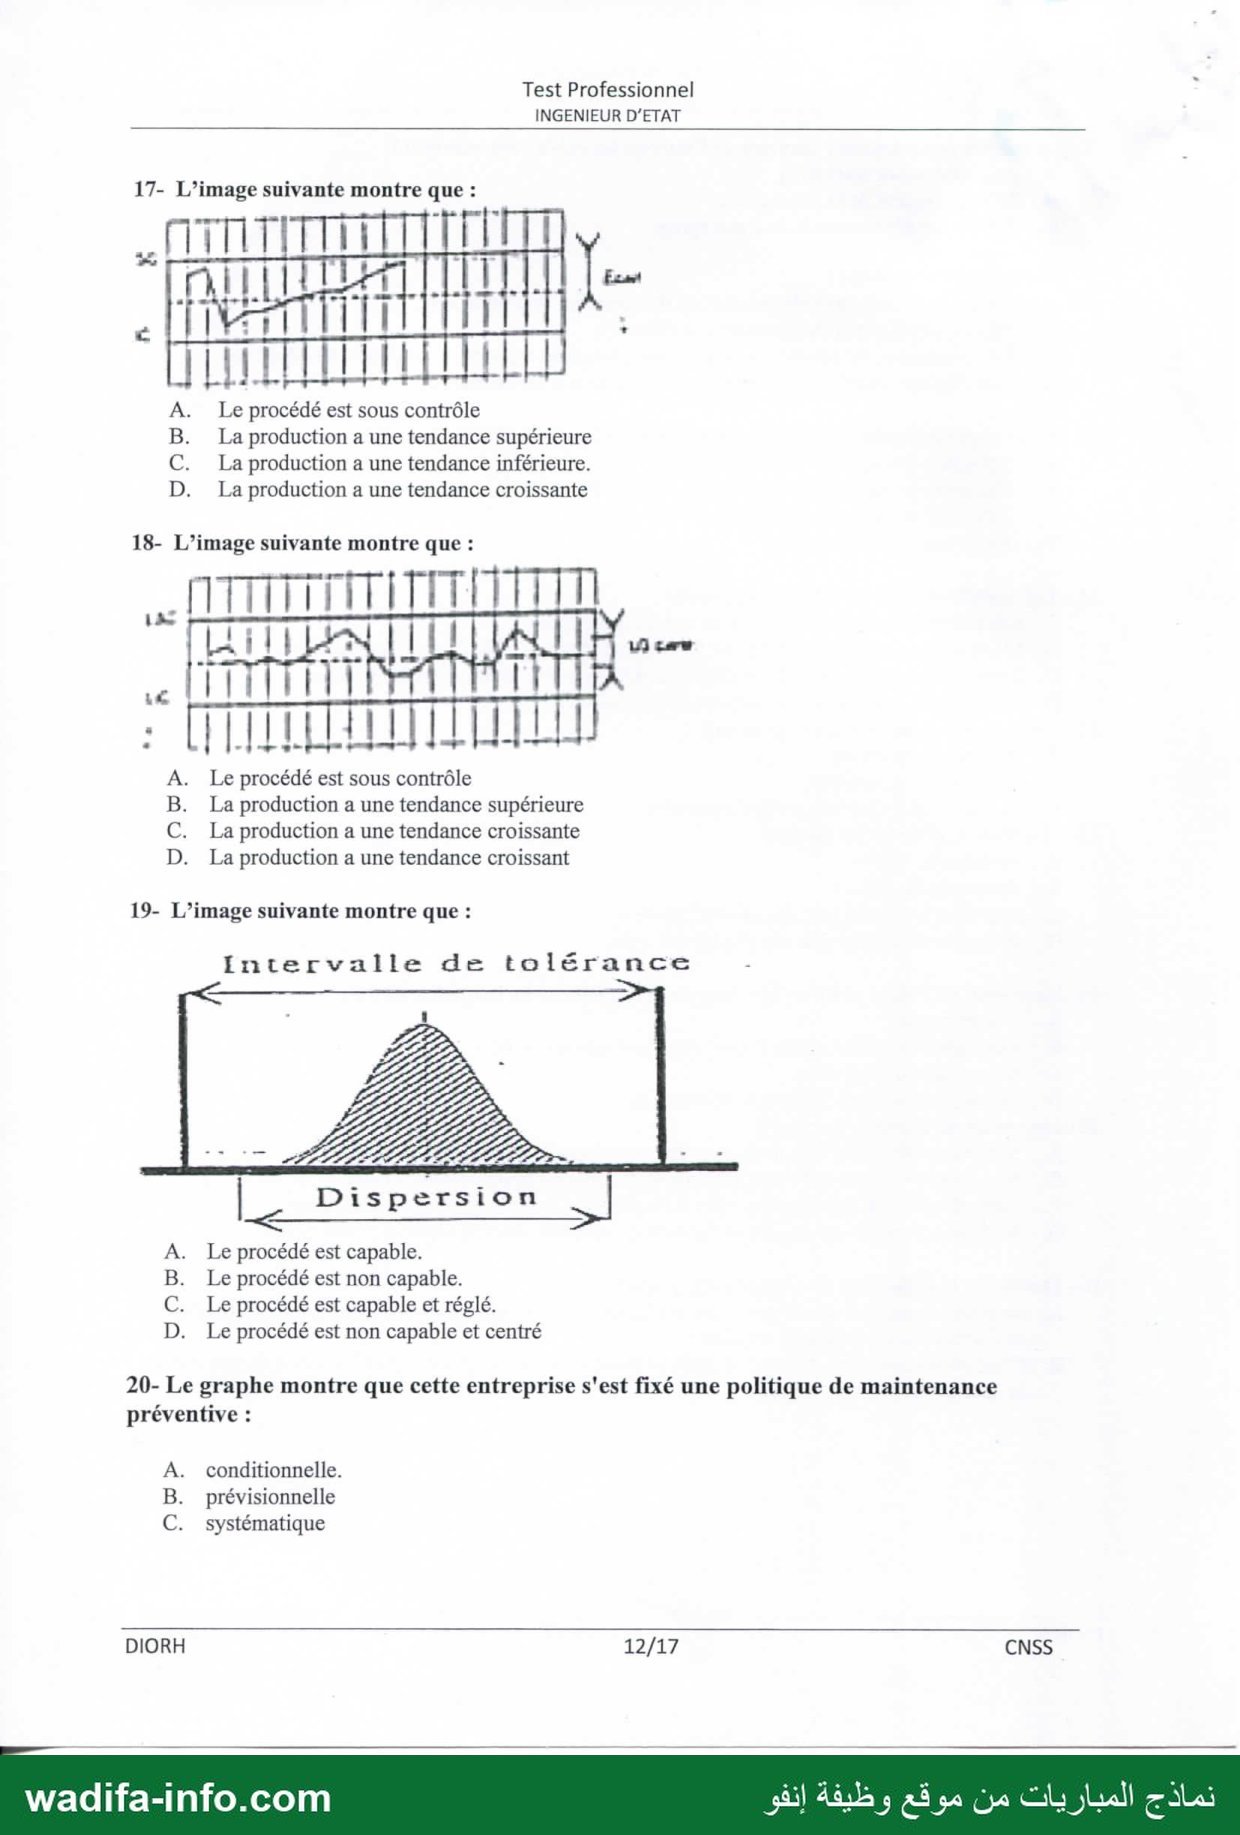
17- L’image suivante montre que :
17711!
ANTOINE Je
TNT
THIN
LR où عد mn on on
A. Le procédé est sous contrôle
B. La production a une tendance supérieure
C. La production a une tendance inférieure.
D. La production a une tendance croissante
18- L’image suivante montre que :
ATTTTOTIN
1111011
: (HAN
A. Le procédé est sous contrôle
B. La production a une tendance supérieure
C. La production a une tendance croissante
D. La production a une tendance croissant
19- L’image suivante montre que :
Intervalle de tolérance x
| Dispersion ل
A. Le procédé est capable.
B. Le procédé est non capable.
C. Le procédé est capable et réglé.
D. Le procédé est non capable et centré
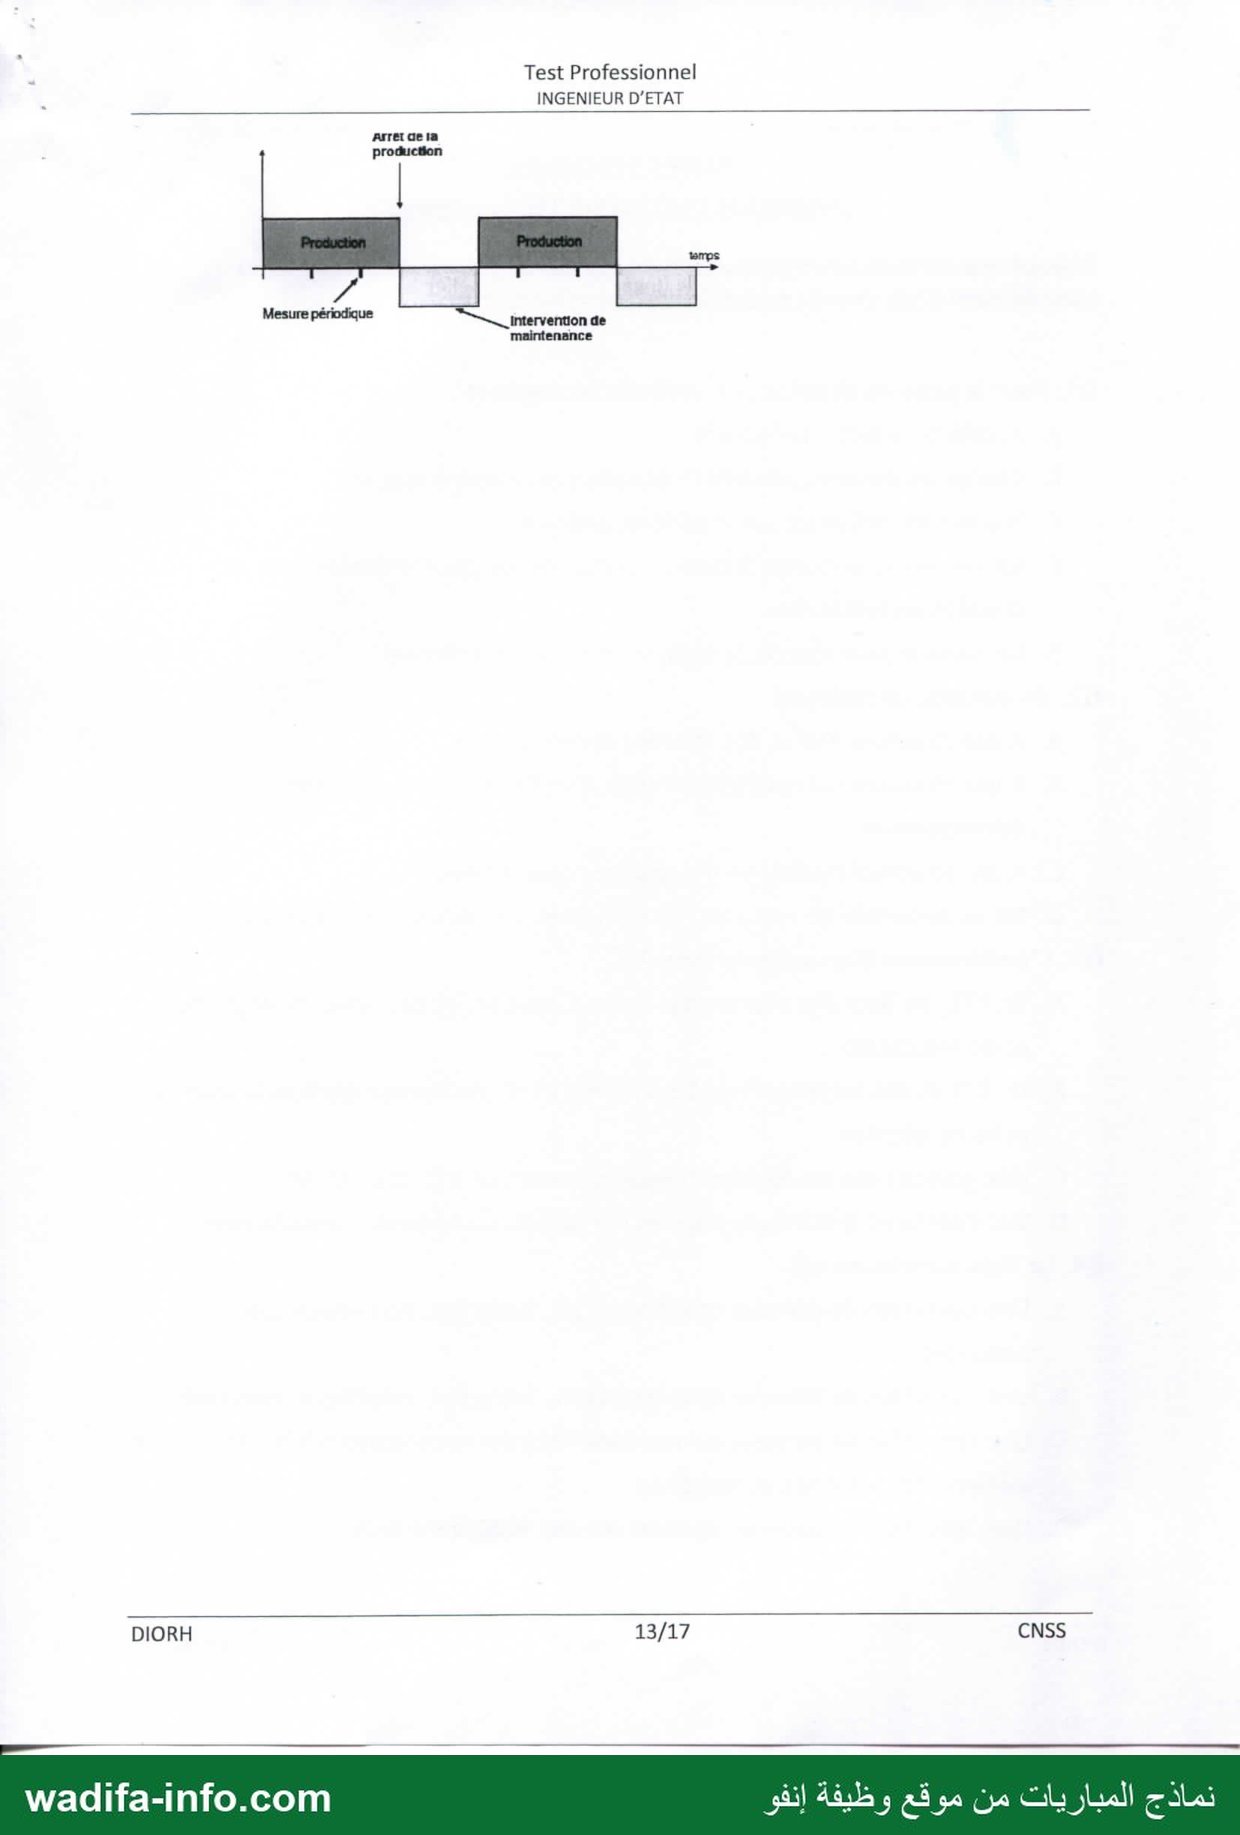
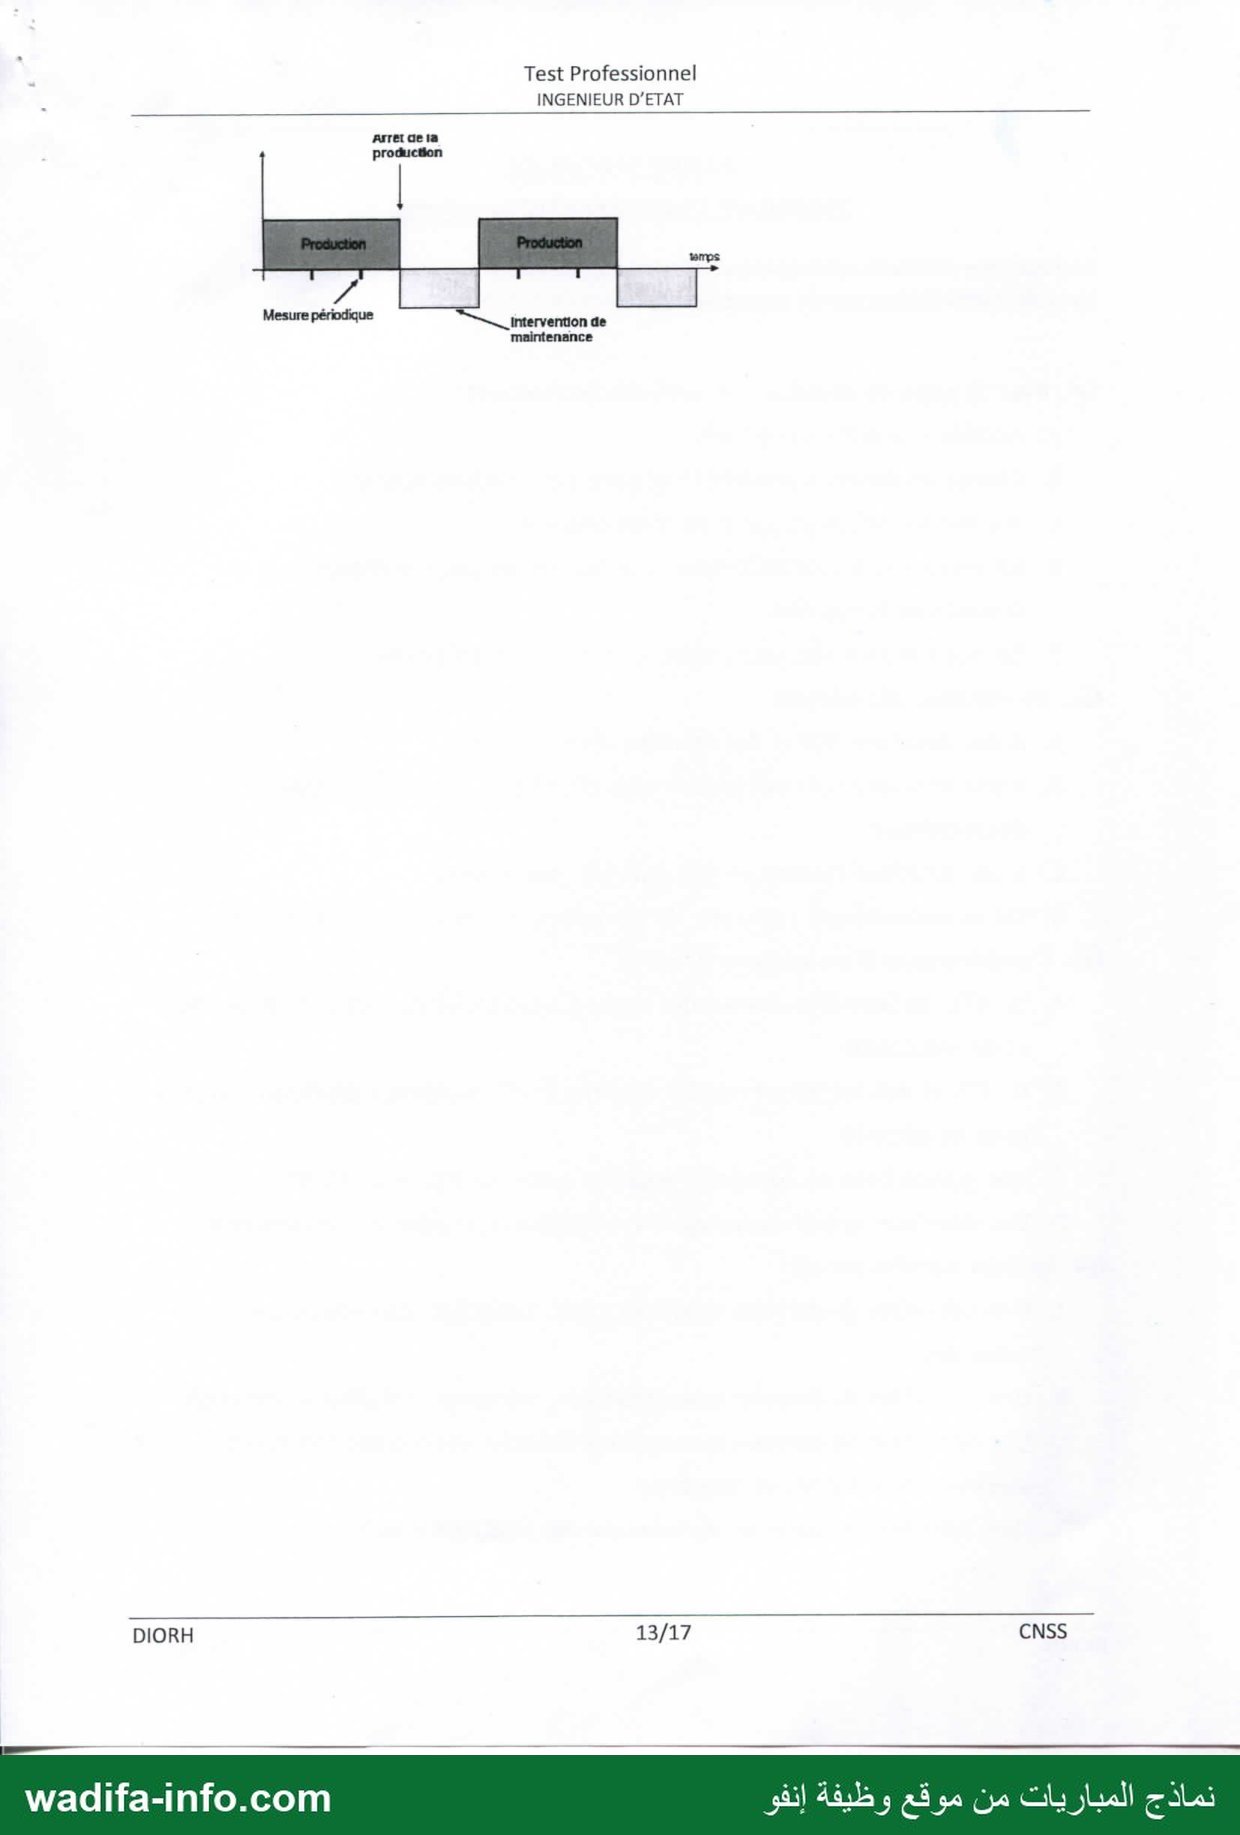
20- Le graphe montre que cette entreprise s'est fixé une politique de maintenance
préventive :
A. conditionnelle.
B. prévisionnelle
C. systématique
DIORH 12/17 CNSS
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
(١ Test Professionnel
: INGENIEUR D'ETAT
Menus périodique Intervention de
maintenance
DIORH 13/17 CNSS
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
: Test Professionnel
. INGENIEUR D'ETAT
wrps
Mesure périodique Intervention de
maintenance
DIORH 13/17 CNSS
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
Test Professionnel
PARTIE SPECIALITE
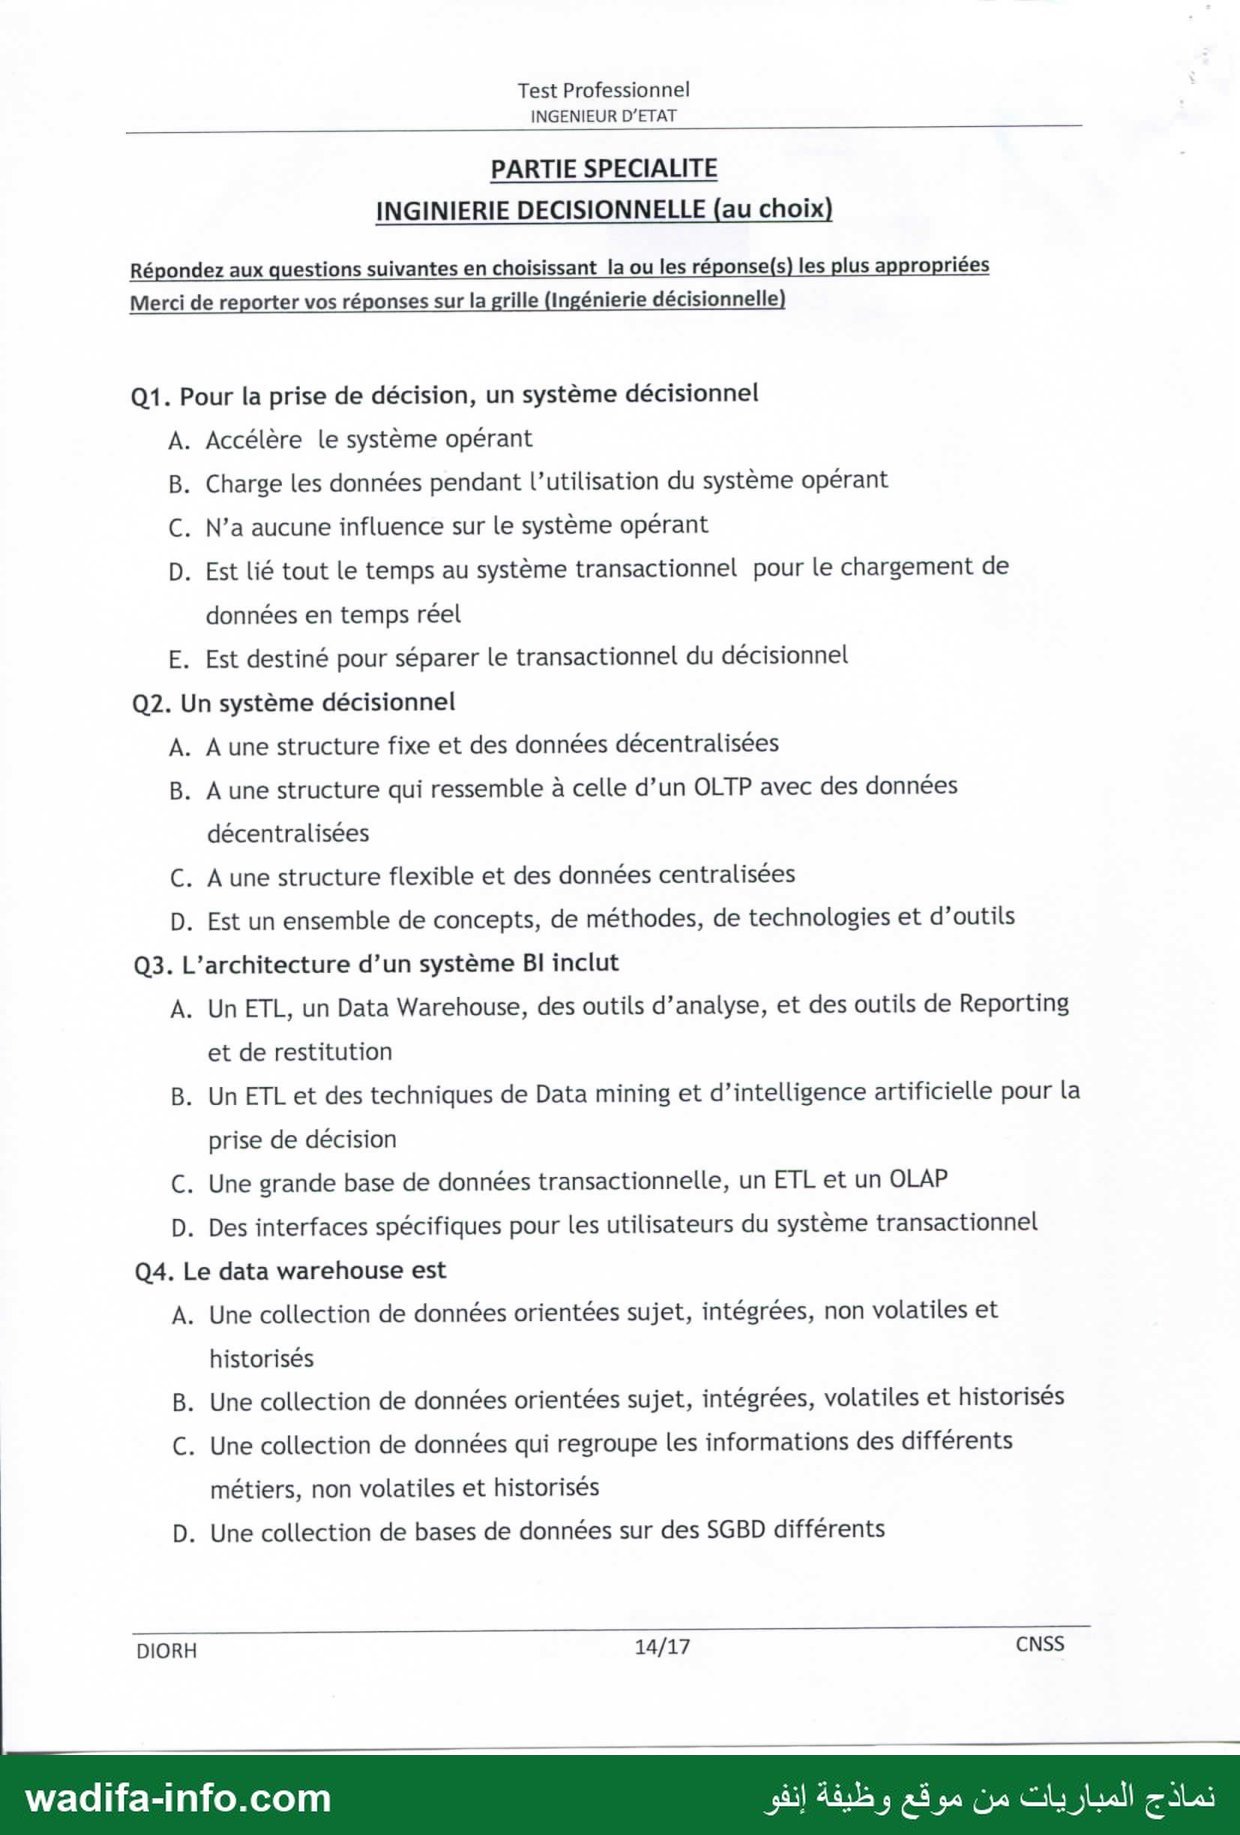
INGINIERIE DECISIONNELLE (au choix)
Répondez aux questions suivantes en choisissant la ou les réponse(s) les plus appropriées
Merci de reporter vos réponses sur la grille (Ingénierie décisionnelle)
Q1. Pour la prise de décision, un système décisionnel
A. Accélère le système opérant
B. Charge Les données pendant l’utilisation du système opérant
C. N’a aucune influence sur Le système opérant
D. Est lié tout عا temps au système transactionnel pour Le chargement de
données en temps réel
E. Est destiné pour séparer Le transactionnel du décisionnel
Q2. Un système décisionnel
A. À une structure fixe et des données décentralisées
B. À une structure qui ressemble à celle d’un OLTP avec des données
décentralisées
C. A une structure flexible et des données centralisées
D. Est un ensemble de concepts, de méthodes, de technologies et d’outils
Q3. L'architecture d’un système BI inclut
A. Un مااع un Data Warehouse, des outils d'analyse, et des outils de Reporting
et de restitution
B. Un ETL et des techniques de Data mining et d'intelligence artificielle pour la
prise de décision
C. Une grande base de données transactionnelle, un ETL et un OLAP
D. Des interfaces spécifiques pour Les utilisateurs du système transactionnel
Q4. Le data warehouse est
A. Une collection de données orientées sujet, intégrées, non volatiles et
historisés
B. Une collection de données orientées sujet, intégrées, volatiles et historisés
C. Une collection de données qui regroupe les informations des différents
| métiers, non volatiles et historisés
D. Une collection de bases de données sur des SGBD différents
D A NS
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
ً Test Professionnel
TT — ا ب اقا تلا للاففثار يي — ——. _._
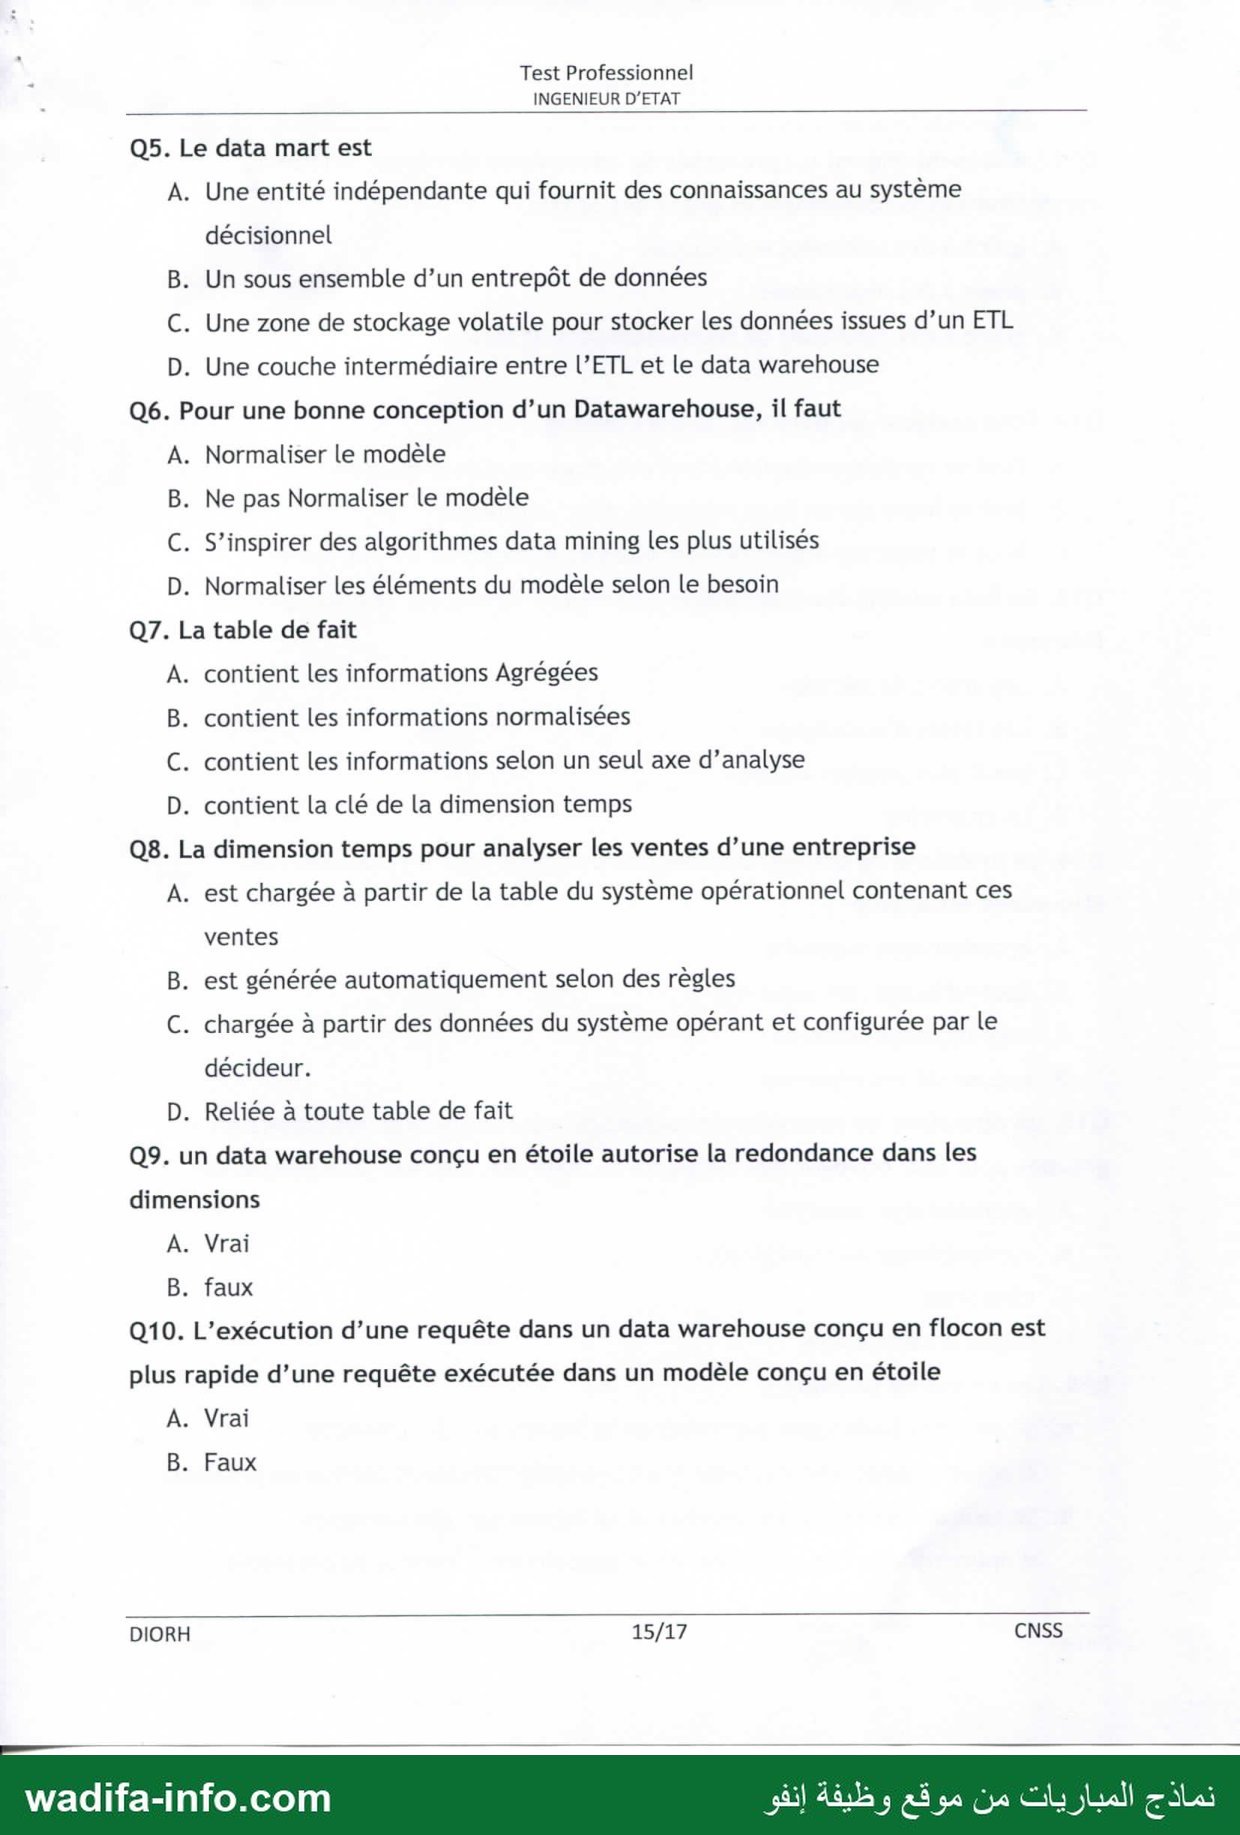
Q5. Le data mart est
A. Une entité indépendante qui fournit des connaissances au système
décisionnel
B. Un sous ensemble d’un entrepôt de données
C. Une zone de stockage volatile pour stocker les données issues d’un ETL
D. Une couche intermédiaire entre l’ETL et le data warehouse
Q6. Pour une bonne conception d’un Datawarehouse, il faut
A. Normaliser le modèle
8. Ne pas Normaliser le modèle
C. S’inspirer des algorithmes data mining Les plus utilisés
D. Normaliser Les éléments du modèle selon le besoin
Q7. La table de fait
A. contient les informations Agrégées
B. contient Les informations normalisées
C. contient les informations selon un seul axe d’analyse
D. contient la clé de قا dimension temps
Q8. La dimension temps pour analyser les ventes d’une entreprise
A. est chargée à partir de la table du système opérationnel contenant ces
ventes
B. est générée automatiquement selon des règles
C. chargée à partir des données du système opérant et configurée par Le
décideur.
D. Reliée à toute table de fait
Q9. un data warehouse conçu en étoile autorise la redondance dans les
dimensions
À. Vrai
B. faux
Q10. L’exécution d’une requête dans un data warehouse conçu en flocon est
plus rapide d’une requête exécutée dans un modèle conçu en étoile
A. Vrai
B. Faux
PE PE |
Test Professionnel
INGENIEUR D'ETAT
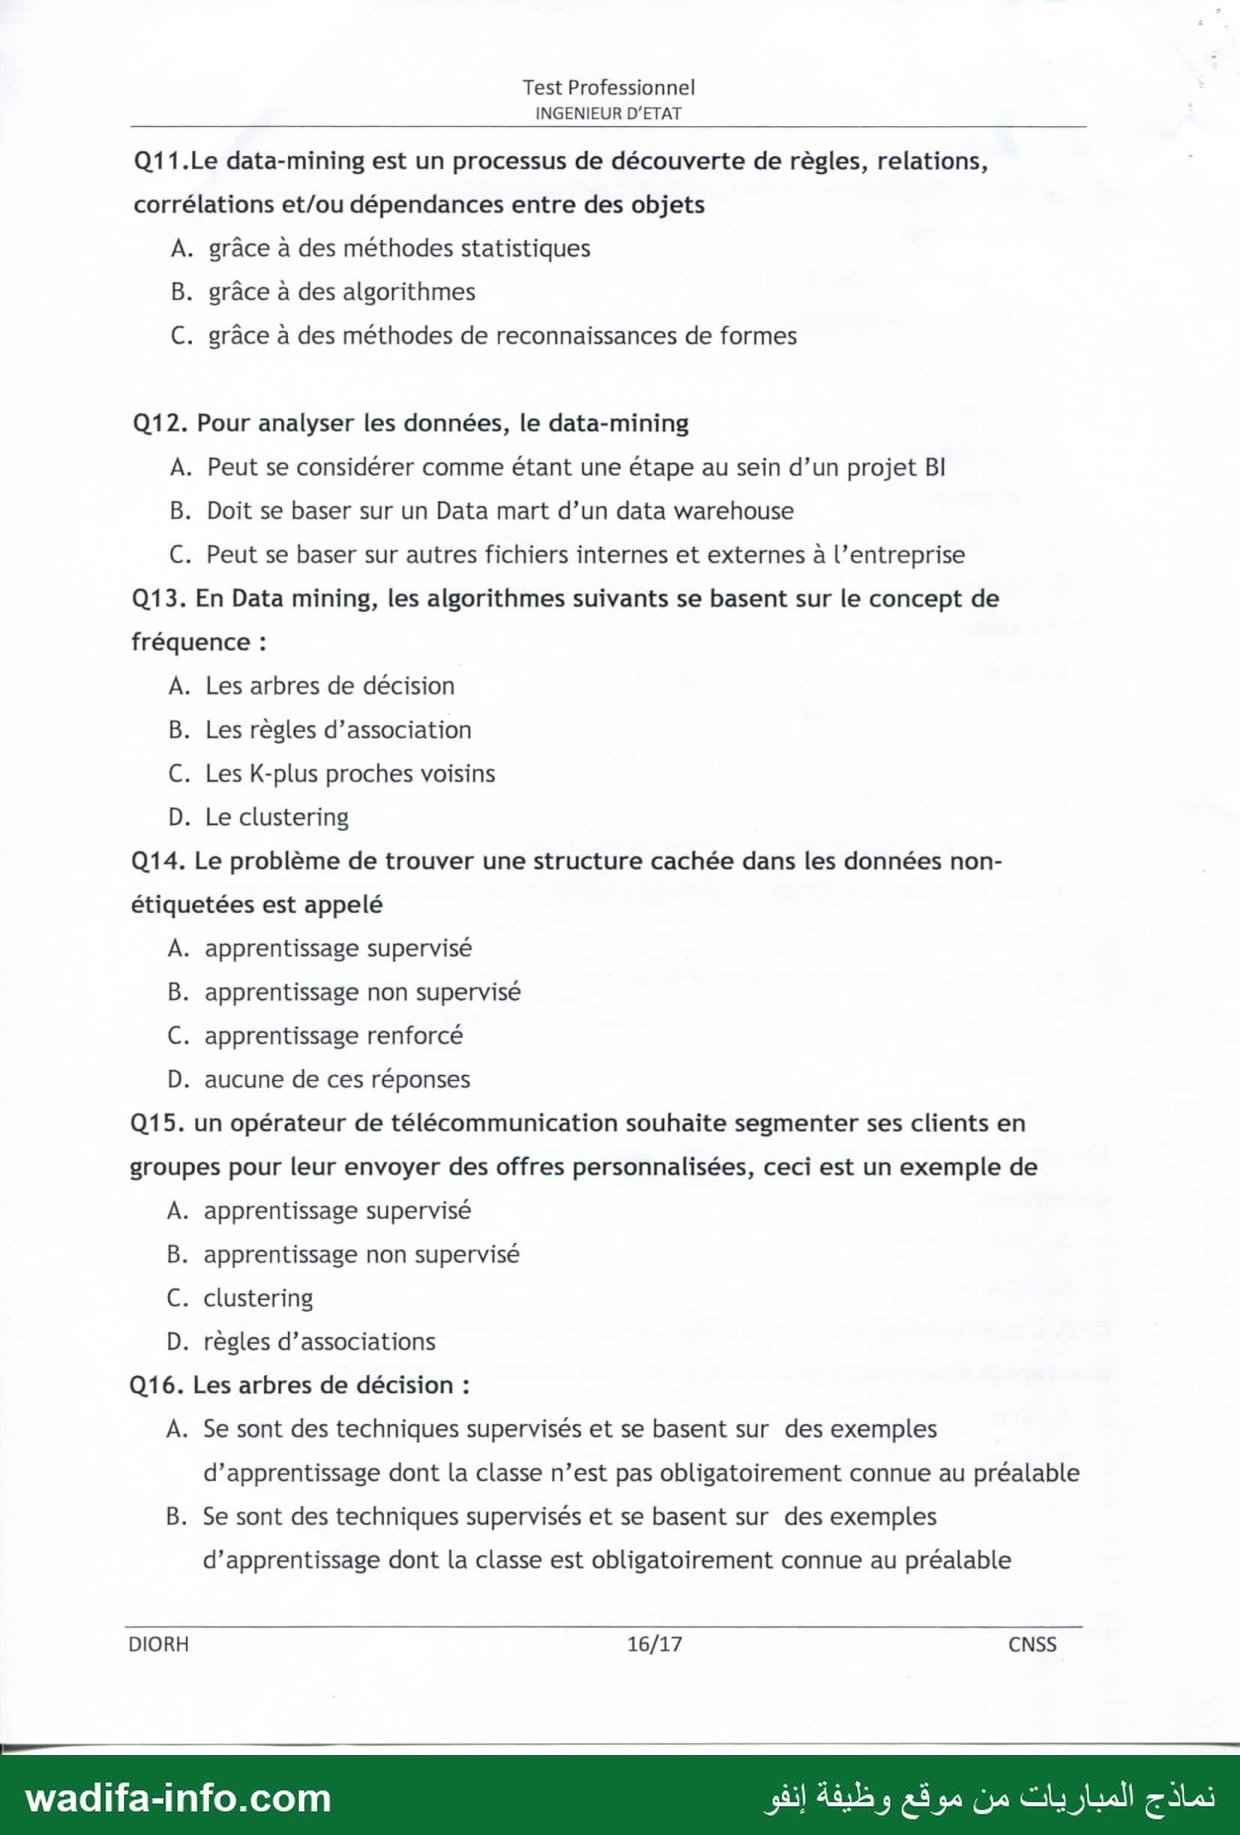
Q11.Le data-mining est un processus de découverte de règles, relations,
corrélations et/ou dépendances entre des objets
A. grâce à des méthodes statistiques
B. grâce à des algorithmes
C. grâce à des méthodes de reconnaissances de formes
Q12. Pour analyser les données, le data-mining
A. Peut se considérer comme étant une étape au sein d’un projet BI
B. Doit se baser sur un Data mart d’un data wWarehouse
C. Peut se baser sur autres fichiers internes et externes à l’entreprise
Q13. En Data mining, les algorithmes suivants se basent sur le concept de
fréquence :
A. Les arbres de décision
B. Les règles d’association
C. Les K-plus proches voisins
D. Le clustering
Q14. Le problème de trouver une structure cachée dans les données non-
étiquetées est appelé
A. apprentissage supervisé
B. apprentissage non supervisé
C. apprentissage renforcé
D. aucune de ces réponses
Q15. un opérateur de télécommunication souhaite segmenter ses clients en
groupes pour leur envoyer des offres personnalisées, ceci est un exemple de
A. apprentissage supervisé
B. apprentissage non supervisé
C. clustering
D. règles d’associations
Q16. Les arbres de décision :
A. Se sont des techniques supervisés et se basent sur des exemples
d'apprentissage dont la classe n’est pas obligatoirement connue au préalable
B. Se sont des techniques supervisés et se basent sur des exemples
d'apprentissage dont la classe est obligatoirement connue au préalable
DIORH 6/17 CNSS
| : Test Professionnel
5 INGENIEUR D'ETAT
C. N’ont pas besoin d’une base de données de taille importante pour établir un
bon modèle
D. Utilisent différents techniques de calcul de la similarité entre les objets
pendant la phase d'apprentissage
Q17. Pour un bon algorithme d’arbre de décision:
A. La racine de chaque sous arbre est trouvé selon un choix aléatoire et selon
ce choix faire des tests pour l’accepter ou refaire les calculs
B. La racine de chaque sous arbre est trouvé selon des méthodes
C. Peut-être considérer efficace s’il est capable d’identifier un modèle qui ne
change pas si on change la taille de la base d’apprentissage.
D. Doit fournir à n’importe quel nouvel objet la bonne classe
Q18.Pour une technique de machines learning:
A. Elle doit être validée par une méthode de validation qui peut contenir des
éléments à partir de la base d’apprentissage
B. Les données de tests doivent être différentes des données d’apprentissage
C. On peut alterner entre les données de tests et Les données d’apprentissage
et calculer la moyenne d’erreur
Q19. Pour un algorithme de clustering, une méthode de calcul de distance entre
des individus:
A. Est sensible au type de données
B. Peut combiner un ensemble de techniques pour calculer une distance entre
deux individus
C. Peut représenter une solution efficace si Les données sont quantitatives
D. S'il existe des données qualitatives, l’algorithme est inadéquat
Q20. Dans les règles d’association, le concept de confiance minimal:
À. Permet de définir Les ensembles d’items fréquents
B. Permet d’éliminer des règles qui peuvent être non intéressantes
C. Permet d’éliminer Les exemples non fréquents
D. Est calculé automatiquement à partir des items fréquents
Correction proposée
Il s'agit d'une correction proposée, rédigée par l'équipe wadifa-info pour vous aider à comprendre la méthode — ce n'est pas un corrigé officiel de l'administration organisatrice.
Ce modèle est le test professionnel « Ingénieur d'État » du concours de recrutement de la Caisse Nationale de Sécurité Sociale (CNSS), préparé par la DIORH. La session n'est pas datée. Il comprend une partie commune de 20 QCM (modélisation de données, algorithmique, programmation) et une partie spécialité au choix : « Organisation et qualité process » (20 questions) ou « Ingénierie décisionnelle » (20 questions). La consigne est de choisir « la ou les réponse(s) les plus appropriées » et de les reporter sur une grille. Celle-ci, en page 1/17, ne figure pas sur le document publié.
💡 Exercices de code : ne devinez pas, déroulez le programme à la main avec un tableau des variables, itération par itération. C'est rapide et fiable. Toutes les traces ci-dessous ont été vérifiées en exécutant le code.
Partie commune
Modèle entités-associations (Q1 à Q7)
- Q1 → B et D. Le MCD est une représentation statique des données (le comportement relève du modèle des traitements). C'est un schéma d'entités, d'associations et de propriétés. Une propriété est une donnée élémentaire, pas un « nombre de colonnes ».
- Q2 → C (réponse probable). En Merise, une entité ne contient que des propriétés élémentaires : c'est la première forme normale, donc B est faux. Une association n'a pas d'identifiant propre : il est formé par la combinaison des identifiants des entités reliées, ce qui rend A discutable. D parle de « classe », un vocabulaire objet hors sujet. E est faux : les cardinalités dépendent des règles de gestion, pas d'une « taille ».
- Q3 → A et C. Une entité modélise un ensemble d'individus de même nature et possède obligatoirement un identifiant. Elle ne contient pas de traitements (B). Le MCD est indépendant du SGBD (D).
- Q4 → B et C (réponse probable). Une association peut devenir une table : c'est le cas lorsqu'elle est de type n-n, c'est-à-dire avec une cardinalité maximale n de chaque côté, dont un (1,n). Une association peut aussi porter des propriétés, par exemple une date ou une quantité. A est faux : une association 1-n se traduit par une clé étrangère, pas par une table. D est faux, pour la raison donnée en Q2.
- Q5 → C (réponse probable). L'entité Candidat (matricule, nom, prénom, ville) respecte déjà les trois premières formes normales : toutes les propriétés sont élémentaires et dépendent du seul identifiant. A et B sont donc faux. Ce que le concepteur attend : ville se répète d'un candidat à l'autre. On en fait une entité à part, reliée à plusieurs candidats, pour éviter la redondance. D est faux : une ville ne concerne pas un seul candidat.
- Q6 → C. La note dépend à la fois du candidat et de l'épreuve. Elle se place donc sur l'association passer (0,n – 0,n), qui deviendra la table PASSER(matricule, code, note).
- Q7 → A, D et E. La redondance, c'est une même information stockée plusieurs fois ou déductible d'une autre : propriété répétée dans plusieurs entités, donnée calculable. Elle provoque des incohérences lors des mises à jour.
Algorithmique et complexité (Q8 à Q13)
- Q8 → A et D. Un algorithme est une suite finie et non ambiguë d'instructions. Il n'est correct que s'il donne le bon résultat pour toute entrée valide. B confond l'algorithme avec un schéma de conception. E est faux : un même problème admet souvent plusieurs algorithmes efficaces.
- Q9 → B. La complexité s'analyse par un calcul indépendant de la machine : on compte les opérations élémentaires en fonction de n, en notation Θ ou O. A et C mesurent des performances, pas la complexité.
- Q10 → D. Θ(log n). La recherche dichotomique divise l'intervalle par 2 à chaque comparaison. Pour n = 1 024, on fait au plus 11 comparaisons.
- Q11 → B et C. La recherche parcourt au plus une branche, soit Θ(h). Dans un arbre équilibré, h = Θ(log n) : les deux écritures sont justes.
- Q12 → A et C. Le tri par sélection cherche le plus petit élément du reste du tableau et l'échange avec la première case non triée. Il fait n(n−1)/2 comparaisons, soit Θ(n²), quel que soit l'ordre initial.
- Q13 → D. Le tri par tas coûte Θ(n log n) : n extractions, chacune en Θ(log n). Un tas est un arbre binaire presque complet où chaque père est supérieur ou égal à ses fils. Ce n'est pas un arbre binaire de recherche (A), ni une pile (B).
Programmation (Q14 à Q20)
Q14 → B et D. break quitte la boucle, pas la procédure. Trace : i = 1 → affiche 1 ; i = 2 → affiche 2 ; i = 3 → affiche 3, puis 3 % 3 == 0 déclenche break. Après la boucle, afficher(i) affiche encore 3. Résultat : 1 2 3 3.
Q15 → A (3). T = {3, 5, 8, 11, 10, 9, 2, 6, 7}. Au premier tour, i = 0 et j devient 1. On teste T[0] = 3 < T[1] = 5 : c'est vrai, donc la fonction retourne 3 immédiatement.
Q16 → C (3 2 3 8 3). j part de 8 et diminue de 3. i va de 0 à j−1, de 2 en 2.
| j (T[j]) | i testés | Affichés |
|---|---|---|
| 8 (7) | 0, 2, 4, 6 → 3, 8, 10, 2 | 3, 2 |
| 5 (9) | 0, 2, 4 → 3, 8, 10 | 3, 8 |
| 2 (8) | 0 → 3 | 3 |
j passe ensuite à −1 et la boucle s'arrête.
Q17 → C (13). C'est le calcul itératif de la suite de Fibonacci. On part de a = 0, b = 1, et la boucle tourne pour i = 1 à 6, soit 6 fois. c prend successivement les valeurs 1, 2, 3, 5, 8, 13. La valeur initiale 99 est écrasée dès le premier tour.
Q18 → C (2 1 2 0 2 1 2). h2(0) appelle h2(1), qui appelle h2(2). h2(2) affiche 2. De retour dans h2(1) : affichage de 1, puis nouvel appel h2(2), qui affiche 2. De retour dans h2(0) : affichage de 0, puis un second appel h2(1) produit de nouveau 2 1 2. Total : 2 1 2 0 2 1 2.
Q19 → D (4 2 5 8 1 6 3 7). L'arbre a pour racine 1, avec 2 à gauche et 3 à droite. Le nœud 2 a pour fils 4 et 5, et 5 a un fils droit 8. Le nœud 3 a pour fils 6 et 7. La procédure visite le sous-arbre gauche, affiche la racine, puis visite le sous-arbre droit : c'est un parcours infixe, donc ni A ni B. C est l'ordre préfixe, E l'ordre postfixe.
Q20 → A et E. La procédure visite le sous-arbre gauche, puis le droit, puis affiche la racine : c'est un parcours postfixe. Résultat : 4 8 5 2 6 7 3 1.
Spécialité : Organisation et qualité process
- 1 → B et D. Le SMED réduit la durée des changements de série. Il transforme les réglages internes (machine arrêtée) en réglages externes (machine en marche) : c'est l'inverse de la proposition C. Il améliore aussi la logistique des outillages. Il ne vise pas à réduire le nombre de réglages (A).
- 2 → C. AMDEC. L'analyse des modes de défaillance, de leurs effets et de leur criticité calcule une criticité C = fréquence × gravité × non-détection. Elle sert à hiérarchiser les actions. Pareto classe des causes déjà observées.
- 3 → B (réponse probable). La définition (critères de coût, niveaux de performance, sécurité et fiabilité d'un produit qui doit satisfaire le client) décrit la qualité d'un produit, au sens de sa conception. Le contrôle vérifie la conformité. L'assurance qualité donne confiance par des dispositions préétablies (voir 16).
- 4 → C. La qualité est l'aptitude d'un produit à satisfaire les besoins, exprimés ou implicites.
- 5 → B. L'autocontrôle est le contrôle effectué par l'opérateur sur son propre travail. La proposition C définit le « statut de contrôle ».
- 6 → B. Traçabilité (définition de l'ISO 8402).
- 7 → B. En flux tendus (juste-à-temps), on produit en fonction des besoins exprimés par l'aval, en flux tiré, et non sur prévision.
- 8 → C. La qualité est l'affaire de tous les départements : c'est le principe du management de la qualité.
- 9 → A, B et D. Un indicateur qualité est mesurable, suit l'atteinte des objectifs et est communiqué au personnel. C est une plaisanterie.
- 10 → A. Les contrôles en cours de fabrication détectent les défauts au plus tôt. Les contrôles finaux et les réclamations des clients arrivent trop tard.
- 11 → B. Un certificat AFAQ atteste que l'entreprise respecte les exigences de la norme visée (par exemple ISO 9001). Il ne garantit ni un produit « supérieur » ni le « meilleur » produit.
- 12 → A (réponse probable). Le manuel qualité exprime la politique et les engagements de la direction : il est signé par le chef d'entreprise. Le responsable qualité le rédige et le tient à jour, mais l'engagement vient de la direction.
- 13 → D (et C). La finalité d'un SMQ selon l'ISO 9001 est d'accroître la satisfaction des clients, d'abord externes. La satisfaction des clients internes y contribue. Réduire les coûts et respecter les délais sont des moyens ou des effets.
- 14 → A. L'ISO 9001 fixe les exigences d'un SMQ. Les principes et le vocabulaire relèvent de l'ISO 9000, l'audit de l'ISO 19011, l'automobile de l'IATF 16949.
- 15 → C. Les cartes de contrôle (Shewhart) surveillent le processus pendant la production, par prélèvements réguliers.
- 16 → A. C'est la définition normalisée de l'assurance qualité. B décrit un contrat de fourniture ou un plan de livraison.
- 17 → D. Après un point haut, les points montent régulièrement : c'est une tendance croissante. Il faut intervenir avant que la limite supérieure ne soit franchie. Le procédé n'est donc pas « sous contrôle ».
- 18 → A. Les points oscillent de façon aléatoire autour de la moyenne, sans tendance ni série, à l'intérieur des limites : le procédé est sous contrôle.
- 19 → A et C. La dispersion (environ 6σ) est nettement plus étroite que l'intervalle de tolérance, donc le procédé est capable. La courbe est en plus centrée sur l'intervalle : il est aussi réglé.
- 20 → A. Conditionnelle. Le graphique montre des mesures périodiques pendant la production, et l'arrêt pour intervention survient quand la mesure l'exige. Une maintenance systématique interviendrait à intervalles fixes, sans mesure.
Spécialité : Ingénierie décisionnelle
- Q1 → C et E (réponse probable). Le système décisionnel est séparé du transactionnel. Il est alimenté par des chargements périodiques (ETL), en général hors heures de production, pour ne pas peser sur le système opérant. Il n'accélère pas le système opérant (A). Il ne charge pas les données pendant son utilisation (B), et il n'y est pas lié en permanence (D).
- Q2 → C et D. Structure souple, orientée analyse, et données centralisées dans l'entrepôt. Le décisionnel est un ensemble de concepts, de méthodes, de technologies et d'outils. Sa structure n'est pas celle d'un système OLTP (B).
- Q3 → A. Une architecture BI comprend des sources, un ETL, un data warehouse (et des data marts), des outils d'analyse OLAP et des outils de reporting et de restitution.
- Q4 → A (et C) (réponse probable). La définition d'Inmon : orienté sujet, intégré, non volatil, historisé. La proposition C dit la même chose en d'autres termes (données de différents métiers intégrées, non volatiles, historisées). Une stricte application de la définition attend A.
- Q5 → B. Un data mart est un sous-ensemble de l'entrepôt consacré à un métier ou un service. Il n'est pas une zone de stockage volatile, qui serait la staging area (C).
- Q6 → B (réponse probable). L'entrepôt se modélise de façon dimensionnelle et dénormalisée (schéma en étoile), au profit de la performance des requêtes. D, normaliser ponctuellement selon le besoin (flocon), reste une variante.
- Q7 → A et D. La table de faits contient les mesures, souvent agrégées au grain choisi, et les clés étrangères des dimensions, dont la dimension temps. Elle est reliée à plusieurs axes d'analyse, pas à un seul (C).
- Q8 → B et D (réponse probable). La dimension temps se génère automatiquement par programme (jours, semaines, mois, jours fériés…), sans dépendre des ventes. Elle est commune à pratiquement toutes les tables de faits.
- Q9 → A (vrai). Le schéma en étoile dénormalise les dimensions, ce qui introduit une redondance. Exemple : le nom de la région se répète pour chaque ville.
- Q10 → B (faux). Le flocon multiplie les jointures, donc une requête y est en général plus lente qu'en étoile.
- Q11 → A, B et C. Le data mining combine méthodes statistiques, algorithmes d'apprentissage et reconnaissance de formes.
- Q12 → A et C. Le data mining peut être une étape d'un projet BI. Il peut aussi exploiter d'autres sources, internes ou externes : il n'exige pas un data mart.
- Q13 → B. Les règles d'association (algorithme Apriori) reposent sur la fréquence des itemsets, c'est-à-dire leur support.
- Q14 → B. Trouver une structure dans des données non étiquetées, c'est l'apprentissage non supervisé.
- Q15 → B et C. La segmentation de clients sans classes connues à l'avance est un problème de clustering, donc d'apprentissage non supervisé.
- Q16 → B. Les arbres de décision sont supervisés : la classe des exemples d'apprentissage est connue. Ils ont besoin d'un volume suffisant de données (C est faux). Le calcul de similarité entre objets (D) caractérise plutôt les k plus proches voisins.
- Q17 → B (et C) (réponse probable). Le choix de l'attribut à chaque nœud suit une méthode : gain d'information (ID3, C4.5) ou indice de Gini (CART). Ce n'est pas un tirage aléatoire. La stabilité du modèle quand la base d'apprentissage varie est un critère de qualité (C). Aucun modèle ne classe parfaitement tout nouvel objet (D).
- Q18 → B et C. Les données de test doivent être distinctes des données d'apprentissage. La validation croisée alterne les deux et fait la moyenne des erreurs. A est faux : valider sur des données d'apprentissage surestime la performance.
- Q19 → A, B et C. La distance dépend du type de données. On peut combiner plusieurs mesures pour des données mixtes, comme la distance de Gower. La distance euclidienne est efficace sur des variables quantitatives. D est faux : il existe des distances pour les variables qualitatives.
- Q20 → B. La confiance minimale filtre les règles peu fiables. Les itemsets fréquents sont définis par le support minimal (A et C). La confiance est un seuil fixé par l'analyste, pas une valeur calculée automatiquement (D).
Questions fréquentes sur ce sujet
Ce sujet est-il téléchargeable gratuitement ?
Le corrigé est-il inclus ?
Quel organisme et quel grade concerne ce sujet ?
De quelle session s'agit-il et dans quelle langue ?
Où trouver d'autres sujets du même concours ?
Vous préparez ce concours ?
Modèles similaires
Organisme : la Caisse Nationale de Sécurité Sociale (CNSS) — Copie issue de : archive de modèles de concours — document archivé tel que reçu ; l'avis officiel du concours fait foi.
}Citer cette page
Journaliste, blogueur, enseignant : copiez la référence ci-dessous et mettez un lien vers cette page.
Adresse permanente : https://www.wadifa-info.com/fr/modele-concours/2493/modele-de-concours-de-recrutement-ingenieurs-d-etat-caisse-nationale-de-securite-sociale
