
Modèle de concours : CNC 2018 Informatique (MP) — Concours National Commun
⬇️ Télécharger le PDF Adresse permanente : https://www.wadifa-info.com/fr/modele-concours/1640/modele-de-concours-cnc-2018-informatique-mp-concours-national-commun
En bref
Ce document est une ancienne épreuve écrite du concours de Concours d'accès aux écoles d'ingénieurs organisé par Concours National Commun (CNC) — CPGE (2018), publiée sur Wadifa Info en consultation et téléchargement PDF gratuits, avec une correction proposée.
- Organisme
- Concours National Commun (CNC) — CPGE
- Grade
- Concours d'accès aux écoles d'ingénieurs
- Spécialité
- Informatique
- Année
- 2018
- Pages
- 12
- Langue des questions
- français
- Correction
- correction proposée disponible sur cette page
📝 Texte des questions (extrait automatiquement des pages scannées)
Ce texte est extrait automatiquement des images de l'épreuve et peut contenir des erreurs de lecture — les images ci-dessus font foi.
— صفحة 1 —
Épreuve d’Informatique — Session 2018 — Filière MP
Les candidats sont informés que la précision des raisonnements algorithmiques ainsi que le soin apporté
à la rédaction et à la présentation des copies seront des éléments pris en compte dans la notation. Il
convient en particulier de rappeler avec précision les références des questions abordées. Si, au cours de
l'épreuve, un candidat repère ce qui peut lui sembler être une erreur d'énoncé, il le signale sur sa copie et
poursuit sa composition en expliquant les raisons des initiatives qu'il est amené à prendre.
Remarques générales :
v L'épreuve se compose de deux parties indépendantes.
v Toutes les instructions et les fonctions demandées seront écrites en Python.
v Les questions non traitées peuvent être admises pour aborder les questions ultérieures.
v Toute fonction peut être décomposée, si nécessaire, en plusieurs fonctions.
ثم ثم ثم ثم ثم ثم ثم ثم ثم يم يلم يتم ثم ثم ثم ثم ثم ثم ثم ثم يم ثم يم ثم يم يم
Partie I : Calcul numérique
Résolution numérique d’équation différentielle
Les méthodes d'Adams-Bashforth et d’Adams-Moulton
Dans cette partie, on suppose que les modules suivants sont importés :
from numpy import *
from matplotlib.pyplot import *
Les équations différentielles (ED) apparaissent très souvent dans la modélisation de la physique et des
sciences de l'ingénieur. Trouver la solution d'une ED ou d'un système d'ED est ainsi un problème courant,
souvent difficile ou impossible à résoudre de façon analytique. Il est alors nécessaire de recourir à des
méthodes numériques pour les résoudre.
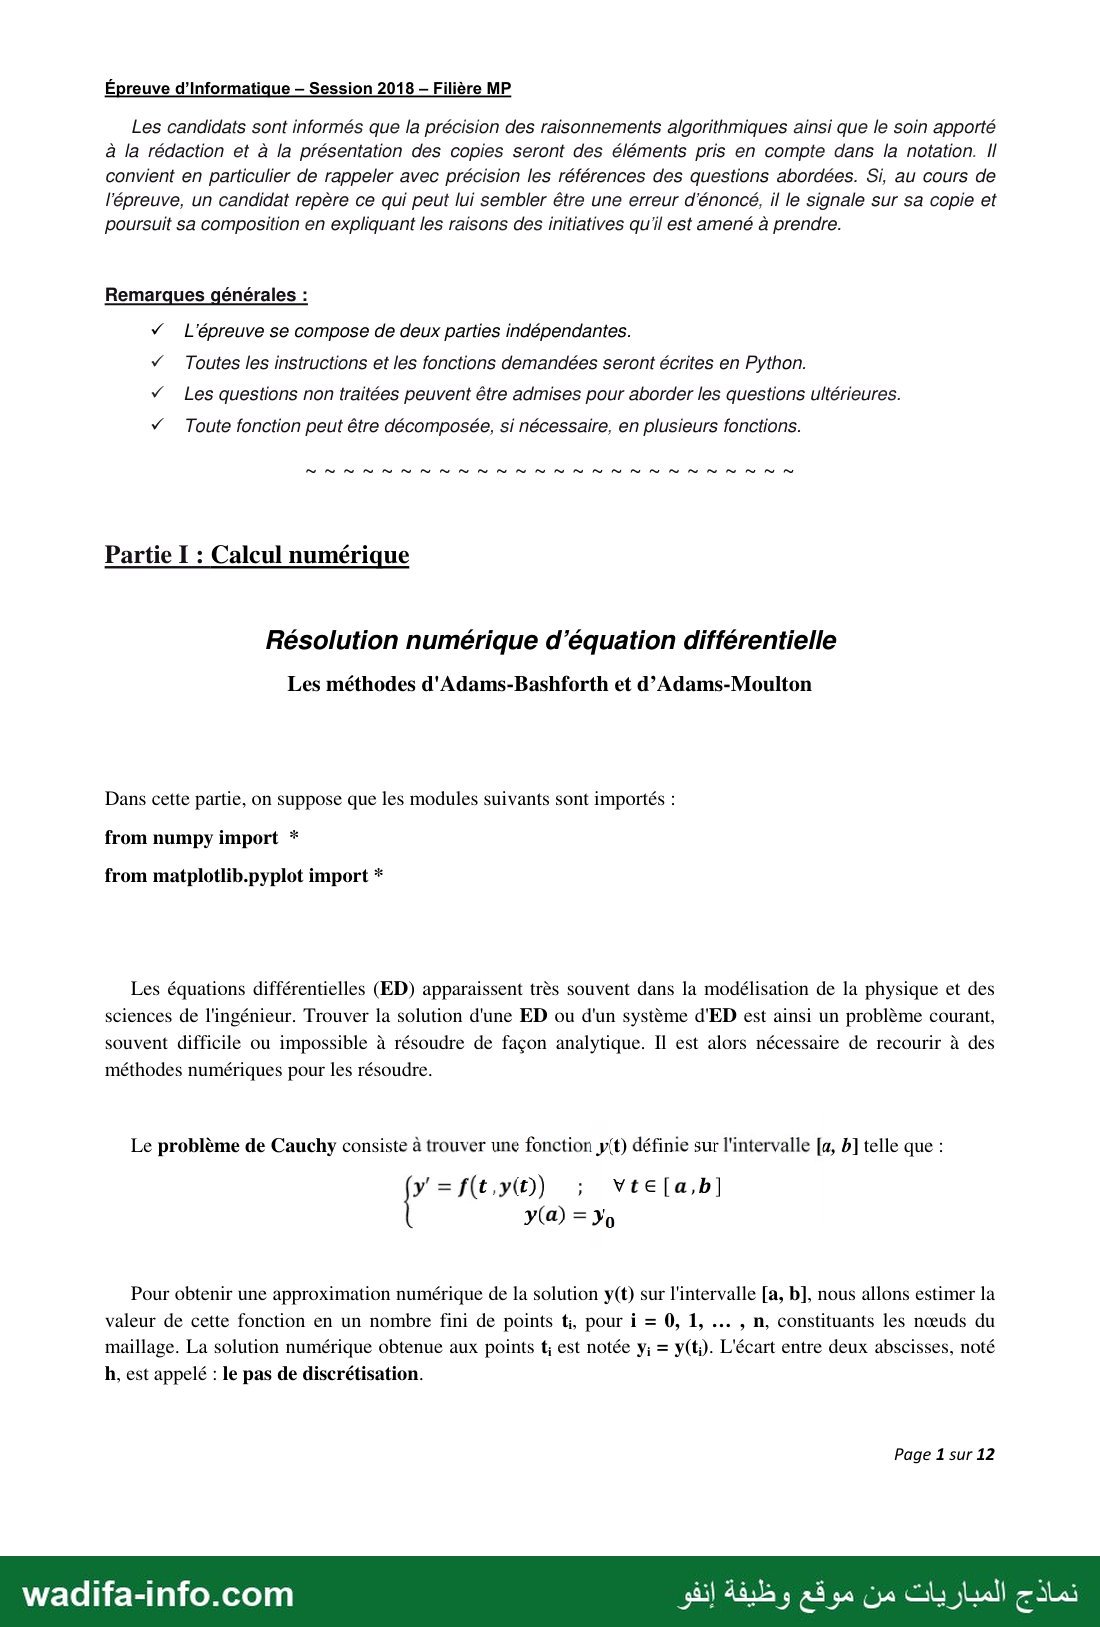
Le problème de Cauchy consiste à trouver une fonction y{t) définie sur l'intervalle [a, 5] telle que :
Pour obtenir une approximation numérique de la solution y(t) sur l'intervalle [a, b], nous allons estimer la
valeur de cette fonction en un nombre fini de points ينا pour i = 0, 1, … , بل constituants les nœuds du
maillage. La solution numérique obtenue aux points t; est notée y; = y(t;). L'écart entre deux abscisses, noté
h, est appelé : le pas de discrétisation.
Page 1 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 2 —
Épreuve d’Informatique — Session 2018 - Filière MP
Les principales méthodes de résolution numérique des ED sont séparées en deux grandes catégories :
v les méthodes à un pas : Le calcul de la valeur يبول au nœud t,… fait intervenir la valeur y, obtenue à
l'abscisse précédente. Les principales méthodes sont celles de : Euler, Runge-Kutta, Crank-
Nicholson …
v les méthodes à multiples pas : Le calcul de la valeur ÿ,+1 au nœud t,- fait intervenir plusieurs
valeurs Ya » Yn-1, Yn2, ... Obtenues aux abscisses précédentes. Les principales méthodes sont celles
de : Nystrôm, Adams-Bashforth, Adams-Moulton, Gear …
Les méthodes d’Adams-Bashforth et d’Adams-Moulton :
Ce sont des méthodes basées sur des techniques d'intégration numérique, qui utilisent les polynômes
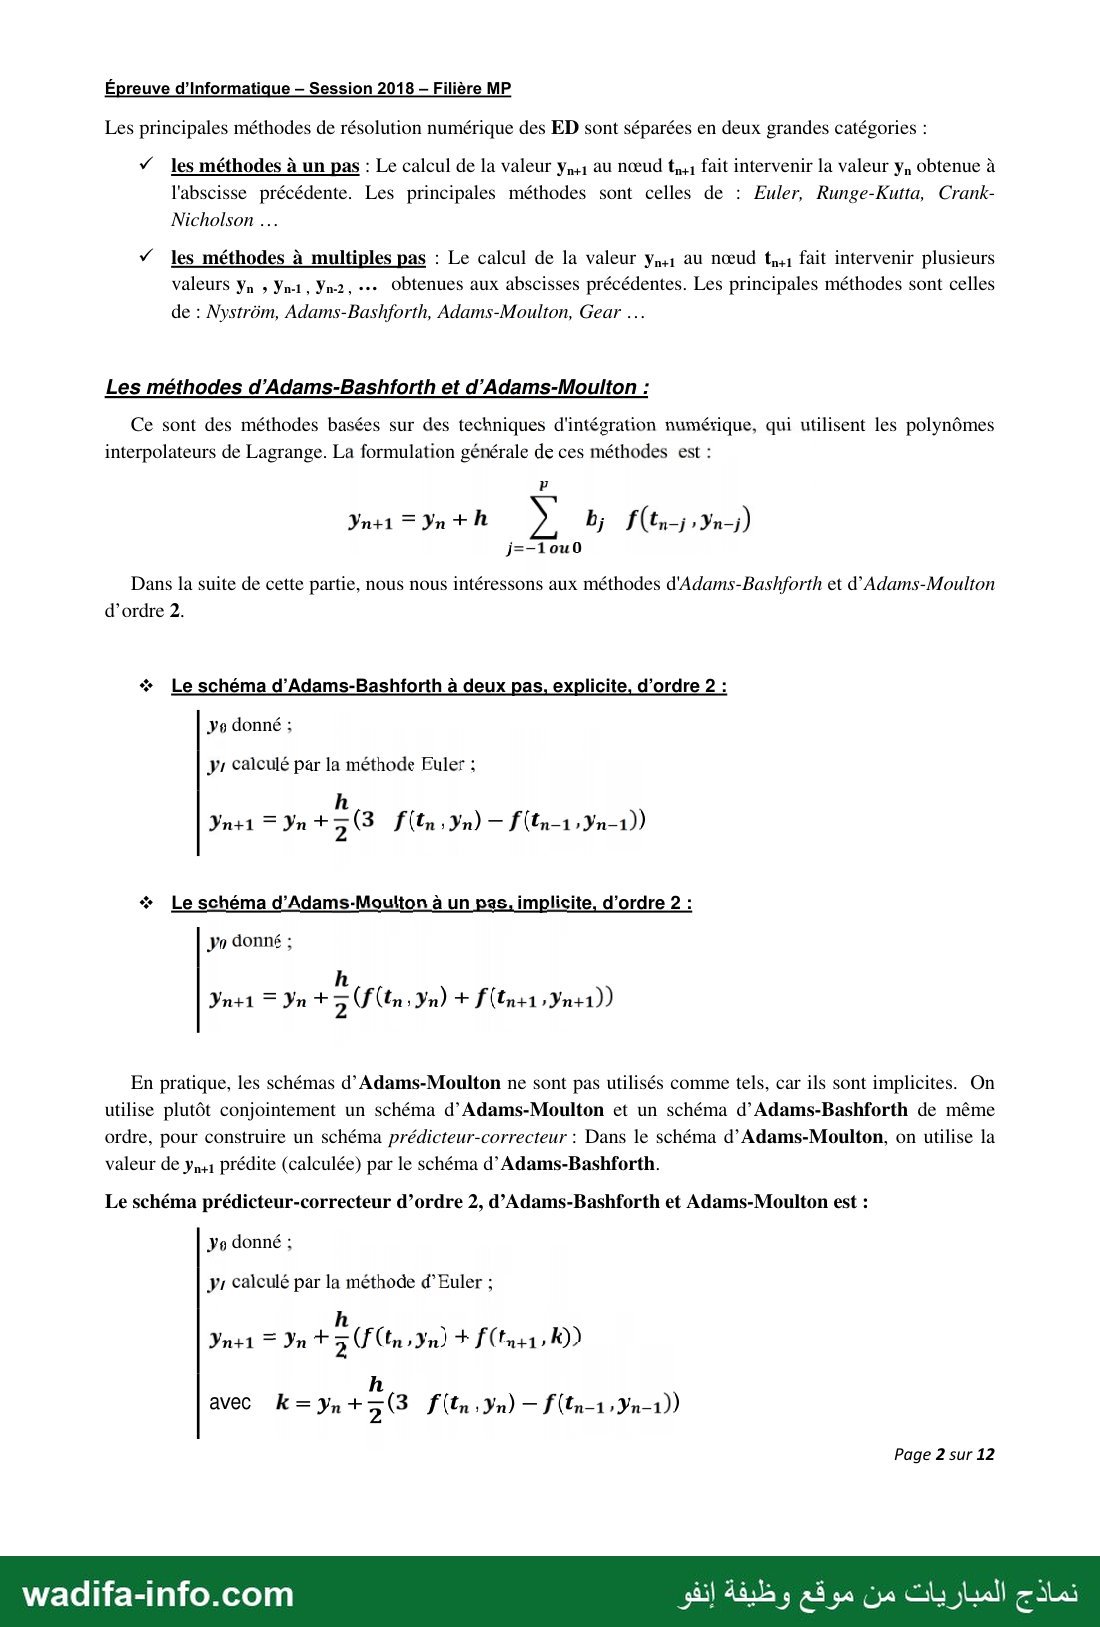
interpolateurs de Lagrange. La formulation générale de ces méthodes est :
7
j=—-10u0
Dans la suite de cette partie, nous nous intéressons aux méthodes d'Adams-Bashforth et d’Adams-Moulton
d’ordre 2.
* Le schéma d’Adams-Bashforth à deux pas, explicite, d’ordre 2 :
Ye donné :
y: calculé par la méthode Euler ;
* Le schéma d’Adams-Moulton à un pas,implicite, d’ordre 2 :
Yo donné ;
Yn+1 = Yn+ 2 (Flta 1 Yn) + f(tn+1 Yn+1))
En pratique, les schémas d’Adams-Moulton ne sont pas utilisés comme tels, car ils sont implicites. On
utilise plutôt conjointement un schéma d’Adams-Moulton et un schéma d’Adams-Bashforth de même
ordre, pour construire un schéma prédicteur-correcteur : Dans le schéma d’Adams-Moulton, on utilise la
valeur de يبور prédite (calculée) par le schéma d’Adams-Bashforth.
Le schéma prédicteur-correcteur d’ordre 2, d’Adams-Bashforth et Adams-Moulton est :
Yo donné :
calculé par la méthode d’Euler ; ,تر
Yn+1 = Yn + 2 06 37 + Fltas1 , k))
avec k=yn+7(3 fltn.Yn) — f(tn-1›Yn-1))
Page 2 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 3 —
Épreuve d'Informatique — Session 2018 - Filière MP
© 1 : Écrire une fonction ABM2 (f, à, b, y0, h), qui reçoit en paramètres :
y f est la fonction qui représente une équation différentielle du premier ordre ;
7 aetb sont les deux bornes de l’intervalle d’intégration ;
آ y0 est la valeur initiale à l’instant a (y(a) = y0) ;
hest le pas de discrétisation. آ
En utilisant le schéma prédicteur-correcteur d'ordre 2, d'Adams-Bashforth et Adams-Moulton, la fonction
renvoie T et Y, qui peuvent être des listes ou des tableaux :
› 1 contient la subdivision de l’intervalle [a, b], en valeurs régulièrement espacée, utilisant le pas de
discrétisation h ;
› ل contient les approximations des valeurs y(t;), à chaque instant t; de 1
Application à un oscillateur harmonique
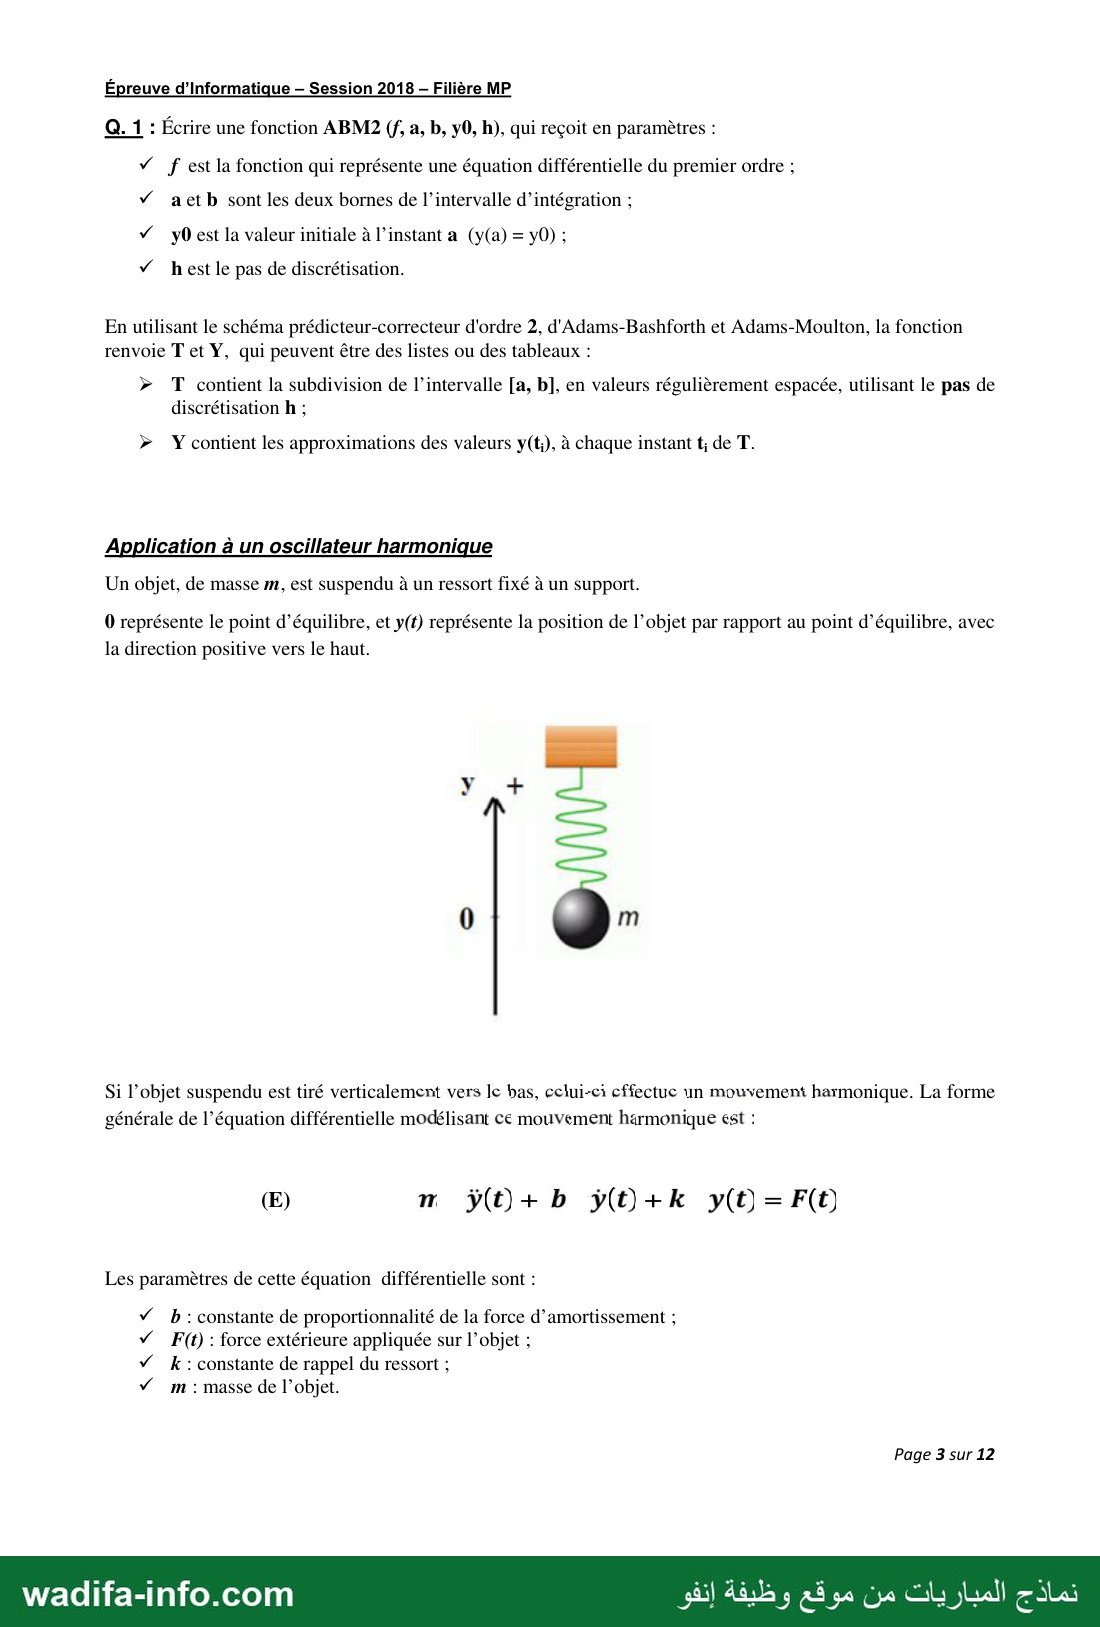
Un objet, de masse m, est suspendu à un ressort fixé à un support.
0 représente le point d’équilibre, et y(f) représente la position de l’objet par rapport au point d’équilibre, avec
la direction positive vers le haut.
Si l’objet suspendu est tiré verticalement vers lc bas, cclui-ci cffectuc un mouvement harmonique. La forme
générale de l’équation différentielle modélisant ce mouvement härmonique est :
Les paramètres de cette équation différentielle sont :
b : constante de proportionnalité de la force d’amortissement ; آ
F(t) : force extérieure appliquée sur l’objet ; آ
7 k : constante de rappel du ressort ;
7m : masse de l’objet.
Page 3 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 4 —
Épreuve d’Informatique — Session 2018 - Filière MP
Si b = 0 et F(t) = 0, alors le mouvement harmonique est dit : simple.
Sib =0 et F(t) = 0, alors mouvement harmonique est dit: amorti.
Si F(t) #0, alors mouvement harmonique est dit : forcé.
Q. 2 : On suppose que les valeurs des paramètres de l’équation différentielle (E), sont :
b=1 ; k=125 ; m=15 et 70-0
Écrire l’équation différentielle (E) sous la forme z' = G(t, z), avec G(t, Z) une fonction à deux variables (t, Z)
dont z est un tableau de longueur 2.
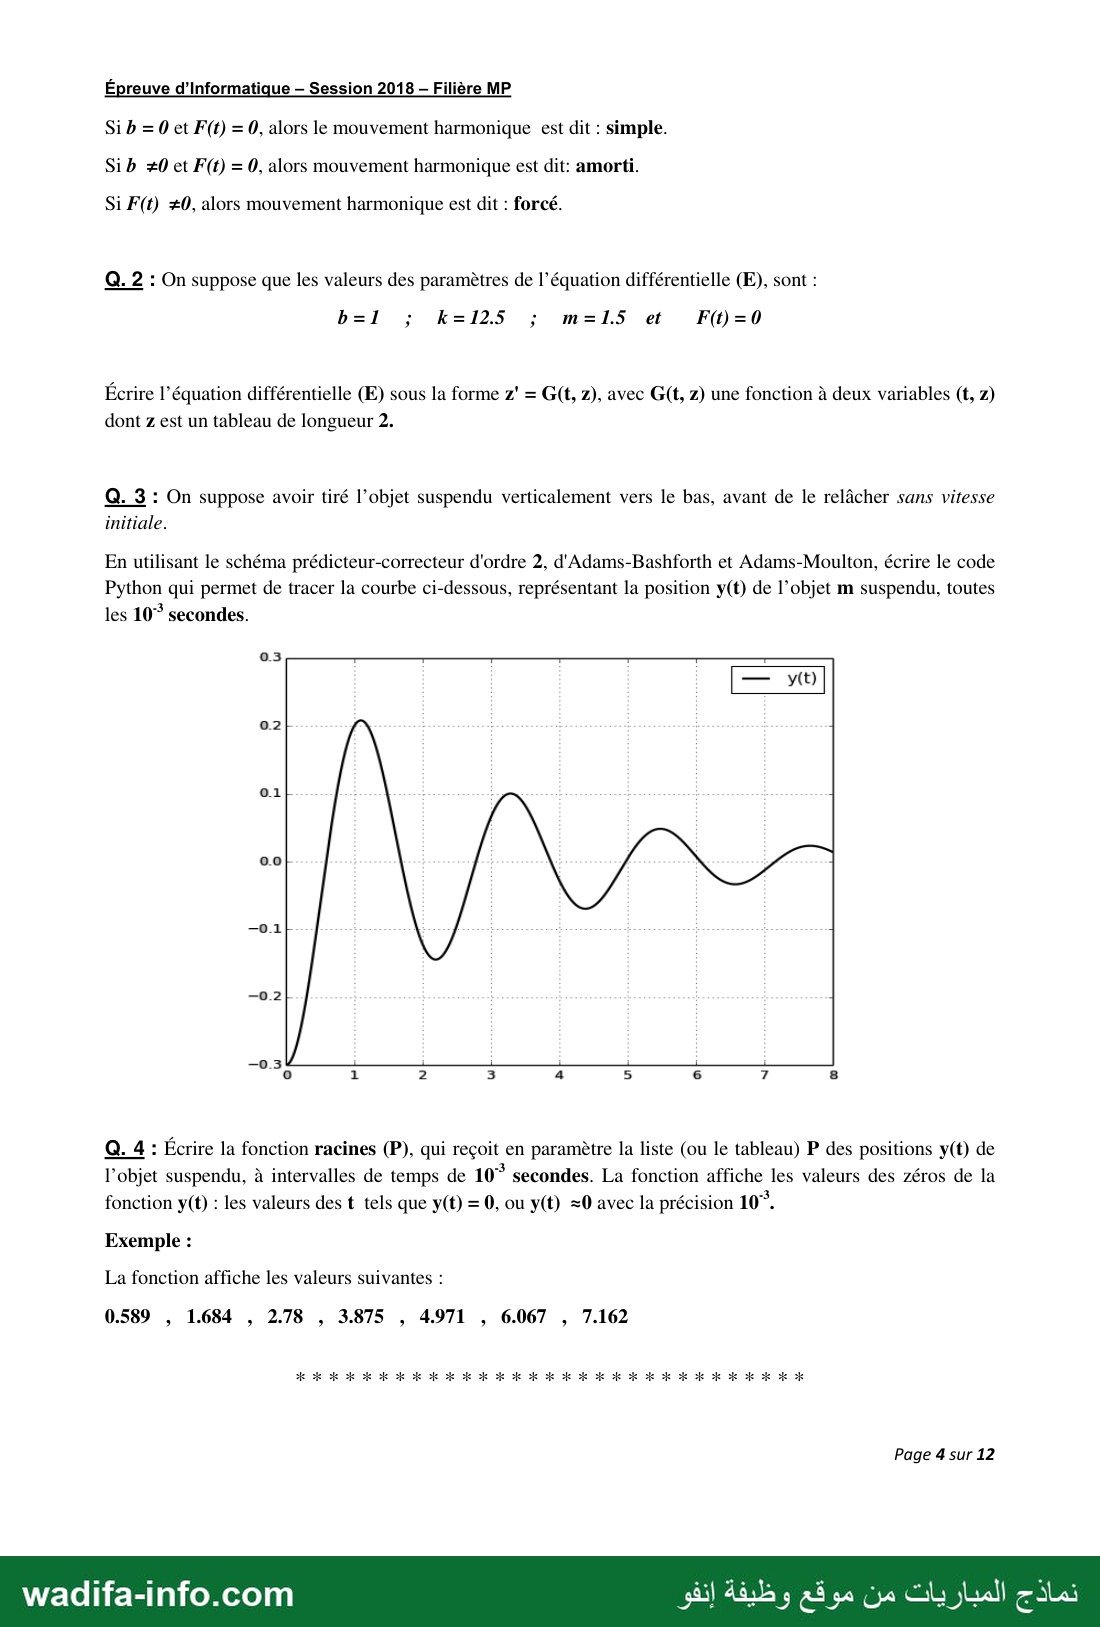
Q. 3 : On suppose avoir tiré l’objet suspendu verticalement vers le bas, avant de le relâcher sans vitesse
initiale.
En utilisant le schéma prédicteur-correcteur d'ordre 2, d'Adams-Bashforth et Adams-Moulton, écrire le code
Python qui permet de tracer la courbe ci-dessous, représentant la position y(t) de l’objet m suspendu, toutes
les 10° secondes.
Q. 4 : Écrire la fonction racines (P), qui reçoit en paramètre la liste (ou le tableau) P des positions y(t) de
l’objet suspendu, à intervalles de temps de 10” secondes. La fonction affiche les valeurs des zéros de la
fonction y(t) : les valeurs des t tels que y(t) = 0, ou y(t) =0 avec la précision 10°.
Exemple :
La fonction affiche les valeurs suivantes :
0.589 , 1.684 , 2.78 , 3.875 , 4.971 , 6.067 , 7.162
Page 4 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 5 —
Épreuve d’Informatique — Session 2018 — Filière MP
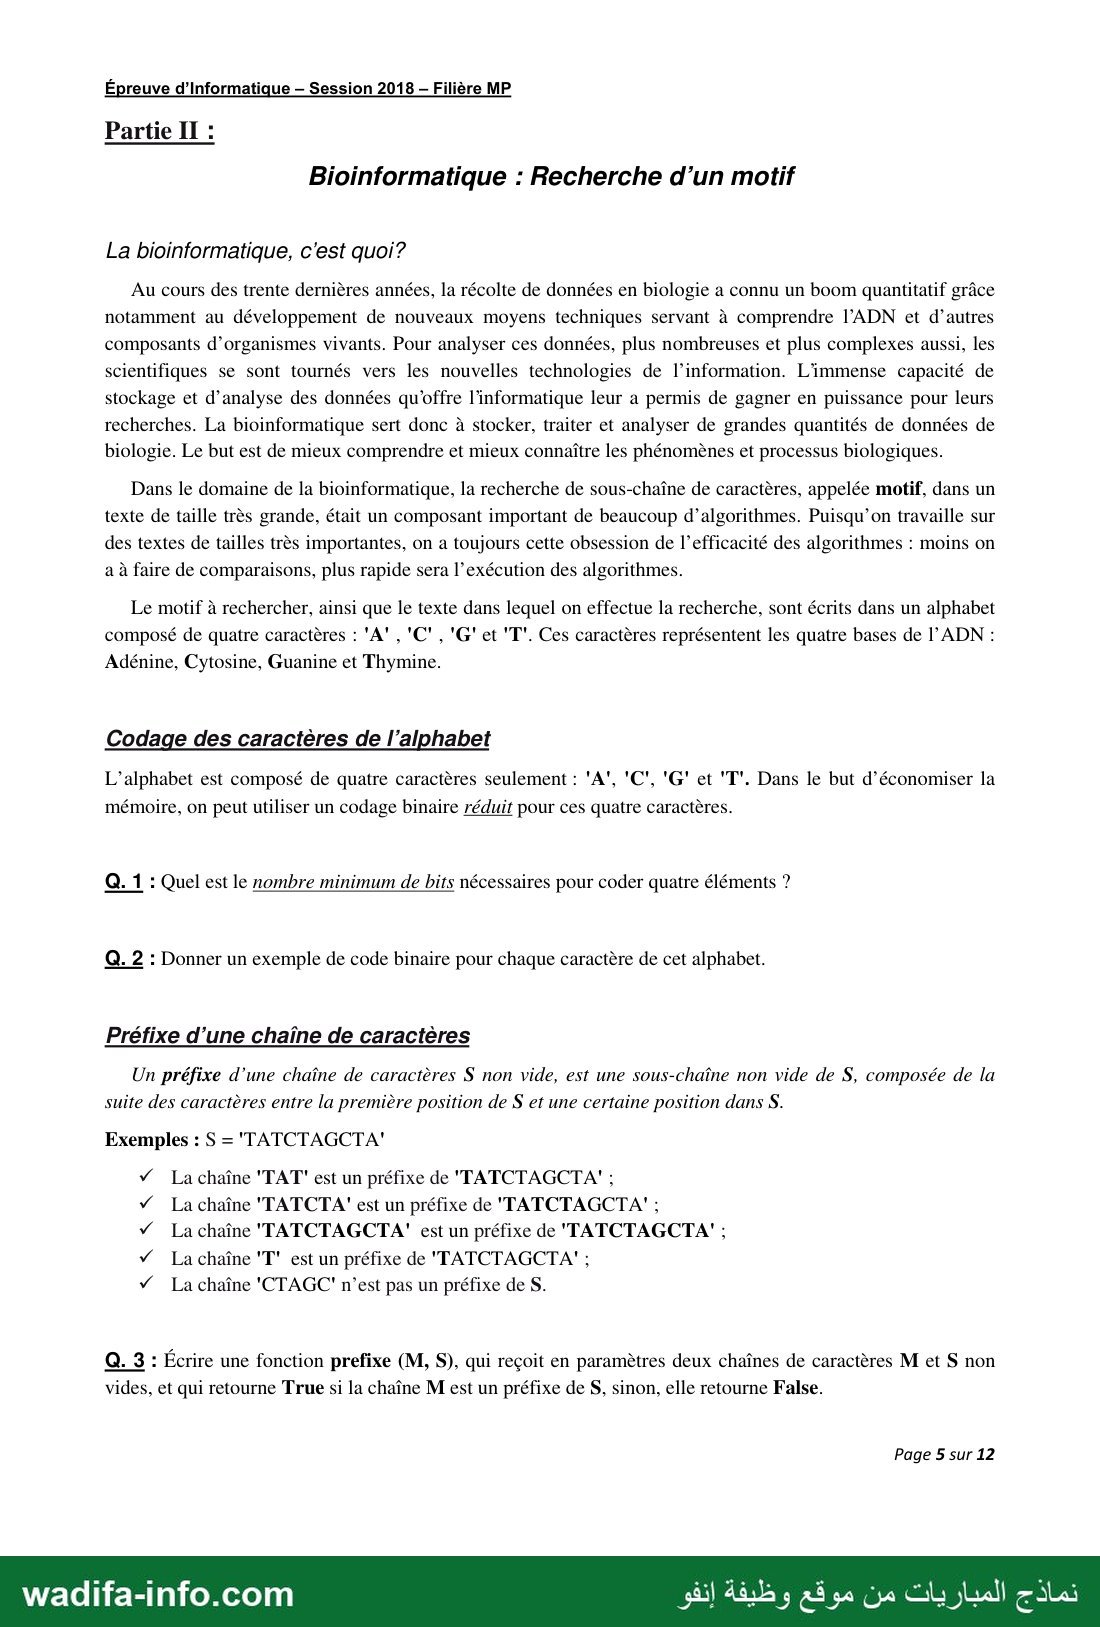
Partie II :
Bioinformatique : Recherche d’un motif
La bioinformatique, c'est quoi?
Au cours des trente dernières années, la récolte de données en biologie a connu un boom quantitatif grâce
notamment au développement de nouveaux moyens techniques servant à comprendre l’ADN et d’autres
composants d'organismes vivants. Pour analyser ces données, plus nombreuses et plus complexes aussi, les
scientifiques se sont tournés vers les nouvelles technologies de l’information. L'immense capacité de
stockage et d'analyse des données qu'offre l'informatique leur a permis de gagner en puissance pour leurs
recherches. La bioinformatique sert donc à stocker, traiter et analyser de grandes quantités de données de
biologie. Le but est de mieux comprendre et mieux connaître les phénomènes et processus biologiques.
Dans le domaine de la bioinformatique, la recherche de sous-chaîne de caractères, appelée motif, dans un
texte de taille très grande, était un composant important de beaucoup d’algorithmes. Puisqu’on travaille sur
des textes de tailles très importantes, on a toujours cette obsession de l’efficacité des algorithmes : moins on
à à faire de comparaisons, plus rapide sera l’exécution des algorithmes.
Le motif à rechercher, ainsi que le texte dans lequel on effectue la recherche, sont écrits dans un alphabet
composé de quatre caractères : 'A' , 'C' , 'G' et "T'. Ces caractères représentent les quatre bases de l’ADN :
Adénine, Cytosine, Guanine et Thymine.
Codage des caractères de l'alphabet
L’alphabet est composé de quatre caractères seulement : 'A', 'C', "G' et "1". Dans le but d’économiser la
mémoire, on peut utiliser un codage binaire réduit pour ces quatre caractères.
Q. 1 : Quel est le nombre minimum de bits nécessaires pour coder quatre éléments ?
Q. 2 : Donner un exemple de code binaire pour chaque caractère de cet alphabet.
Préfixe d’une chaîne de caractères
Un préfixe d’une chaîne de caractères S non vide, est une sous-chaîne non vide de S, composée de la
suite des caractères entre la première position de S et une certaine position dans S.
Exemples : S = 'TATCTAGCTA"
هآ كآ chaîne 'TAT' est un préfixe de TATCTAGCTA" ;
La chaîne "TATCTA'" est un préfixe de TATCTAGCTA" ;
La chaîne TATCTAGCTA' est un préfixe de TATCTAGCTA" ;
La chaîne 'T" est un préfixe de TATCTAGCTA" ;
La chaîne 'CTAGC'" n’est pas un préfixe de S.
يخ ايخ خخ
Q. 3 : Écrire une fonction prefixe (M, S), qui reçoit en paramètres deux chaînes de caractères M et 5 non
vides, et qui retourne True si la chaîne M est un préfixe de S, sinon, elle retourne False.
Page 5 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 6 —
Épreuve d’Informatique — Session 2018 — Filière MP
Q. 4 : Quel est le nombre de comparaisons élémentaires effectuées par la fonction prefixe (M, S), dans le
pire cas ? Déduire la complexité de la fonction prefixe (M, S), dans le pire cas.
Suffixe d’une chaîne de caractères
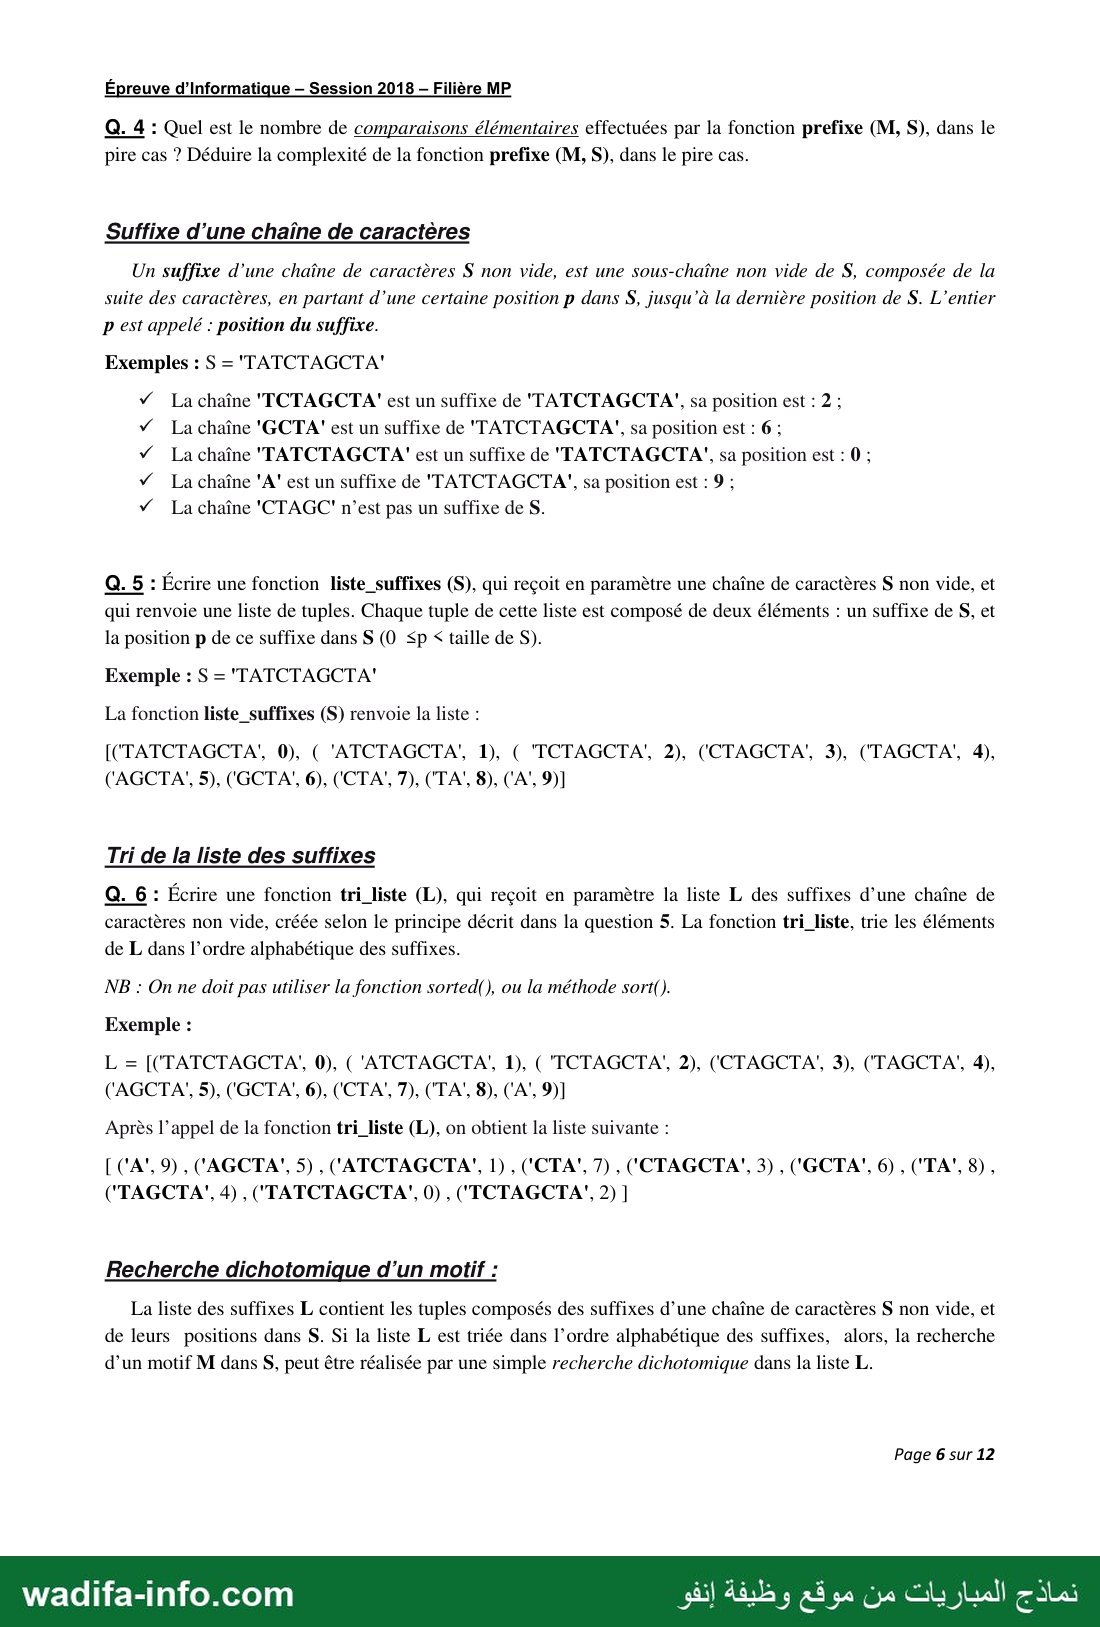
Un suffixe d’une chaîne de caractères S non vide, est une sous-chaîne non vide de S, composée de la
suite des caractères, en partant d’une certaine position p dans S, jusqu’à la dernière position de S. L’entier
p est appelé : position du suffixe.
Exemples : S = 'TATCTAGCTA"
v La chaîne 'TCTAGCTA" est un suffixe de TATCTAGCTA', sa position est : 2 ;
La chaîne "GCTA'" est un suffixe de TATCTAGCTA", sa position est : 6 ;
La chaîne "TATCTAGCTA" est un suffixe de TATCTAGCTA", sa position est : 0 ;
La chaîne 'A' est un suffixe de TATCTAGCTA", sa position est : 9 ;
La chaîne 'CTAGC' n’est pas un suffixe de S.
Q. 5 : Écrire une fonction liste_suffixes (S), qui reçoit en paramètre une chaîne de caractères S non vide, et
qui renvoie une liste de tuples. Chaque tuple de cette liste est composé de deux éléments : un suffixe de S, et
la position p de ce suffixe dans S (0 مك ‹ taille de S).
Exemple : S = TATCTAGCTA"
La fonction liste_suffixes (S) renvoie la liste :
[(TATCTAGCTA', 0), ( 'ATCTAGCTA', 1), ( TCTAGCTA' 2), (CTAGCTA', 3), (TAGCTA 4),
Tri de la liste des suffixes
Q. 6 : Écrire une fonction tri_liste (L), qui reçoit en paramètre la liste L des suffixes d’une chaîne de
caractères non vide, créée selon le principe décrit dans la question 5. La fonction tri_liste, trie les éléments
de L dans l’ordre alphabétique des suffixes.
NB : On ne doit pas utiliser la fonction sorted(), ou la méthode sort().
Exemple :
L = [((TATCTAGCTA 0), ('ATCTAGCTA’, 1), ( TCTAGCTA", 2), (CTAGCTA’, 3), (TAGCTA’ 4),
Après l’appel de la fonction tri_liste (L), on obtient la liste suivante :
(TAGCTA’, 4) , (TATCTAGCTA"', 0) , (TCTAGCTA", 2) ]
Recherche dichotomique d’un motif :
La liste des suffixes LL contient les tuples composés des suffixes d’une chaîne de caractères S non vide, et
de leurs positions dans S. Si la liste L est triée dans l’ordre alphabétique des suffixes, alors, la recherche
d’un motif M dans S, peut être réalisée par une simple recherche dichotomique dans la liste L.
Page 6 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 7 —
Épreuve d’Informatique — Session 2018 — Filière MP
Q. 7: Écrire une fonction recherche_dichotomique (M, L), qui utilise le principe de la recherche
dichotomique, pour rechercher le motif M dans la liste des suffixes L, triée dans l’ordre alphabétique des
suffixes : Si M est un préfixe d’un suffixe dans un tuple de L, alors la fonction retourne la position de ce
suffixe. Si la fonction ne trouve pas le motif M recherché, alors la fonction retourne None.
Exemple :
La liste des suffixes de TATCTAGCTA", triée dans l’ordre alphabétique des suffixes est :
(TAGCTA, 4), (TATCTAGCTA, 0), (TCTAGCTA, 2) ]
recherche_dichotomique ('CTA', L) renvoie la position 3: 'CTA' est préfixe de 'CTAGCTA' آ
recherche_dichotomique ('TA', L) renvoie la position 0 ; 'TA' est préfixe de TATCTAGCTA' آ
recherche_dichotomique ('"CAGT', L) renvoie None. ’CAGT” n'est préfixe d’aucun suffixe آ
Q. 8 : On pose m et k les tailles respectives de la chaîne M et la liste L. Déterminer, en fonction de m et k,
la complexité de la fonction recherche_dichotomique (M, L). Justifier votre réponse.
L’arbre des suffixes d’une chaîne de caractères :
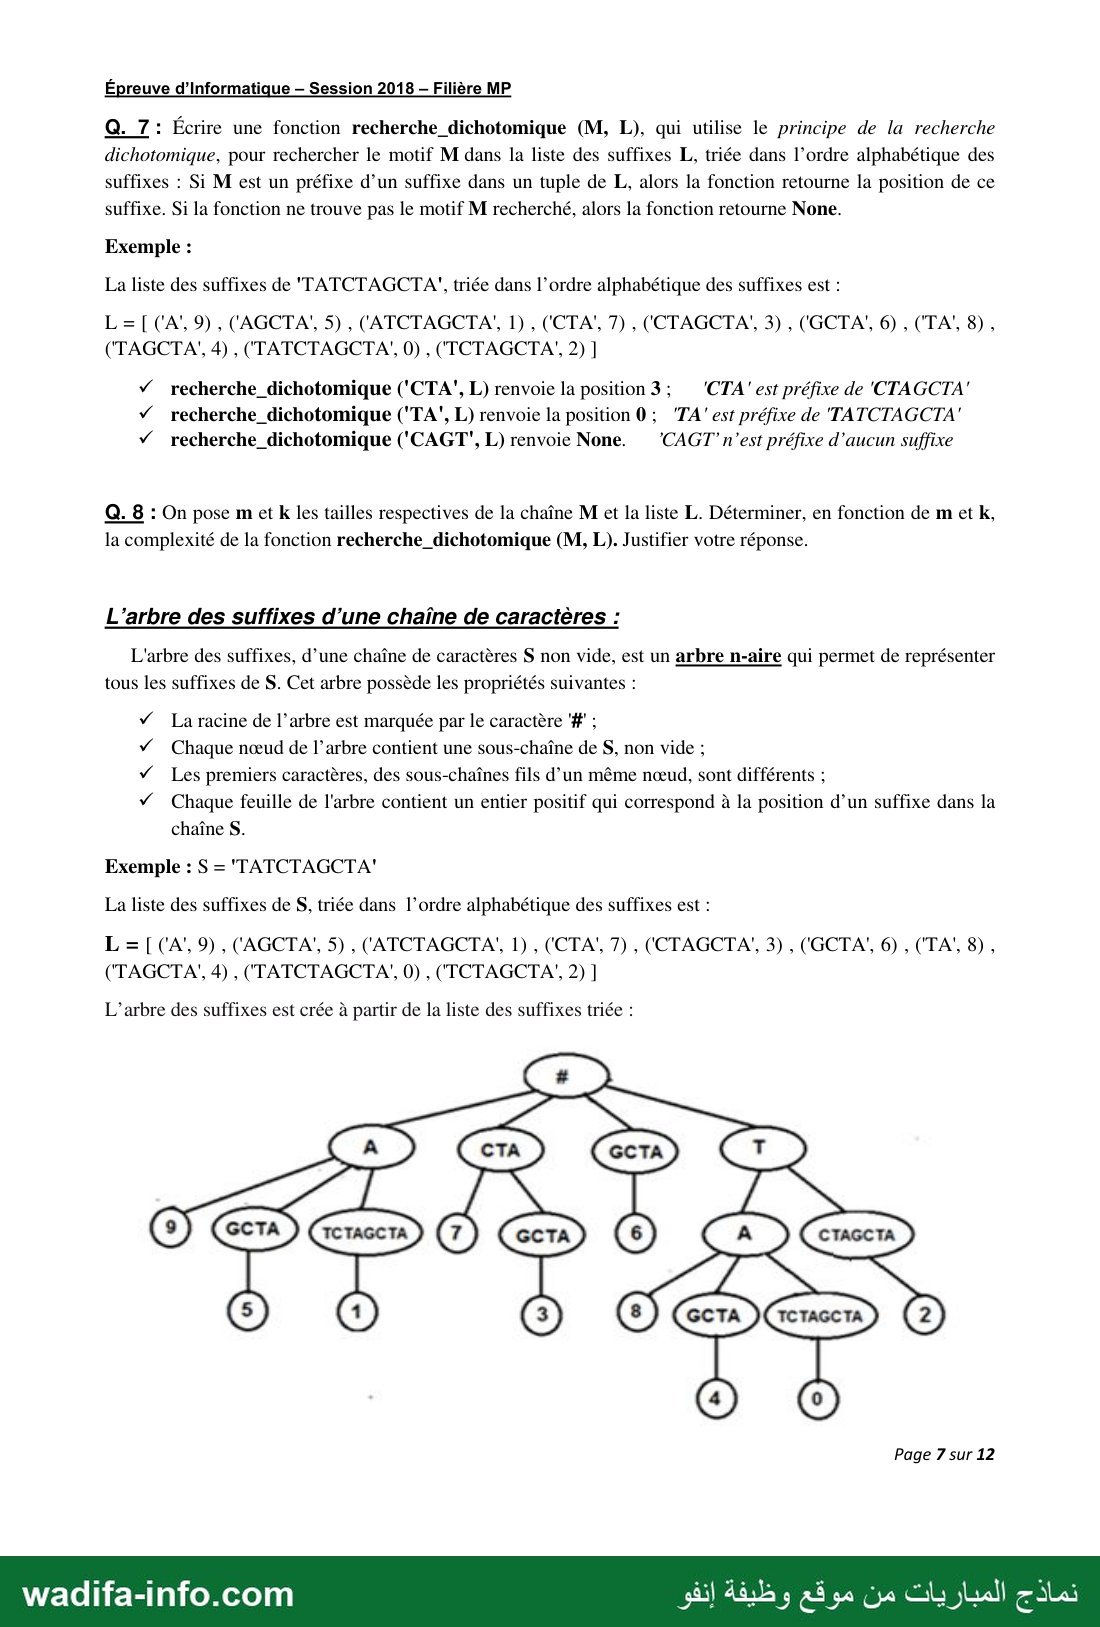
L'arbre des suffixes, d’une chaîne de caractères S non vide, est un arbre n-aire qui permet de représenter
tous les suffixes de S. Cet arbre possède les propriétés suivantes :
“La racine de l’arbre est marquée par le caractère # ;
Chaque nœud de l’arbre contient une sous-chaîne de S, non vide ;
Les premiers caractères, des sous-chaînes fils d’un même nœud, sont différents ;
Chaque feuille de l'arbre contient un entier positif qui correspond à la position d’un suffixe dans la
chaîne S.
Exemple : 5 = TATCTAGCTA"
يك ره ›
La liste des suffixes عل S, triée dans l’ordre alphabétique des suffixes est :
(TAGCTA, 4) , (TATCTAGCTA, 0) , (TCTAGCTA', 2) ]
L'arbre des suffixes est crée à partir de la liste des suffixes triée :
ED C2 زرخ زب
FC) وت © تعض © CAD Eee)
Page 7 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 8 —
Épreuve d’Informatique — Session 2018 — Filière MP
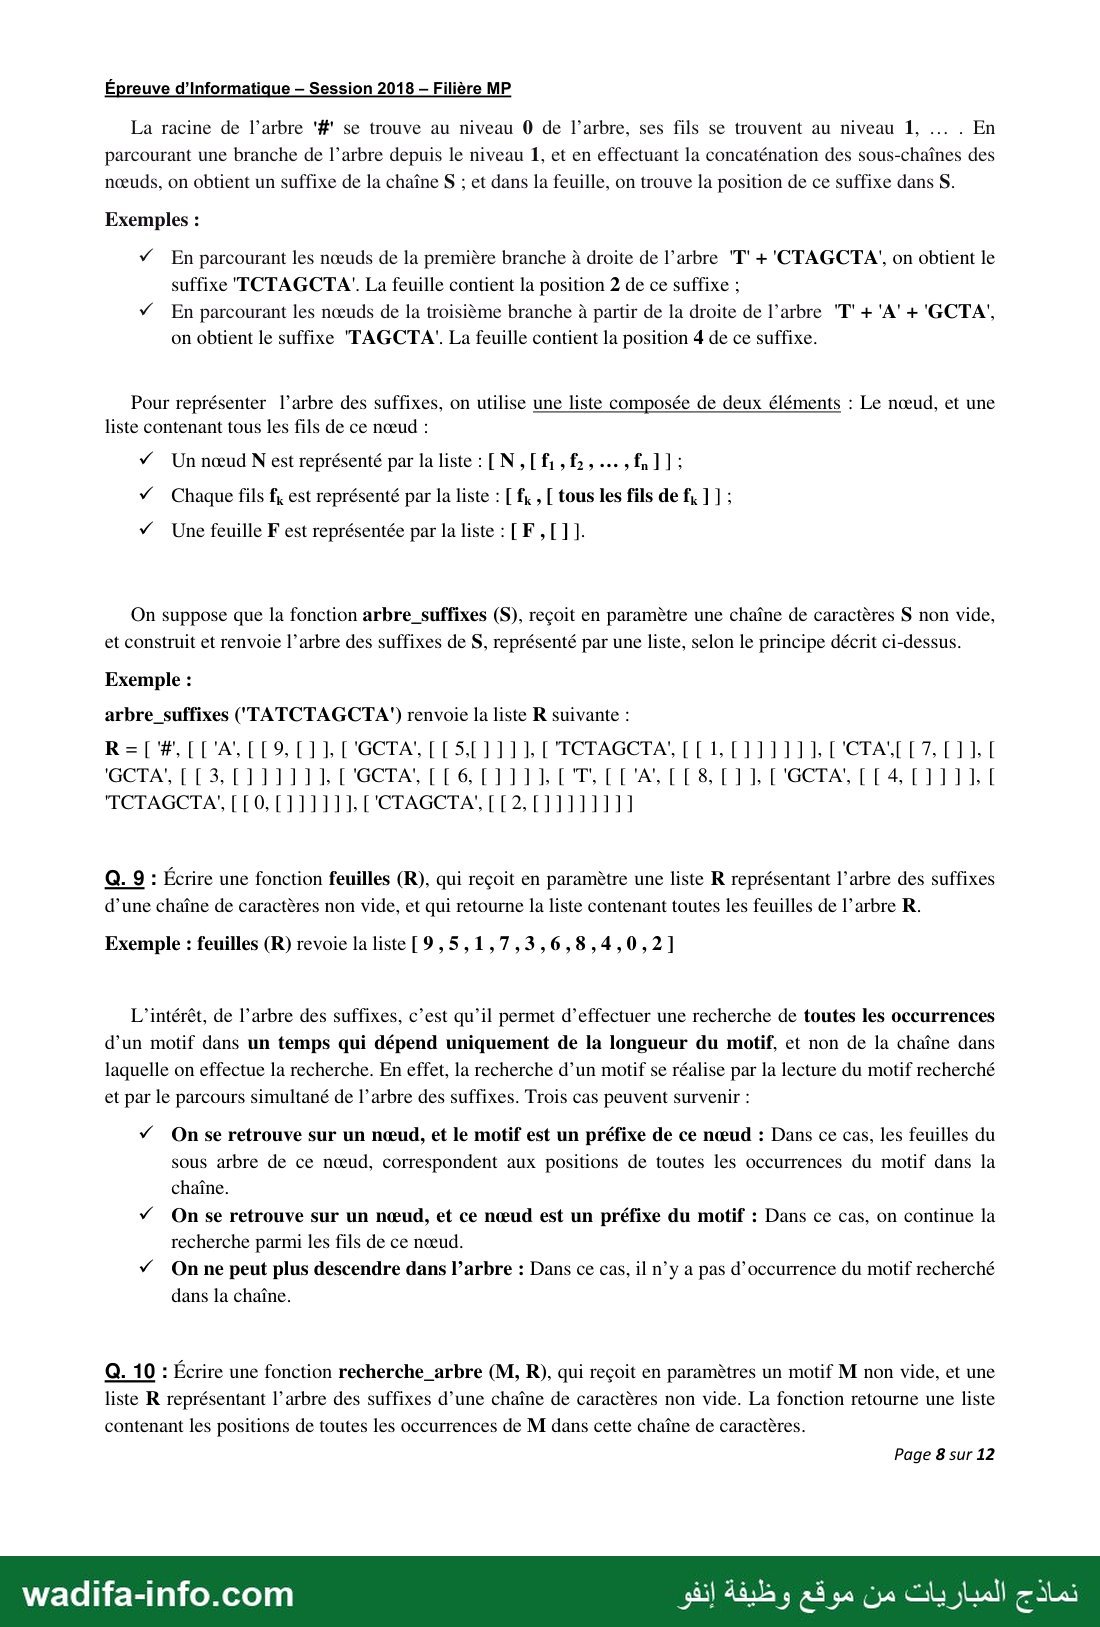
La racine de l'arbre '#' se trouve au niveau 0 de l’arbre, ses fils se trouvent au niveau 1, … . En
parcourant une branche de l’arbre depuis le niveau 1, et en effectuant la concaténation des sous-chaînes des
nœuds, on obtient un suffixe de la chaîne S ; et dans la feuille, on trouve la position de ce suffixe dans S.
Exemples :
En parcourant les nœuds de la première branche à droite de l’arbre 'T'+'CTAGCTA), on obtient le آ
suffixe TCTAGCTA". La feuille contient la position 2 de ce suffixe ;
y En parcourant les nœuds de la troisième branche à partir de la droite de l'arbre 'T' +'A' +'GCTA),
on obtient le suffixe TAGCTA". La feuille contient la position 4 de ce suffixe.
Pour représenter l’arbre des suffixes, on utilise une liste composée de deux éléments : Le nœud, et une
liste contenant tous les fils de ce nœud :
/ Un nœud N est représenté par la liste : ] N,[ f; , f2 5 …, fa 11 :
y Chaque fils f, est représenté par la liste : [ f, , [ tous les fils de f, ] ] :
7 Une feuille F est représentée par la liste : [ F,[]].
On suppose que la fonction arbre_suffixes (S), reçoit en paramètre une chaîne de caractères S non vide,
et construit et renvoie l’arbre des suffixes de S, représenté par une liste, selon le principe décrit ci-dessus.
Exemple :
arbre_suffixes ("TATCTAGCTA") renvoie la liste R suivante :
R=[#,[L'AS[[9 (11, L'GCTAS [[S.1111, ['TCTAGCTAS [[1,[111111 D'ÉTASIL7Z C1 1[
'GCTA, [[3,[111111 ['GCTAS [C6 (1111 (TS CL'AS CLS [1], ['GCTAS [4 CI11LN
‘TCTAGCTA’ [[0,[1111]1, ['CTAGCTA,[[2,[11111111
Q. 9 : Écrire une fonction feuilles (R), qui reçoit en paramètre une liste R représentant l’arbre des suffixes
d’une chaîne de caractères non vide, et qui retourne la liste contenant toutes les feuilles de l’arbre R.
Exemple : feuilles (R) revoie la liste [9,5,1,7,3,6,8,4,0,2]
L’intérêt, de l’arbre des suffixes, c’est qu’il permet d’effectuer une recherche de toutes les occurrences
d’un motif dans un temps qui dépend uniquement de la longueur du motif, et non de la chaîne dans
laquelle on effectue la recherche. En effet, la recherche d’un motif se réalise par la lecture du motif recherché
et par le parcours simultané de l’arbre des suffixes. Trois cas peuvent survenir :
7 On se retrouve sur un nœud, et le motif est un préfixe de ce nœud : Dans ce cas, les feuilles du
sous arbre de ce nœud, correspondent aux positions de toutes les occurrences du motif dans la
chaîne.
7 On se retrouve sur un nœud, et ce nœud est un préfixe du motif : Dans ce cas, on continue la
recherche parmi les fils de ce nœud.
7 On ne peut plus descendre dans l’arbre : Dans ce cas, il n’y a pas d’occurrence du motif recherché
dans la chaîne.
Q. 10 : Écrire une fonction recherche_arbre (M, R), qui reçoit en paramètres un motif M non vide, et une
liste R représentant l’arbre des suffixes d’une chaîne de caractères non vide. La fonction retourne une liste
contenant les positions de toutes les occurrences de M dans cette chaîne de caractères.
Page 8 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 9 —
Épreuve d’Informatique — Session 2018 - Filière MP
Exemples :
R est la liste qui représente l’arbre des suffixes de la chaîne 5 = TATCTAGCTA".
v recherche_arbre ('TA', R) renvoie la liste : ] 8,4,0]
آ recherche_arbre (TCTAG', R) renvoie la liste : [ 2 ]
آ recherche_arbre ('CTA', R) revoie la liste :[ 7,3]
Ÿ recherche_arbre (TACG', R) renvoie la liste : [ ]
Base de données d’un arbre des suffixes
Dans cette partie, on utilise une base de données pour stocker un arbre des suffixes d’une chaîne de
caractères S non vide. Pour identifier les nœuds de l’arbre, on donne un code unique pour chaque nœud :
› Chaque nœud interne est identifié par un entier positif unique supérieur à la taille de S ;
› Les feuilles de l’arbre sont les différentes positions p dans la chaîne S (0 ‹p ‹ taille de S). Chaque
feuille de l’arbre est identifiée par l’entier p qu’elle contient.
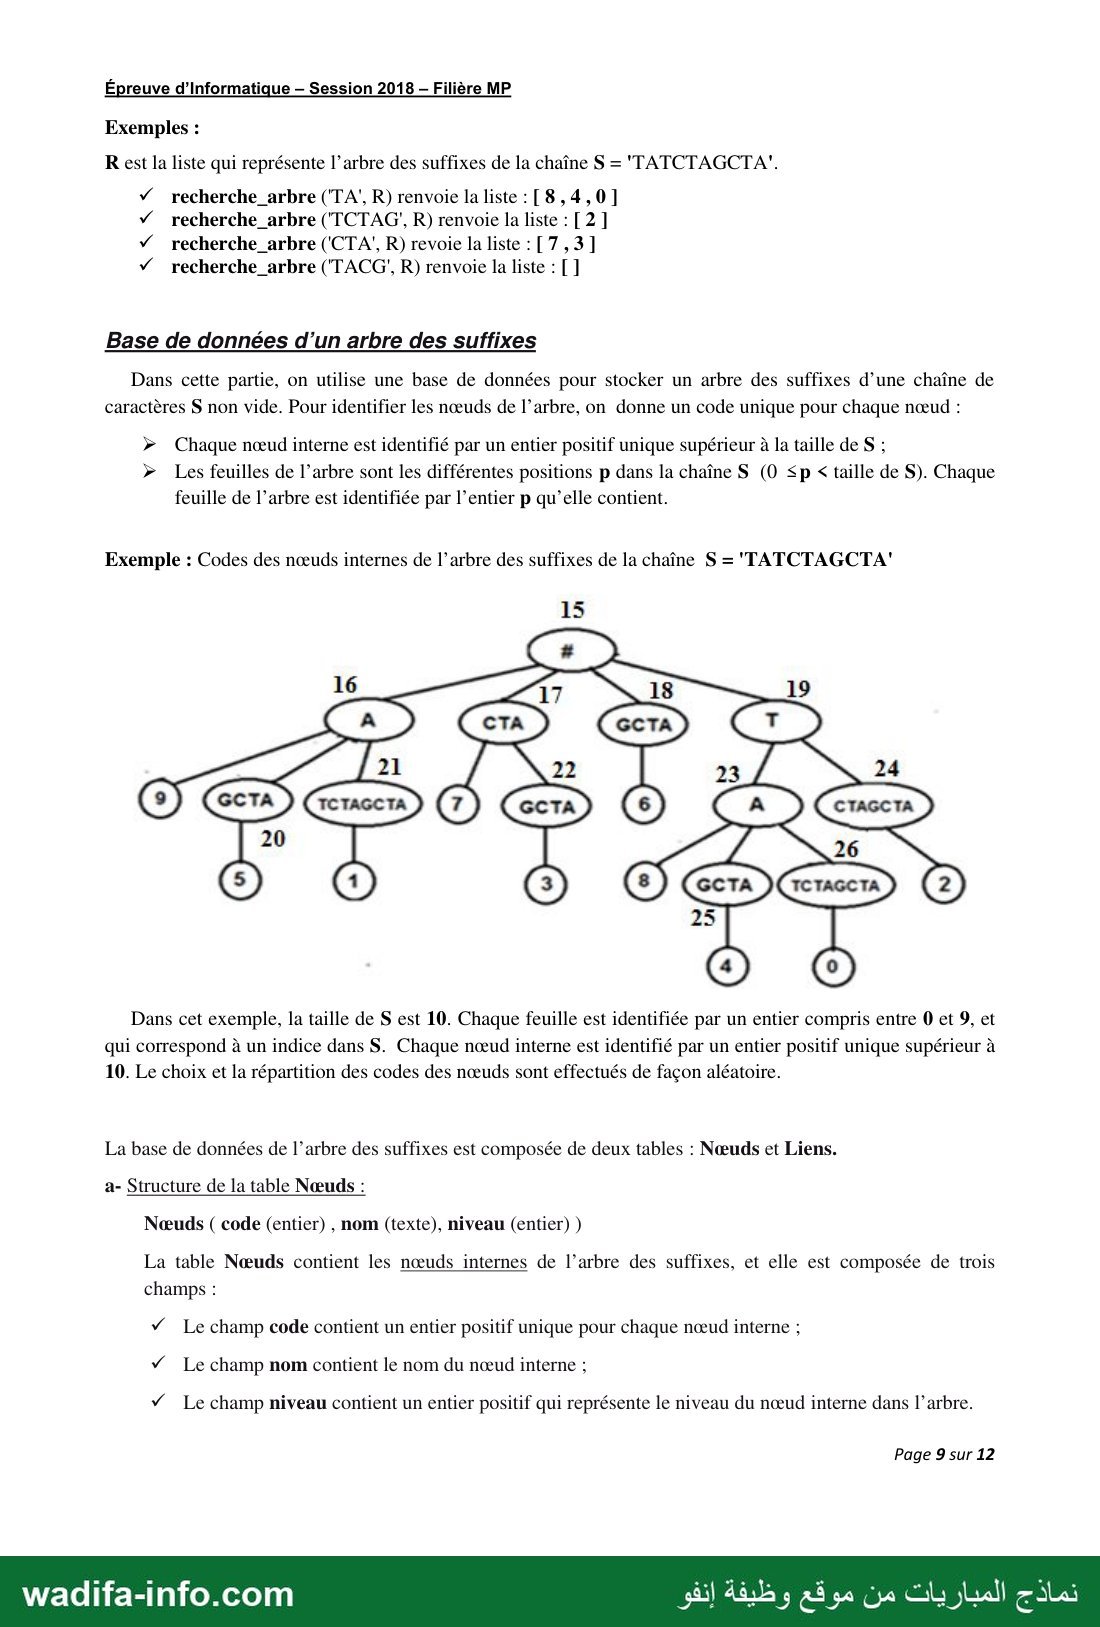
Exemple : Codes des nœuds internes de l’arbre des suffixes de la chaîne S = 'TATCTAGCTA"
15
16 17 18 19
+7 Cm d Em) CU
© Es E-» € Gr 0 وحم ا
0 0 © SEDE-D 0
Dans cet exemple, la taille عل S est 10. Chaque feuille est identifiée par un entier compris entre 0 et 9, et
qui correspond à un indice dans S. Chaque nœud interne est identifié par un entier positif unique supérieur à
10. Le choix et la répartition des codes des nœuds sont effectués de façon aléatoire.
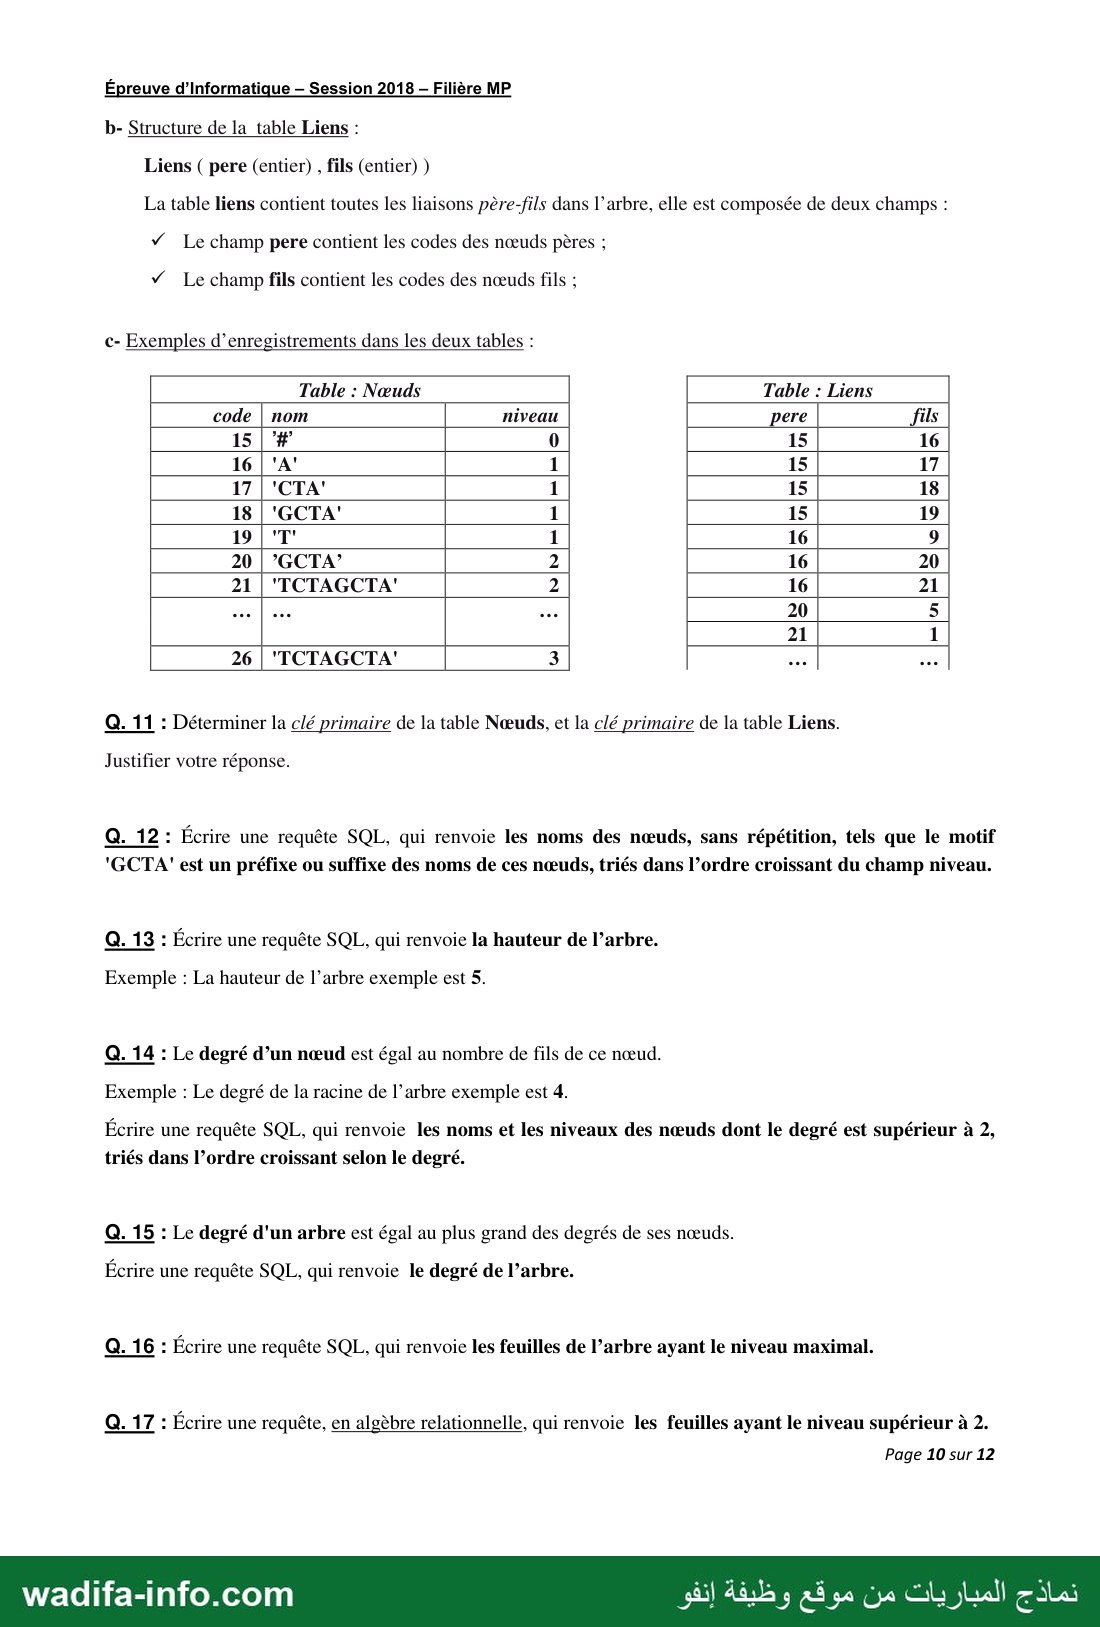
La base de données de l’arbre des suffixes est composée de deux tables : Nœuds et Liens.
a- Structure de la table Nœuds :
Nœuds ( code (entier) , nom (texte), niveau (entier) )
La table Nœuds contient les nœuds internes de l’arbre des suffixes, et elle est composée de trois
champs :
y Le champ code contient un entier positif unique pour chaque nœud interne ;
v Le champ nom contient le nom du nœud interne ;
y Le champ niveau contient un entier positif qui représente le niveau du nœud interne dans l'arbre.
Page 9 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 10 —
Épreuve d’Informatique — Session 2018 - Filière MP
b- Structure de la table Liens :
Liens ( pere (entier) , fils (entier) )
La table liens contient toutes les liaisons père-fils dans l’arbre, elle est composée de deux champs :
y Le champ pere contient les codes des nœuds pères ;
y Le champ fils contient les codes des nœuds fils ;
c- Exemples d’enregistrements dans les deux tables :
Table : Nœuds Table : Liens
26 | TCTAGCTA"
Q. 11 : Déterminer la clé primaire de la table Nœuds, et la clé primaire de la table Liens.
Justifier votre réponse.
Q. 12 : Écrire une requête SQL, qui renvoie les noms des nœuds, sans répétition, tels que le motif
'GCTA"' est un préfixe ou suffixe des noms de ces nœuds, triés dans l’ordre croissant du champ niveau.
Q. 13 : Écrire une requête SQL, qui renvoie la hauteur de l’arbre.
Exemple : La hauteur de l’arbre exemple est 5.
Q. 14 : Le degré d’un nœud est égal au nombre de fils de ce nœud.
Exemple : Le degré de la racine de l’arbre exemple est 4.
Écrire une requête SQL, qui renvoie les noms et les niveaux des nœuds dont le degré est supérieur à 2,
triés dans l’ordre croissant selon le degré.
Q. 15 : Le degré d'un arbre est égal au plus grand des degrés de ses nœuds.
Écrire une requête SQL, qui renvoie le degré de l’arbre.
Q. 16 : Écrire une requête SQL, qui renvoie les feuilles de l’arbre ayant le niveau maximal.
Q. 17 : Écrire une requête, en algèbre relationnelle, qui renvoie les feuilles ayant le niveau supérieur à 2.
Page 10 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 11 —
Épreuve d’Informatique — Session 2018 — Filière MP
Plus long motif commun
Le problème du plus long motif commun à deux chaînes de caractères P et Q non vides, consiste à
déterminer le (ou les) plus long motif qui est en même temps sous-chaîne de P et de Q. Ce problème se
généralise à la recherche du plus long motif commun à plusieurs chaînes de caractères.
Pour rechercher le plus long motif commun à deux chaînes de caractères P et Q non vides, on commence
par créer une matrice M remplie par des zéros : Le nombre de lignes de M est égal à la taille de P, et le
nombre de colonnes de M est égal à la taille de Q. Ensuite, on compare les caractères de P avec ceux de Q,
et on écrit le nombre de caractères successifs identiques, dans la case correspondante de la matrice M.
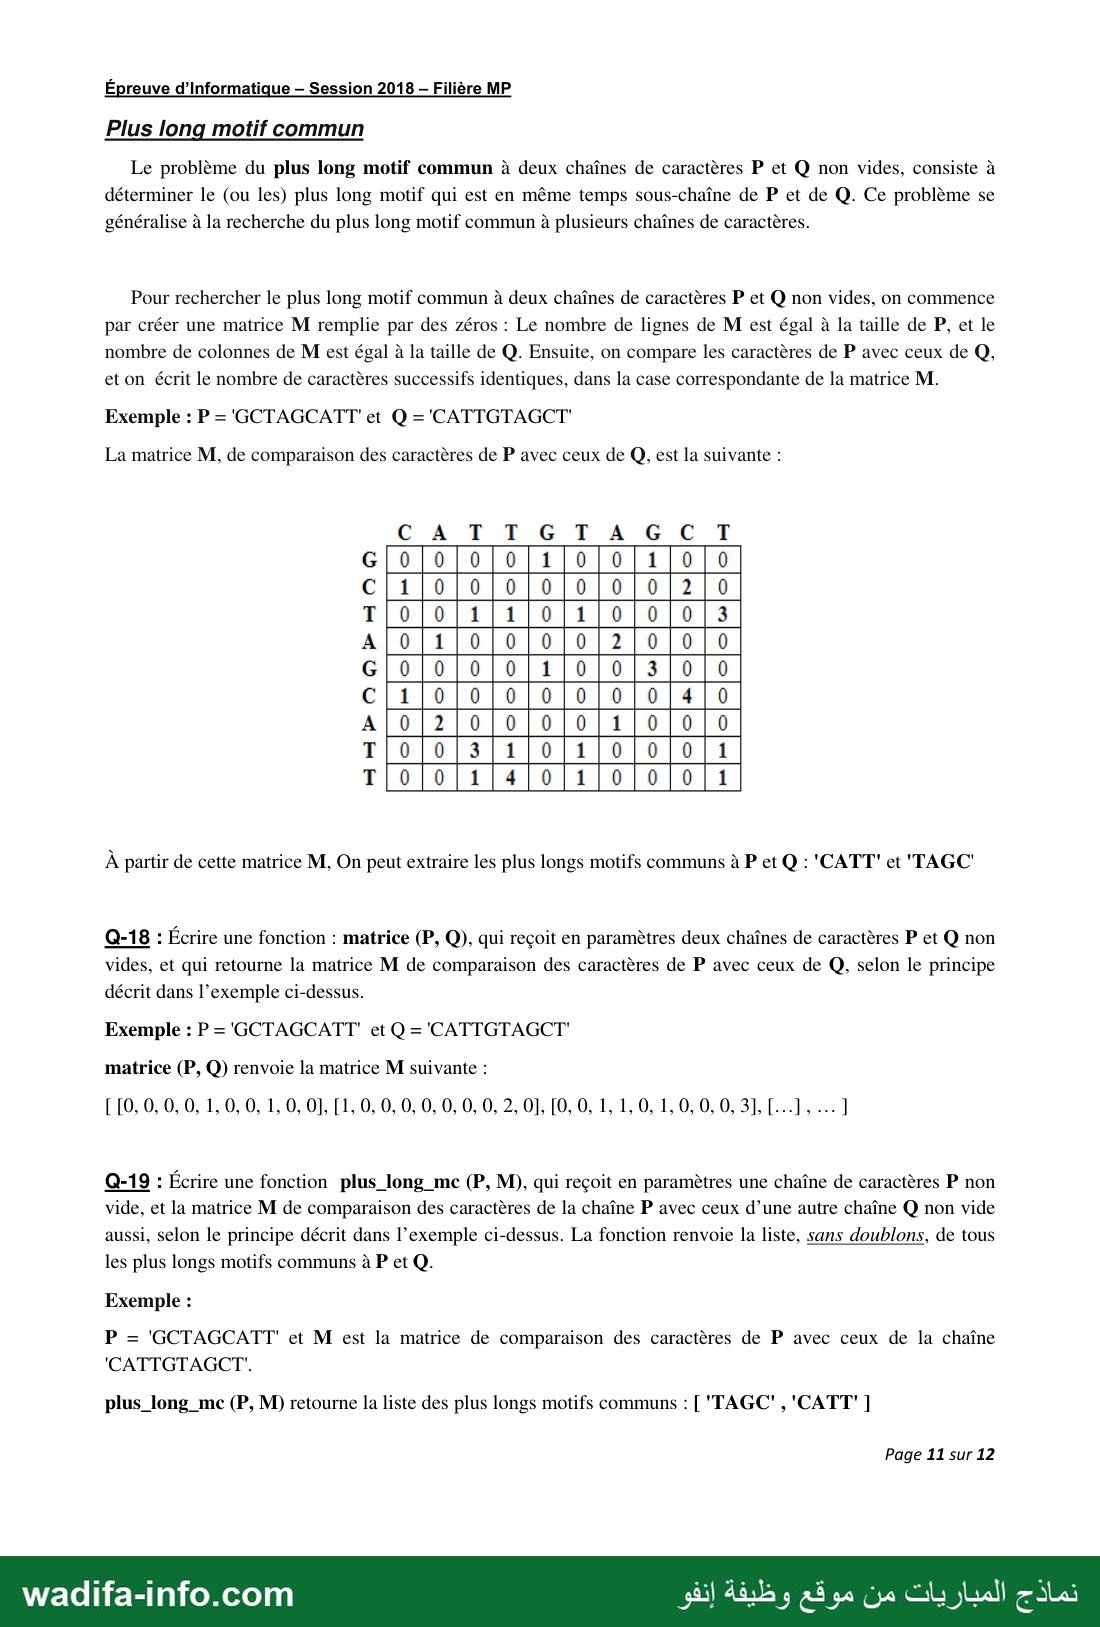
Exemple : P='GCTAGCATT'et Q ='CATTGTAGCT"
La matrice M, de comparaison des caractères de P avec ceux de Q, est la suivante :
T pofofiisto[rtotolo]r
À partir de cette matrice M, On peut extraire les plus longs motifs communs à P et Q : 'CATT" et 14620
Q-18 : Écrire une fonction : matrice (P, Q), qui reçoit en paramètres deux chaînes de caractères P et Q non
vides, et qui retourne la matrice M de comparaison des caractères de P avec ceux de Q, selon le principe
décrit dans l’exemple ci-dessus.
Exemple : P='GCTAGCATT' et Q ='CATTGTAGCT"
matrice (P, Q) renvoie la matrice M suivante :
Q-19 : Écrire une fonction plus_long_me (P, M), qui reçoit en paramètres une chaîne de caractères P non
vide, et la matrice M de comparaison des caractères de la chaîne P avec ceux d’une autre chaîne Q non vide
aussi, selon le principe décrit dans l’exemple ci-dessus. La fonction renvoie la liste, sans doublons, de tous
les plus longs motifs communs à P et Q.
Exemple :
P = 'GCTAGCATT' et M est la matrice de comparaison des caractères de P avec ceux de la chaîne
'CATTGTAGCT'.
plus_long_mc (P, M) retourne la liste des plus longs motifs communs : ['TAGC' , 'CATT' ]
Page 11 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 12 —
Épreuve d’Iinformatique — Session 2018 — Filière MP
Plus long motif commun dans un fichier
On considère le fichier texte dont le chemin absolu est : 'C:\génomes.txt'. On suppose que ce fichier
contient au moins deux lignes.
Q-20 : Écrire le code python qui permet d’afficher les plus longs motifs communs, à toutes les lignes de ce
fichier texte, sans doublons.
Exemple :
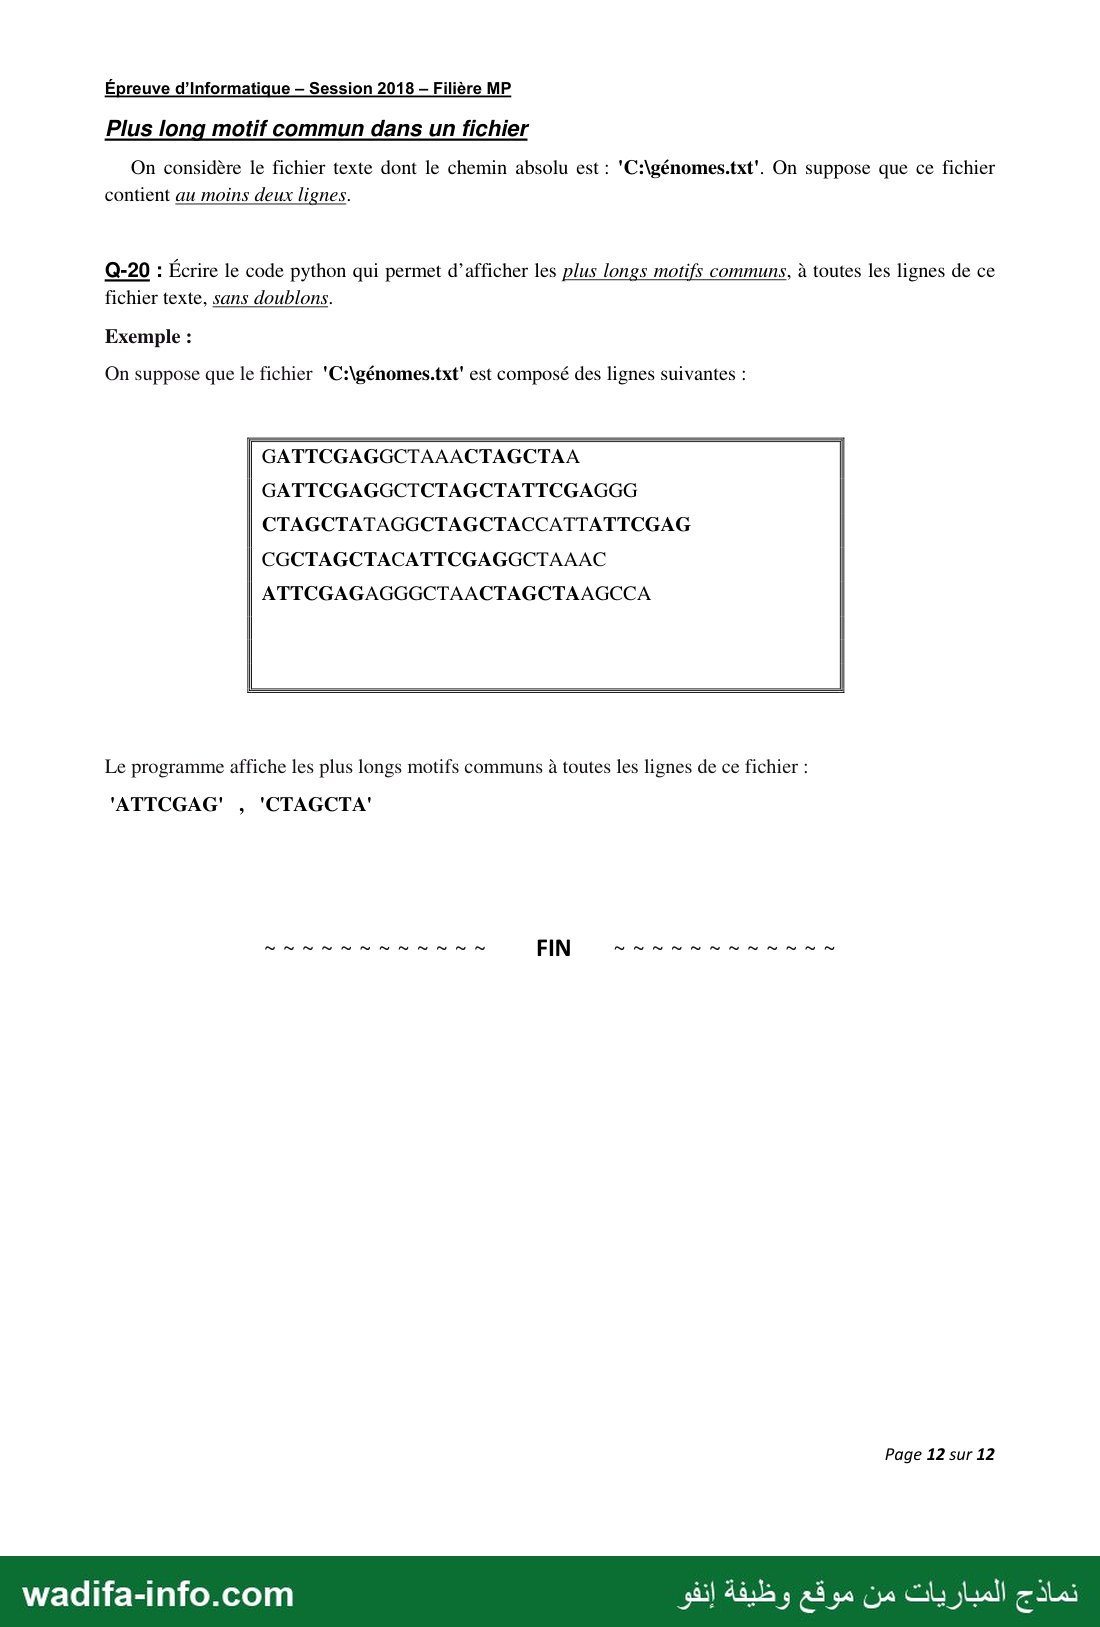
On suppose que le fichier 'C:\génomes.txt' est composé des lignes suivantes :
GATTCGAGGCTAAACTAGCTAA
GATTCGAGGCTCTAGCTATTCGAGGG
CTAGCTATAGGCTAGCTACCATTATTCGAG
CGCTAGCTACATTCGAGGCTAAAC
ATTCGAGAGGGCTAACTAGCTAAGCCA
Le programme affiche les plus longs motifs communs à toutes les lignes de ce fichier :
'ATTCGAG' , 'CTAGCTA’'
Page 12 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
✅ Correction proposée
Il s'agit d'une correction proposée, rédigée par l'équipe wadifa-info pour vous aider à comprendre la méthode — ce n'est pas un corrigé officiel de l'administration organisatrice.
Cette épreuve est l'épreuve d'Informatique du Concours National Commun (CNC) 2018, filière MP, commune aux écoles d'ingénieurs marocaines après les classes préparatoires (CPGE). Le sujet fait 12 pages et comprend deux parties indépendantes, toutes deux en Python. La partie I (calcul numérique) porte sur le schéma prédicteur-correcteur d'Adams-Bashforth / Adams-Moulton d'ordre 2, appliqué à un oscillateur harmonique amorti. La partie II (bioinformatique) traite de la recherche de motif dans l'ADN : préfixes, suffixes, tri, recherche dichotomique, arbre des suffixes, base de données SQL, algèbre relationnelle et plus long motif commun. La durée et le coefficient ne sont pas indiqués sur les pages scannées. C'est un problème de programmation et de bases de données. Voici une correction méthodologique proposée.
💡 Avant de commencer : les questions sont presque toutes indépendantes et l'énoncé donne des exemples chiffrés. Servez-vous-en pour vérifier chaque fonction « à la main ». Attention au piège de la partie I : from numpy import * remplace les fonctions max, min, all, sum… de Python par celles de NumPy. Dans la partie II, écrivez des boucles explicites. Les codes ci-dessous ont été testés sur les exemples de l'énoncé et redonnent exactement les résultats attendus.
Partie I : Méthode d'Adams-Bashforth / Adams-Moulton
Q1. Fonction ABM2(f, a, b, y0, h)
Le schéma prédicteur-correcteur procède en trois temps :
- y1 est obtenu par Euler : y1 = y0 + h f(t0, y0) ;
- pour n ≥ 1, on prédit k = yn + h/2 (3f(tn, yn) − f(tn−1, yn−1)) (Adams-Bashforth) ;
- on corrige ensuite : yn+1 = yn + h/2 (f(tn, yn) + f(tn+1, k)) (Adams-Moulton).
La fonction marche aussi quand y est un tableau NumPy, c'est-à-dire pour un système différentiel, ce qui sera utile dès Q2.
def ABM2(f, a, b, y0, h):
n = int(round((b - a) / h))
T = linspace(a, b, n + 1)
Y = [y0, y0 + h * f(a, y0)] # y1 par Euler
for i in range(1, n):
fp = f(T[i-1], Y[i-1])
fn = f(T[i], Y[i])
k = Y[i] + h/2 * (3*fn - fp) # prédicteur AB2
Y.append(Y[i] + h/2 * (fn + f(T[i+1], k))) # correcteur AM2
return T, Y
Complexité : O(n) avec n = (b − a)/h, et 3 évaluations de f par pas. On pourrait n'en faire que 2 en mémorisant f(tn, yn) d'un pas à l'autre.
Q2. Mise sous la forme z' = G(t, z)
On pose z = (y, y'). L'équation (E) s'écrit m y'' + b y' + k y = F(t), avec F = 0, b = 1, k = 12,5 et m = 1,5. On obtient :
z' = G(t, z) = ( z1 , −(b z1 + k z0)/m ) = ( z1 , −(z1 + 12,5 z0)/1,5 )
b, k, m = 1, 12.5, 1.5
def G(t, z):
return array([z[1], -(b*z[1] + k*z[0]) / m])
Q3. Tracé de y(t), toutes les 10-3 s
Pour lire les conditions initiales sur la courbe de l'énoncé, on observe que y(0) = −0,3 (l'objet est tiré vers le bas, et l'axe est orienté vers le haut). Le lâcher sans vitesse donne y'(0) = 0. L'intervalle de temps est [0, 8] et le pas h = 10-3.
T, Z = ABM2(G, 0, 8, array([-0.3, 0.0]), 1e-3)
P = [z[0] for z in Z] # positions y(t)
plot(T, P, 'k', label='y(t)')
grid(); legend(); show()
Contrôle physique : ω02 = k/m ≈ 8,33 et λ = b/(2m) = 1/3. La pseudo-pulsation vaut ω = √(ω02 − λ2) ≈ 2,87 rad/s, d'où une demi-pseudo-période π/ω ≈ 1,096 s. C'est bien l'écart entre deux zéros de la question suivante. Le premier maximum simulé vaut environ 0,208, en accord avec la figure.
Q4. Fonction racines(P)
Idée : y s'annule entre ti et ti+1 lorsque P[i] × P[i+1] < 0, ou lorsque P[i] = 0. Avec un pas de 10-3, ti+1 arrondi à 3 décimales approche le zéro à 10-3 près.
def racines(P):
h = 1e-3
for i in range(len(P) - 1):
if P[i] == 0 or P[i] * P[i+1] < 0:
print(round((i + 1) * h, 3), end=' , ')
Ce code, appliqué aux positions calculées en Q3, affiche exactement 0.589 , 1.684 , 2.78 , 3.875 , 4.971 , 6.067 , 7.162.
Partie II : Bioinformatique, recherche d'un motif
Q1. Nombre minimum de bits
Avec b bits, on code 2b éléments. Il faut 2b ≥ 4, donc 2 bits.
Q2. Exemple de codage
A = 00, C = 01, G = 10, T = 11. Tout codage injectif sur 2 bits convient.
Q3. prefixe(M, S)
def prefixe(M, S):
if len(M) > len(S):
return False
for i in range(len(M)):
if M[i] != S[i]:
return False
return True
Q4. Complexité de prefixe
Le pire cas se produit quand M est un préfixe de S, ou quand M diffère seulement au dernier caractère. On effectue alors m = len(M) comparaisons de caractères, plus une comparaison de longueurs. La complexité dans le pire cas est O(m), et elle ne dépend pas de la longueur de S.
Q5. liste_suffixes(S)
def liste_suffixes(S):
return [(S[p:], p) for p in range(len(S))]
Q6. tri_liste(L) sans sort ni sorted
On utilise un tri par insertion sur la première composante du tuple. En Python, la comparaison de chaînes avec < et > suit l'ordre alphabétique (lexicographique).
def tri_liste(L):
for i in range(1, len(L)):
x = L[i]
j = i - 1
while j >= 0 and L[j][0] > x[0]:
L[j+1] = L[j]
j -= 1
L[j+1] = x
return L
Le tri se fait en place (et la liste est aussi renvoyée). Son coût est de O(n2) comparaisons de chaînes. Un tri fusion donnerait O(n log n) comparaisons.
Q7. recherche_dichotomique(M, L)
Idée : si L est triée, les préfixes de longueur m des suffixes, L[i][0][:m], restent triés. On fait donc une dichotomie en comparant M à ces préfixes, sur un intervalle semi-ouvert [d, f[.
def recherche_dichotomique(M, L):
d, f = 0, len(L)
while d < f:
mil = (d + f) // 2
s = L[mil][0][:len(M)]
if s == M:
return L[mil][1]
elif M < s:
f = mil
else:
d = mil + 1
return None
Vérification sur l'exemple : 'CTA' → 3, 'TA' → 0 (on tombe d'abord sur l'indice 8, 'TATCTAGCTA') et 'CAGT' → None. Les valeurs attendues sont retrouvées.
Q8. Complexité de la recherche dichotomique
L'intervalle de recherche est divisé par 2 à chaque tour, ce qui donne au plus ⌊log2 k⌋ + 1 itérations. Chaque itération extrait puis compare une chaîne d'au plus m caractères, pour un coût O(m). La complexité est donc O(m log k).
Q9. feuilles(R)
Un nœud est une liste [valeur, fils]. C'est une feuille quand la liste de ses fils est vide. On fait un parcours en profondeur, de gauche à droite.
def feuilles(R):
if R[1] == []:
return [R[0]]
res = []
for f in R[1]:
res = res + feuilles(f)
return res
Sur l'arbre R de l'énoncé, on obtient [9, 5, 1, 7, 3, 6, 8, 4, 0, 2].
Q10. recherche_arbre(M, R)
On applique les trois cas de l'énoncé aux fils du nœud courant. Les feuilles, qui sont des entiers, sont ignorées. Comme deux fils ne commencent jamais par le même caractère, au plus un fils peut convenir.
def recherche_arbre(M, R):
for f in R[1]:
n = f[0]
if type(n) == str:
if prefixe(M, n): # M préfixe du nœud
return feuilles(f)
if prefixe(n, M): # nœud préfixe de M
return recherche_arbre(M[len(n):], f)
return [] # on ne peut plus descendre
Tests : 'TA' → [8, 4, 0] ; 'TCTAG' → [2] ; 'CTA' → [7, 3] ; 'TACG' → []. Ce sont les résultats de l'énoncé. Le coût de la descente dépend de la longueur de M et non de celle de S, à quoi s'ajoute le parcours final des feuilles trouvées.
Q11. Clés primaires
- Nœuds : clé primaire = code. Chaque nœud interne a un code unique, alors que nom se répète ('GCTA' apparaît plusieurs fois) et niveau aussi.
- Liens : clé primaire = fils. Dans un arbre, chaque nœud autre que la racine a un seul père, donc fils identifie une ligne de façon unique, alors que pere se répète. Le couple (pere, fils) est aussi unique, mais il n'est pas minimal. On l'accepte généralement si la justification est donnée.
Q12. Noms ayant 'GCTA' comme préfixe ou suffixe, triés par niveau
SELECT nom FROM Noeuds
WHERE nom LIKE 'GCTA%' OR nom LIKE '%GCTA'
GROUP BY nom
ORDER BY MIN(niveau);
Le GROUP BY élimine les doublons, comme un DISTINCT, et permet quand même de trier sur le niveau, qui n'est pas projeté. Sur l'exemple, on obtient GCTA, CTAGCTA, TCTAGCTA. La forme SELECT DISTINCT nom … ORDER BY niveau est acceptée par SQLite, mais elle n'est pas conforme à la norme SQL.
Q13. Hauteur de l'arbre
La table Nœuds ne contient que les nœuds internes. Un nœud interne de niveau maximal n'a que des feuilles pour fils, au niveau max + 1. La hauteur, comptée en nombre de niveaux (5 dans l'exemple, niveaux 0 à 4), vaut donc max(niveau) + 2.
SELECT MAX(niveau) + 2 AS hauteur FROM Noeuds;
Dans l'exemple, max(niveau) = 3, ce qui donne bien 5.
Q14. Nœuds de degré supérieur à 2
SELECT n.nom, n.niveau
FROM Noeuds n JOIN Liens l ON n.code = l.pere
GROUP BY n.code, n.nom, n.niveau
HAVING COUNT(*) > 2
ORDER BY COUNT(*);
Sur l'exemple : ('A', 1) et ('A', 2), qui ont chacun 3 fils, puis ('#', 0), qui en a 4.
Q15. Degré de l'arbre
SELECT MAX(d) FROM (SELECT COUNT(*) AS d FROM Liens GROUP BY pere) AS t;
Sur l'exemple, le résultat est 4.
Q16. Feuilles de niveau maximal
Une feuille est un fils qui n'est pas dans Nœuds, et son niveau est celui de son père + 1. Les feuilles les plus profondes sont donc les fils des nœuds internes de niveau maximal.
SELECT l.fils
FROM Liens l JOIN Noeuds n ON l.pere = n.code
WHERE l.fils NOT IN (SELECT code FROM Noeuds)
AND n.niveau = (SELECT MAX(niveau) FROM Noeuds);
Sur l'exemple, on obtient les feuilles 4 et 0.
Q17. Algèbre relationnelle : feuilles de niveau supérieur à 2
Le niveau d'une feuille est supérieur à 2 si et seulement si le niveau de son père est supérieur ou égal à 2. On sélectionne les fils de ces pères, puis on retire les nœuds internes :
πfils( σniveau ≥ 2( Liens ⋈pere = code Noeuds ) ) − ρcode→fils( πcode(Noeuds) )
Sur l'exemple, le résultat est {5, 1, 3, 8, 2, 4, 0}.
Q18. matrice(P, Q)
Si P[i] = Q[j], alors M[i][j] = M[i−1][j−1] + 1, ou 1 lorsque i = 0 ou j = 0. Sinon, M[i][j] = 0. M[i][j] est ainsi la longueur du plus long motif commun qui se termine en P[i] et en Q[j].
def matrice(P, Q):
M = [[0] * len(Q) for i in range(len(P))]
for i in range(len(P)):
for j in range(len(Q)):
if P[i] == Q[j]:
if i > 0 and j > 0:
M[i][j] = M[i-1][j-1] + 1
else:
M[i][j] = 1
return M
Les trois premières lignes obtenues sont bien [0,0,0,0,1,0,0,1,0,0], [1,0,0,0,0,0,0,0,2,0] et [0,0,1,1,0,1,0,0,0,3]. La complexité est O(|P| × |Q|).
Q19. plus_long_mc(P, M)
On cherche le maximum mx de la matrice. Chaque case (i, j) qui vaut mx correspond au motif P[i−mx+1 : i+1].
def plus_long_mc(P, M):
mx = 0
for ligne in M:
for v in ligne:
if v > mx:
mx = v
res = []
if mx == 0:
return res
for i in range(len(M)):
for j in range(len(M[i])):
if M[i][j] == mx:
motif = P[i-mx+1 : i+1]
if motif not in res:
res.append(motif)
return res
Sur l'exemple, le résultat est ['TAGC', 'CATT'], dans l'ordre de l'énoncé.
Q20. Plus longs motifs communs à toutes les lignes du fichier
Il faut éviter un piège : le plus long motif commun à toutes les lignes n'est pas forcément un plus long motif commun aux deux premières. La méthode sûre consiste à parcourir les sous-chaînes de la ligne la plus courte, de la plus longue à la plus courte. On garde celles qui figurent dans toutes les lignes, et on s'arrête à la première longueur qui donne un résultat.
f = open('C:\\génomes.txt', 'r')
lignes = [l.strip() for l in f.readlines() if l.strip() != '']
f.close()
ref = lignes[0]
for l in lignes:
if len(l) < len(ref):
ref = l
for lg in range(len(ref), 0, -1):
res = []
for i in range(len(ref) - lg + 1):
m = ref[i:i+lg]
if m not in res:
ok = True
for l in lignes:
if m not in l:
ok = False
if ok:
res.append(m)
if res != []:
print(res)
break
Sur le fichier exemple, le programme affiche ['ATTCGAG', 'CTAGCTA'], comme attendu. Ne pas oublier de doubler l'antislash du chemin (ou d'utiliser r'C:\génomes.txt'). Selon l'encodage du fichier, il peut être nécessaire d'ajouter encoding='utf-8'. On aurait aussi pu généraliser Q18–Q19 ligne par ligne, mais il faudrait alors conserver tous les motifs communs et non seulement les plus longs.
💡 À retenir pour le CNC Informatique MP : les schémas numériques (Euler, RK, Adams, prédicteur-correcteur) et la vectorisation d'une équation d'ordre 2 en système z' = G(t, z) ; le tracé avec matplotlib ; les tris sans sort (insertion, fusion) avec leur complexité ; la recherche dichotomique en O(m log k) ; la récursivité sur les arbres représentés par des listes [nœud, fils] ; le SQL avec jointures, GROUP BY / HAVING, sous-requêtes, LIKE et agrégats sur agrégats ; l'algèbre relationnelle (σ, π, ⋈, −, ρ) ; la programmation dynamique (matrice de plus long motif commun) ; la lecture de fichiers texte. Testez toujours vos fonctions sur l'exemple de l'énoncé, et signalez tout choix d'interprétation sur la copie.
Questions fréquentes sur ce sujet
Ce sujet est-il téléchargeable gratuitement ?
Le corrigé est-il inclus ?
Quel organisme et quel grade concerne ce sujet ?
De quelle session s'agit-il et dans quelle langue ?
Où trouver d'autres sujets du même concours ?
Vous préparez ce concours ?
Modèles similaires
Source : concours d'accès aux écoles et instituts supérieurs — document archivé tel que reçu ; l'avis officiel du concours fait foi.
}📎 Citer cette page
Journaliste, blogueur, enseignant : copiez la référence ci-dessous et mettez un lien vers cette page.
Adresse permanente : https://www.wadifa-info.com/fr/modele-concours/1640/modele-de-concours-cnc-2018-informatique-mp-concours-national-commun
