نموذج مباراة ولوج السنة الأولى من سلك المهندسين GLSID بالمدرسة العليا لأساتذة التعليم التقني بالمحمدية (ENSET) - شتنبر 2014 - اختبار المعلوميات
باختصار
هذا نموذج امتحان كتابي سابق لمباراة السنة الأولى من سلك المهندس - مسلك GLSID لدى المدرسة العليا لأساتذة التعليم التقني بالمحمدية (ENSET) (session de septembre 2014)، منشور على وظيفة إنفو للاطلاع والتحميل المجاني بصيغة PDF مع تصحيح مقترح.
- الجهة المنظمة
- المدرسة العليا لأساتذة التعليم التقني بالمحمدية (ENSET)
- الدرجة
- السنة الأولى من سلك المهندس - مسلك GLSID
- التخصص
- المعلوميات (GLSID)
- الدورة
- session de septembre 2014
- عدد الصفحات
- 7
- لغة الأسئلة
- الفرنسية
- التصحيح
- تصحيح مقترح متوفر في هذه الصفحة
📝 نص أسئلة النموذج (مستخرج آلياً من الصفحات الممسوحة)
استُخرج هذا النص آلياً من صور الامتحان وقد يحتوي على أخطاء في القراءة — الصور أعلاه هي المرجع.
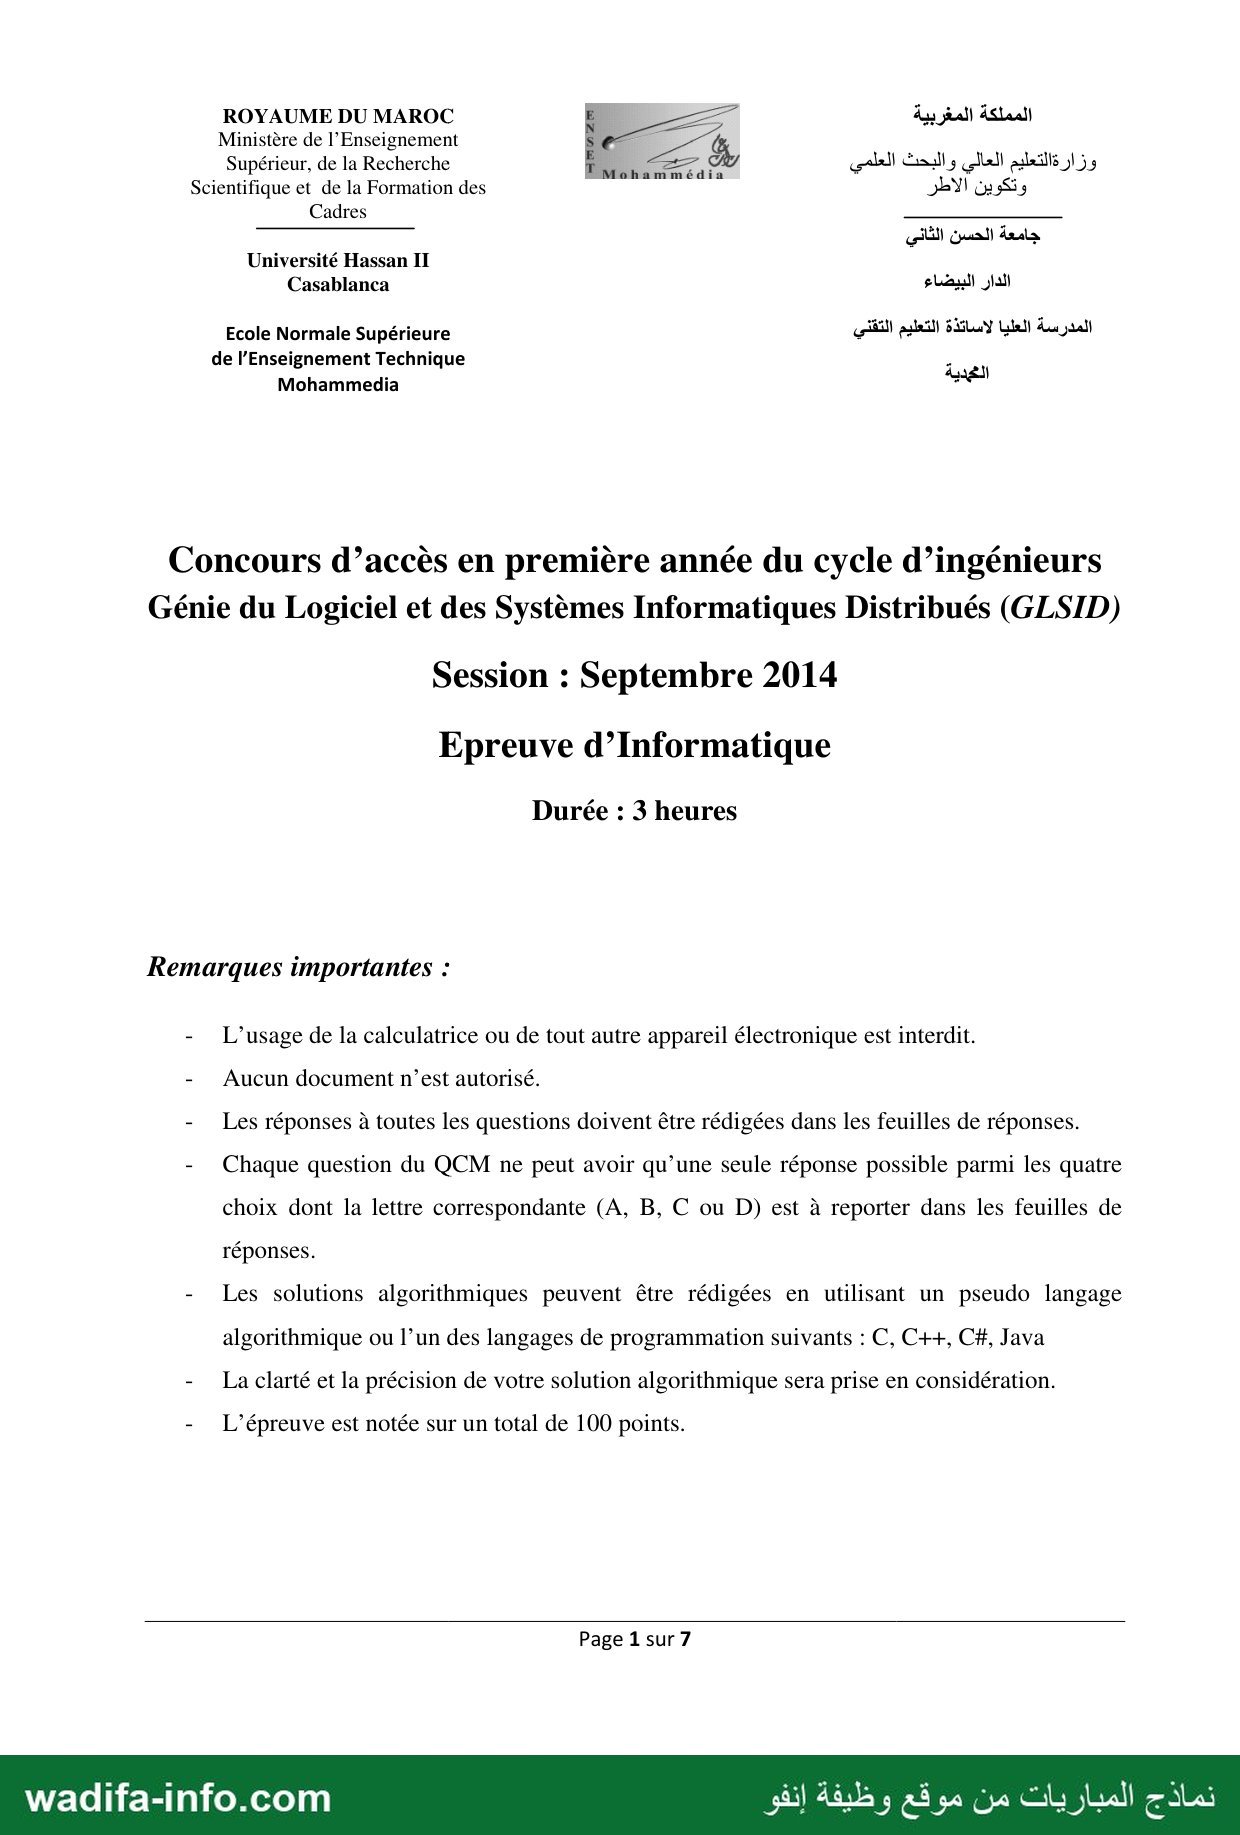
ROYAUME DU MAROC E 2 المملكة المغربية
Ministère de l'Enseignement V 1
Supérieur, de la Recherche D ==. وزارةالتعليم العالي والبحث العلمي
Scientifique et de la Formation des وتكوين الاطر
Cadres A
— جامعة الحسن الثاني
Université Hassan 1
Casablanca الدار البيضاء
Ecole Normale Supérieure المدرسة العليا لاساتذة التعليم التقني
de l’Enseignement Technique 5
Mohammedia العهدية
Concours d’accès en première année du cycle d’ingénieurs
Génie du Logiciel et des Systèmes Informatiques Distribués (GLSID)
Session : Septembre 2014
Epreuve d’Informatique
Durée : 3 heures
Remarques importantes :
- L'usage de la calculatrice ou de tout autre appareil électronique est interdit.
- Aucun document n’est autorisé.
- Les réponses à toutes les questions doivent être rédigées dans les feuilles de réponses.
- Chaque question du QCM ne peut avoir qu’une seule réponse possible parmi les quatre
choix dont la lettre correspondante (A, B, C ou D) est à reporter dans les feuilles de
réponses.
- Les solutions algorithmiques peuvent être rédigées en utilisant un pseudo langage
algorithmique ou l’un des langages de programmation suivants : C, C++, C#, Java
- La clarté et la précision de votre solution algorithmique sera prise en considération.
- L'épreuve est notée sur un total de 100 points.
Page 1 sur 7
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
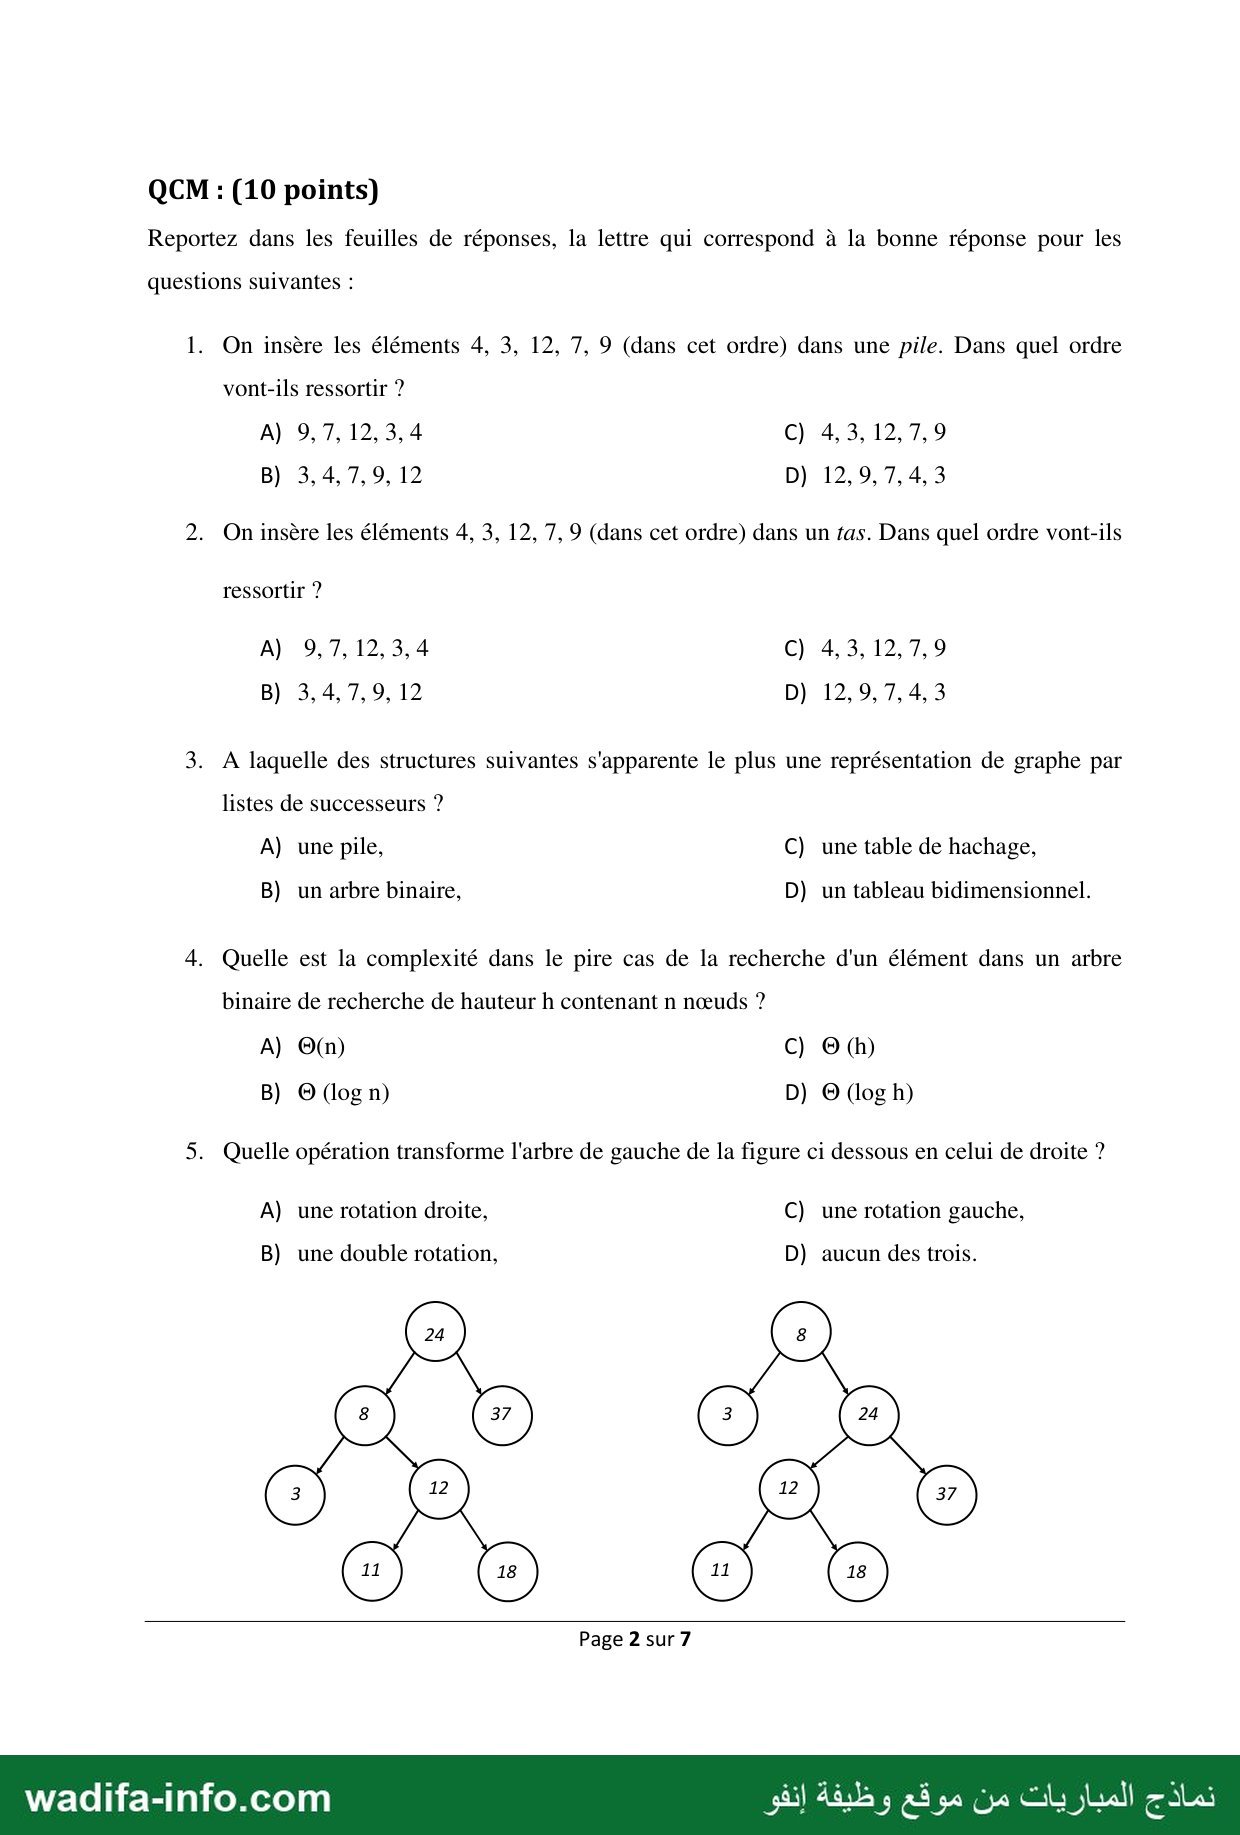
QCM: (10 points)
Reportez dans les feuilles de réponses, la lettre qui correspond à la bonne réponse pour les
questions suivantes :
1. On insère les éléments 4, 3, 12, 7, 9 (dans cet ordre) dans une pile. Dans quel ordre
vont-ils ressortir ?
A) 9,7, 4 0 4,3, 12,7,9
B) 3,4,7,9, 12 D) 12,9,7,4,3
2. On insère les éléments 4, 3, 12, 7, 9 (dans cet ordre) dans un fas. Dans quel ordre vont-ils
ressortir ?
A) 9,7,12,3,4 0 4,3, 12,7,9
B) 3,4,7,9, 12 D) 12,9, 7,43
3. A laquelle des structures suivantes s'apparente le plus une représentation de graphe par
listes de successeurs ?
A) une pile, C) une table de hachage,
B) un arbre binaire, D) un tableau bidimensionnel.
4. Quelle est la complexité dans le pire cas de la recherche d'un élément dans un arbre
binaire de recherche de hauteur h contenant n nœuds ?
A) @(n) C) © (h)
B) © (log n) D) © (log h)
5. Quelle opération transforme l'arbre de gauche de la figure له dessous en celui de droite ?
A) une rotation droite, C) une rotation gauche,
B) une double rotation, D) aucun des trois.
Page 2 sur 7
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
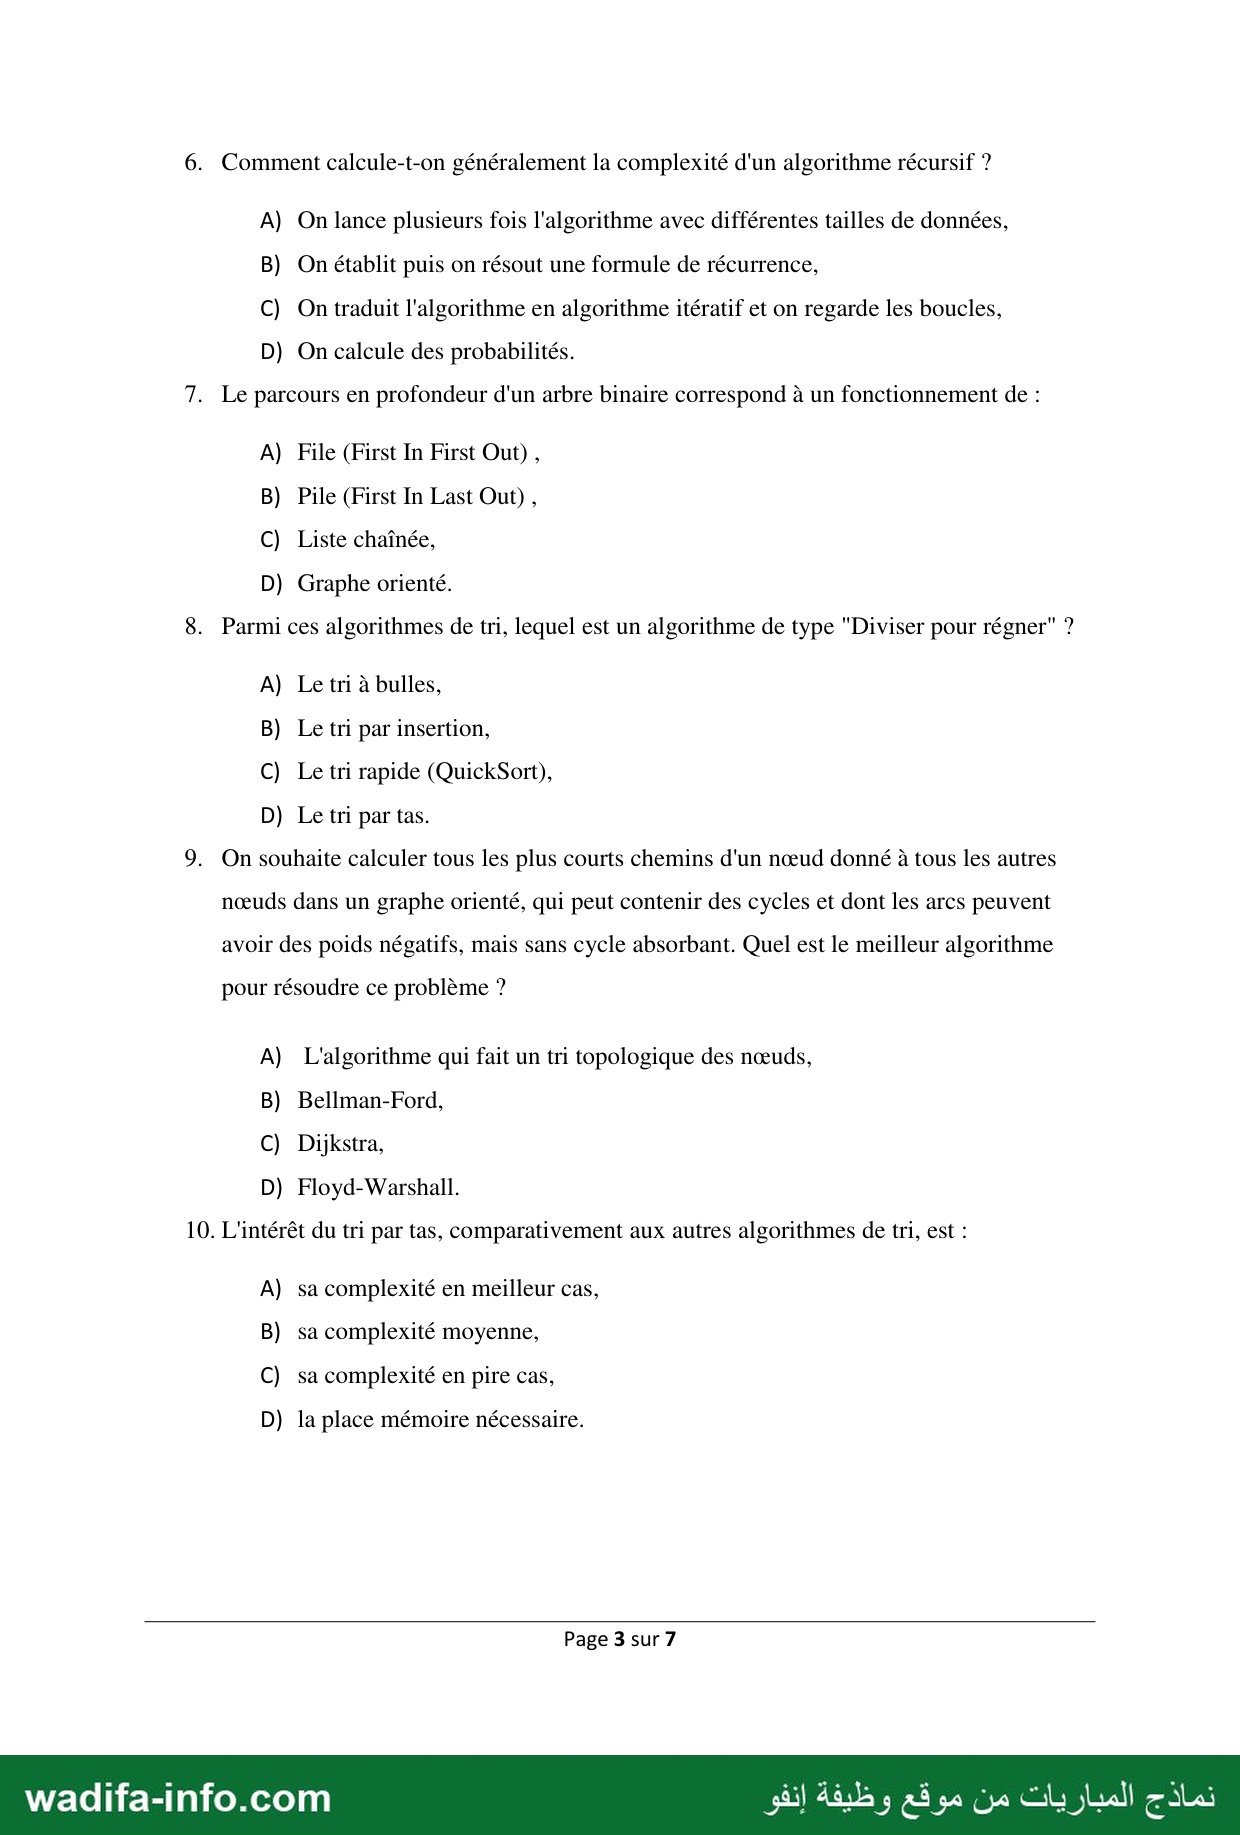
6. Comment calcule-t-on généralement la complexité d'un algorithme récursif ?
A) On lance plusieurs fois l'algorithme avec différentes tailles de données,
B) On établit puis on résout une formule de récurrence,
C) On traduit l'algorithme en algorithme itératif et on regarde les boucles,
D) On calcule des probabilités.
7. Le parcours en profondeur d'un arbre binaire correspond à un fonctionnement de :
A) File (First In First Out),
B) Pile (First In Last Out),
C) Liste chaînée,
D) Graphe orienté.
8. Parmi ces algorithmes de tri, lequel est un algorithme de type "Diviser pour régner" 7
A) Le tri à bulles,
B) Le tri par insertion,
C) Le tri rapide (QuickSort),
D) Le tri par tas.
9. On souhaite calculer tous les plus courts chemins d'un nœud donné à tous les autres
nœuds dans un graphe orienté, qui peut contenir des cycles et dont les arcs peuvent
avoir des poids négatifs, mais sans cycle absorbant. Quel est le meilleur algorithme
pour résoudre ce problème ?
A) L'algorithme qui fait un tri topologique des nœuds,
B) Bellman-Ford,
C) Dijkstra,
D) Floyd-Warshall.
10. L'intérêt du tri par tas, comparativement aux autres algorithmes de tri, est :
A) sa complexité en meilleur cas,
B) sa complexité moyenne,
C) sa complexité en pire cas,
D) la place mémoire nécessaire.
Page السو
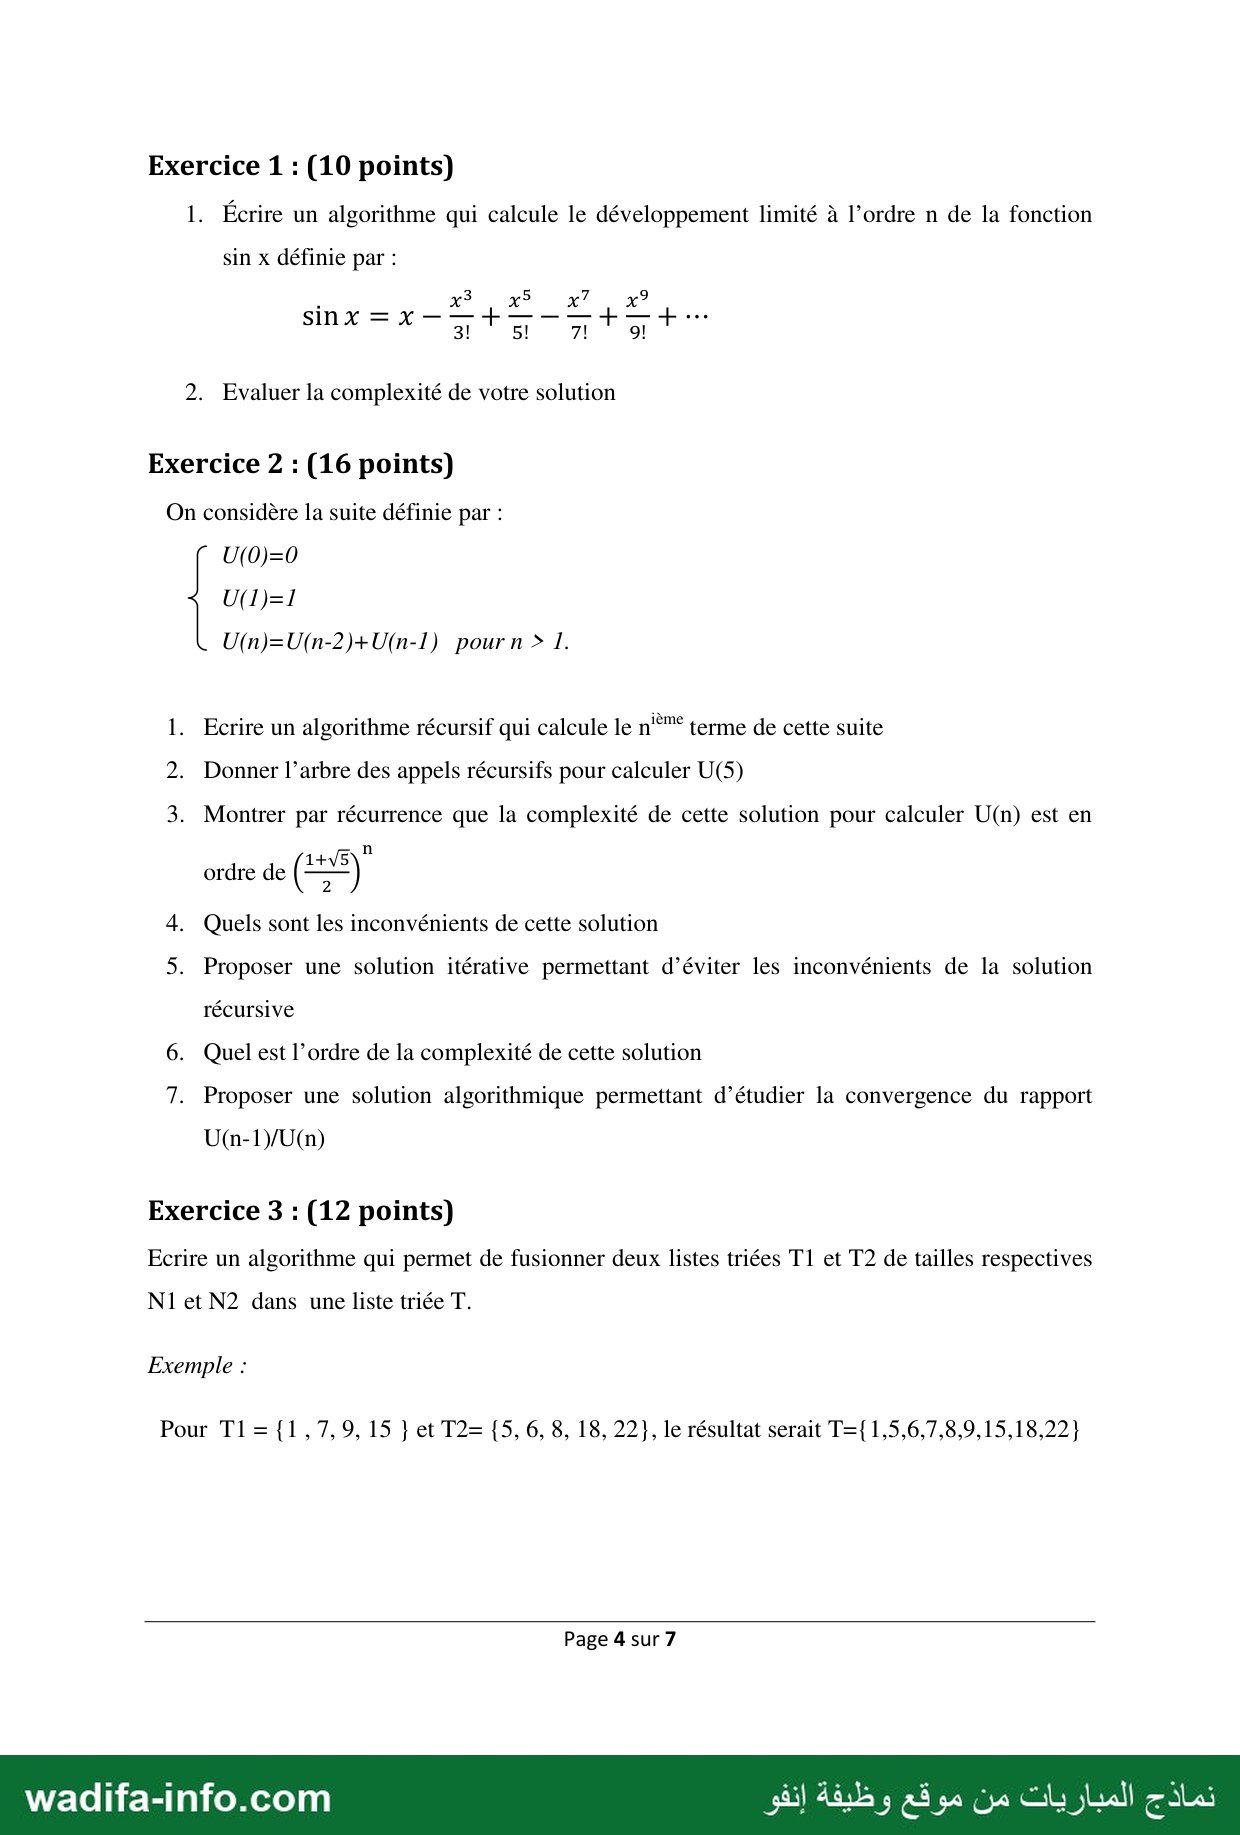
Exercice 1 : (10 points)
1. Écrire un algorithme qui calcule le développement limité à l’ordre n de la fonction
sin x définie par :
: قب LA ÀT - x
sin X = X — 5 + FRE + 5 اتاد
2. Evaluer la complexité de votre solution
Exercice 2 : (16 points)
On considère la suite définie par :
U(0)=0
U(1)=1
U(n)=U(n-2)+U(n-1) pour n > 1.
1. Ecrire un algorithme récursif qui calcule le “كو terme de cette suite
2. Donner l’arbre des appels récursifs pour calculer (3)نا
3. Montrer par récurrence que la complexité de cette solution pour calculer U(n) est en
1+V5\°
ordre de (=)
4. Quels sont les inconvénients de cette solution
5. Proposer une solution itérative permettant d'éviter les inconvénients de la solution
récursive
6. Quel est l’ordre de la complexité de cette solution
7. Proposer une solution algorithmique permettant d'étudier la convergence du rapport
U(n-1/U(n)
Exercice 3 : (12 points)
Ecrire un algorithme qui permet de fusionner deux listes triées T1 et T2 de tailles respectives
Net N2 dans une liste triée T.
Exemple :
Pour T1=1{1,7,9, 15 } et T2= {5, 6, 8, 18, 22}, le résultat serait T={1,5,6,7,8,9,15,18,22}
Page 4 sur 7
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
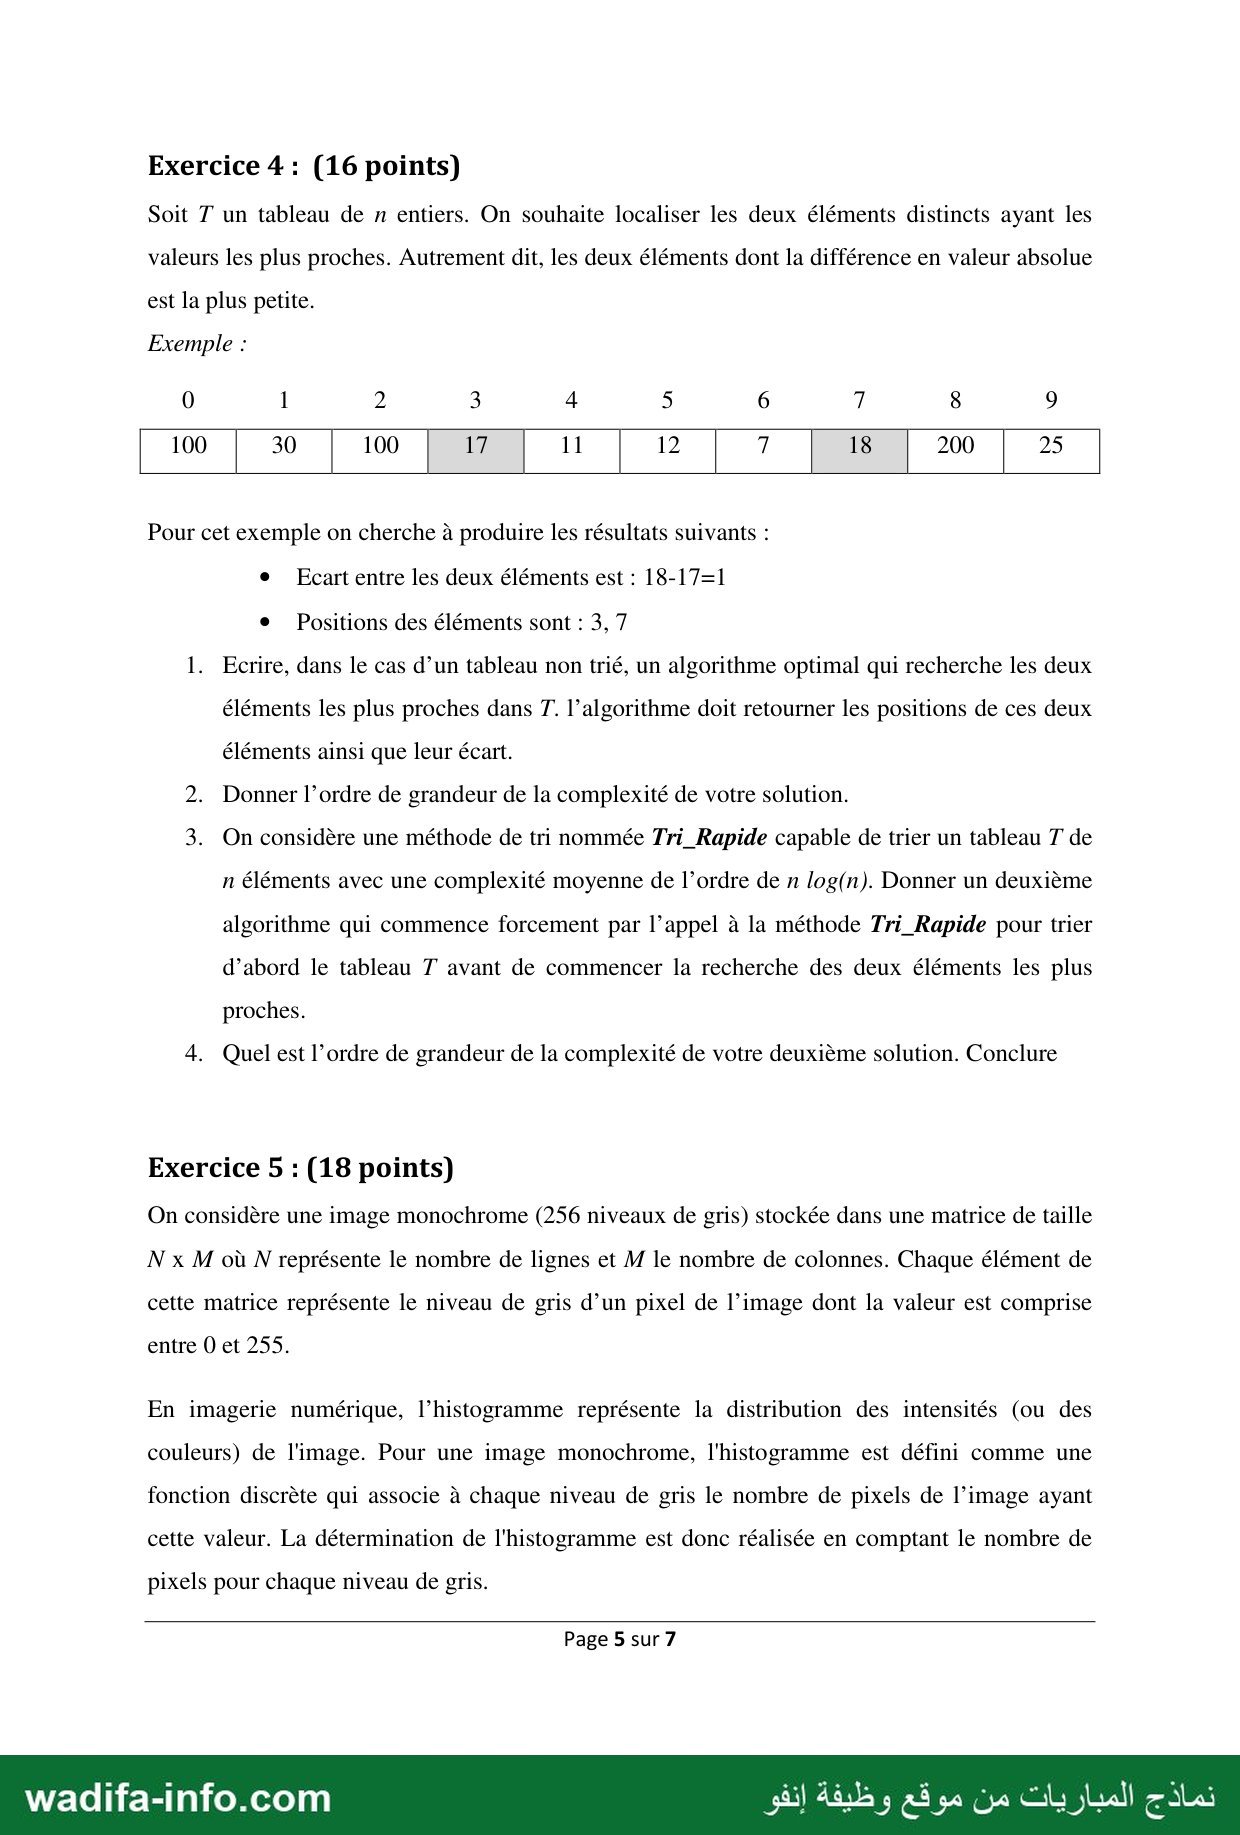
Exercice 4 : (16 points)
Soit 7 un tableau de n entiers. On souhaite localiser les deux éléments distincts ayant les
valeurs les plus proches. Autrement dit, les deux éléments dont la différence en valeur absolue
est la plus petite.
Exemple :
0 1 2 3 4 5 6 7 8 9
Pour cet exemple on cherche à produire les résultats suivants :
e Ecart entre les deux éléments est : 18-17=1
e Positions des éléments sont : 3,7
1. Ecrire, dans le cas d’un tableau non trié, un algorithme optimal qui recherche les deux
éléments les plus proches dans 7. l’algorithme doit retourner les positions de ces deux
éléments ainsi que leur écart.
2. Donner l’ordre de grandeur de la complexité de votre solution.
3. On considère une méthode de tri nommée Tri_Rapide capable de trier un tableau T de
n éléments avec une complexité moyenne de l’ordre de n log(n). Donner un deuxième
algorithme qui commence forcement par l’appel à la méthode Tri_Rapide pour trier
d’abord le tableau T avant de commencer la recherche des deux éléments les plus
proches.
4. Quel est l’ordre de grandeur de la complexité de votre deuxième solution. Conclure
Exercice 5 : (18 points)
On considère une image monochrome (256 niveaux de gris) stockée dans une matrice de taille
N x M où N représente le nombre de lignes et M le nombre de colonnes. Chaque élément de
cette matrice représente le niveau de gris d’un pixel de l’image dont la valeur est comprise
entre 0 et 255.
En imagerie numérique, l’histogramme représente la distribution des intensités (ou des
couleurs) de l'image. Pour une image monochrome, l'histogramme est défini comme une
fonction discrète qui associe à chaque niveau de gris le nombre de pixels de l’image ayant
cette valeur. La détermination de l'histogramme est donc réalisée en comptant le nombre de
pixels pour chaque niveau de gris.
Page 5 sur 7
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
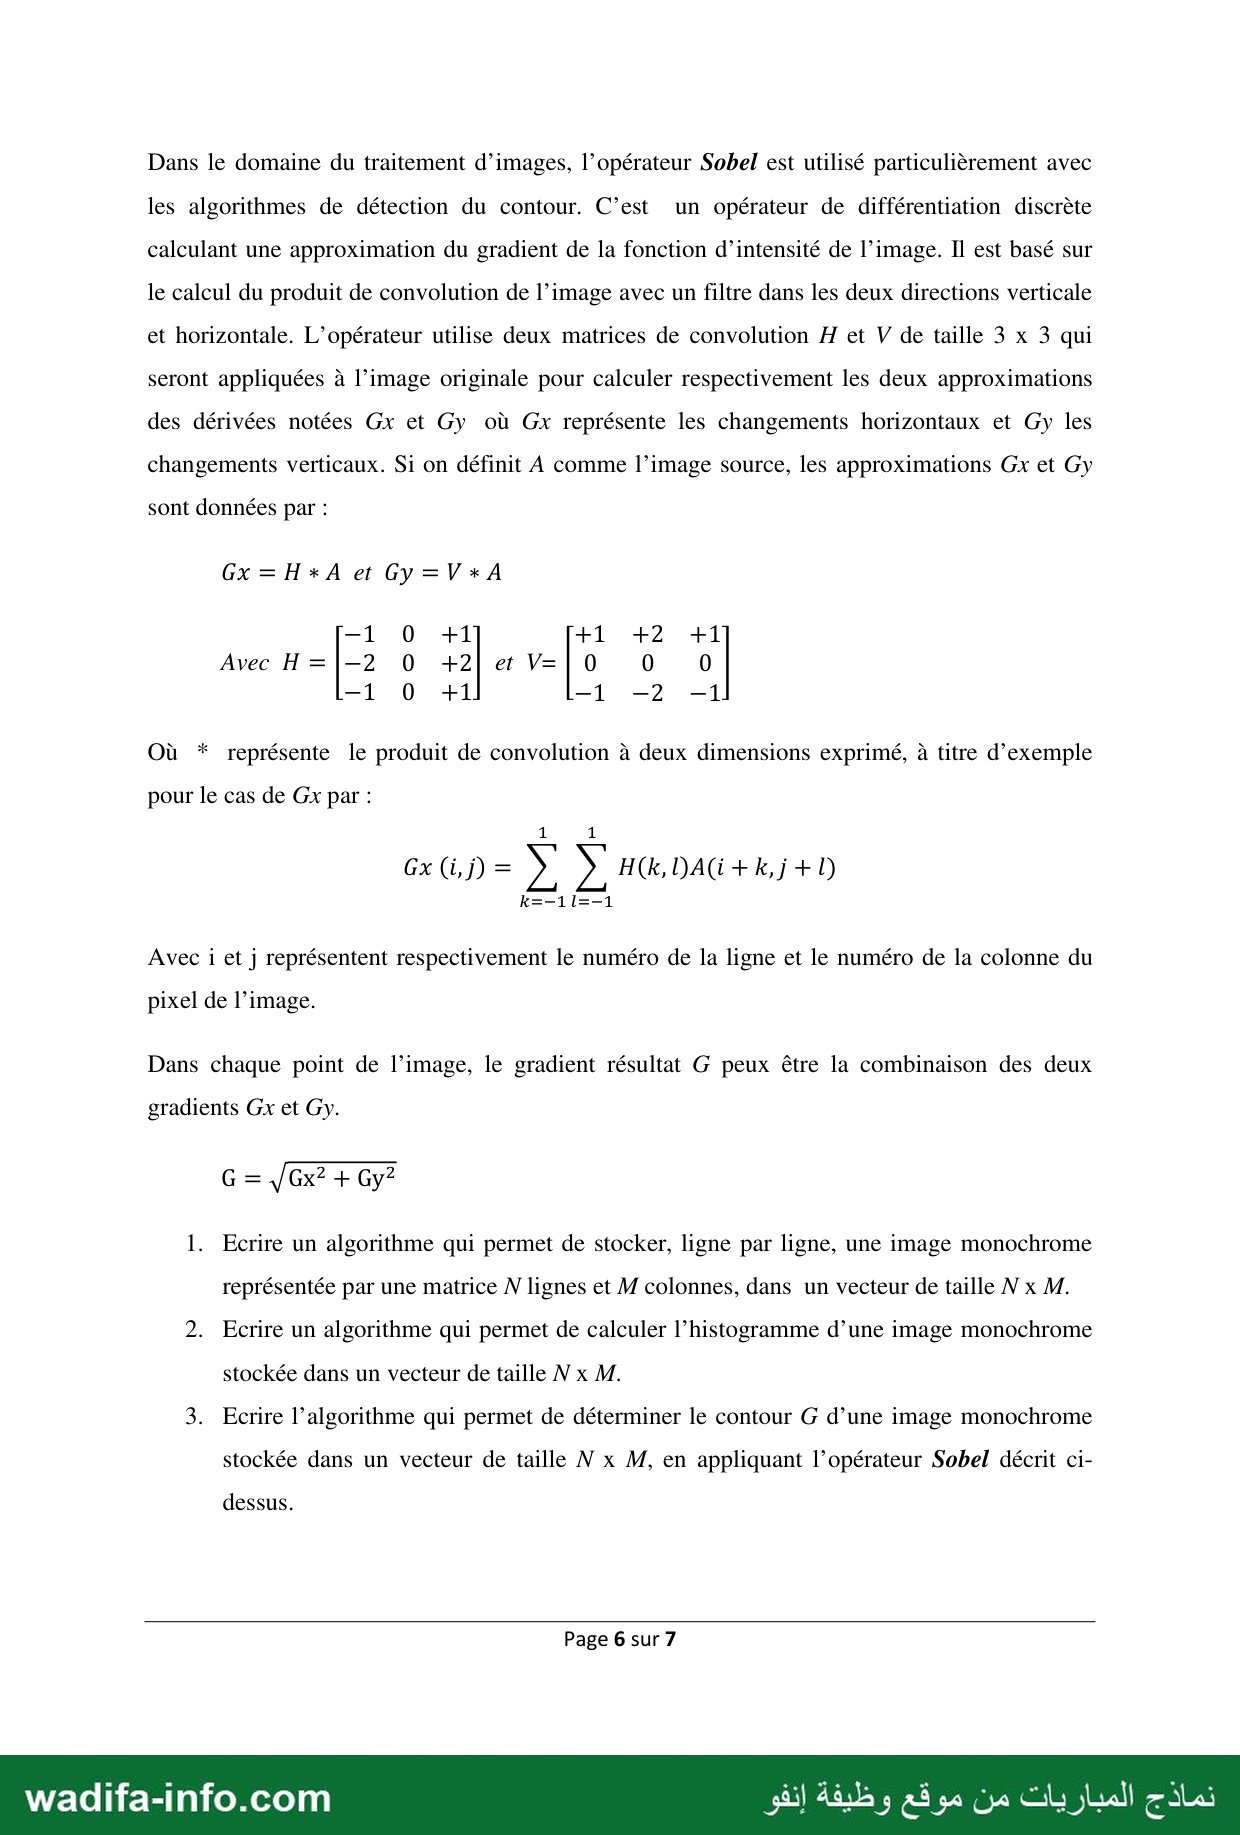
Dans le domaine du traitement d'images, l’opérateur Sobel est utilisé particulièrement avec
les algorithmes de détection du contour. C’est un opérateur de différentiation discrète
calculant une approximation du gradient de la fonction d’intensité de l’image. Il est basé sur
le calcul du produit de convolution de l’image avec un filtre dans les deux directions verticale
et horizontale. L’opérateur utilise deux matrices de convolution A et V de taille 3 x 3 qui
seront appliquées à l’image originale pour calculer respectivement les deux approximations
des dérivées notées Gx et Gy où Gx représente les changements horizontaux et Gy les
changements verticaux. 51 on définit À comme l’image source, les approximations Gx et Gy
sont données par :
Gx=H*+xA et Gy=V*+A
1 0 +1 +1 +2 +1
Avec 101 --2 0 +2|et V=|0 0 0
-1 0 +1 1ك =2 1
Où * représente le produit de convolution à deux dimensions exprimé, à titre d’exemple
pour le cas de Gx par :
GGD= D D 000046 + مج زط
12-1 1--1
Avec 1 et ز représentent respectivement le numéro de la ligne et le numéro de la colonne du
pixel de l’image.
Dans chaque point de l’image, le gradient résultat G peux être la combinaison des deux
gradients Gx et Gy.
G = /Gx2 + Gy2
1. Ecrire un algorithme qui permet de stocker, ligne par ligne, une image monochrome
représentée par une matrice N lignes et M colonnes, dans un vecteur de taille N x M.
2. Ecrire un algorithme qui permet de calculer l’histogramme d’une image monochrome
stockée dans un vecteur de taille N x M.
3. Ecrire l’algorithme qui permet de déterminer le contour G d’une image monochrome
stockée dans un vecteur de taille N x M, en appliquant l’opérateur Sobel décrit ci-
dessus.
Page 6 sur 7
نماذج المباريات من موقع وظيفة إنفو wadlifa-info.com
Exercice 6 (18 points)
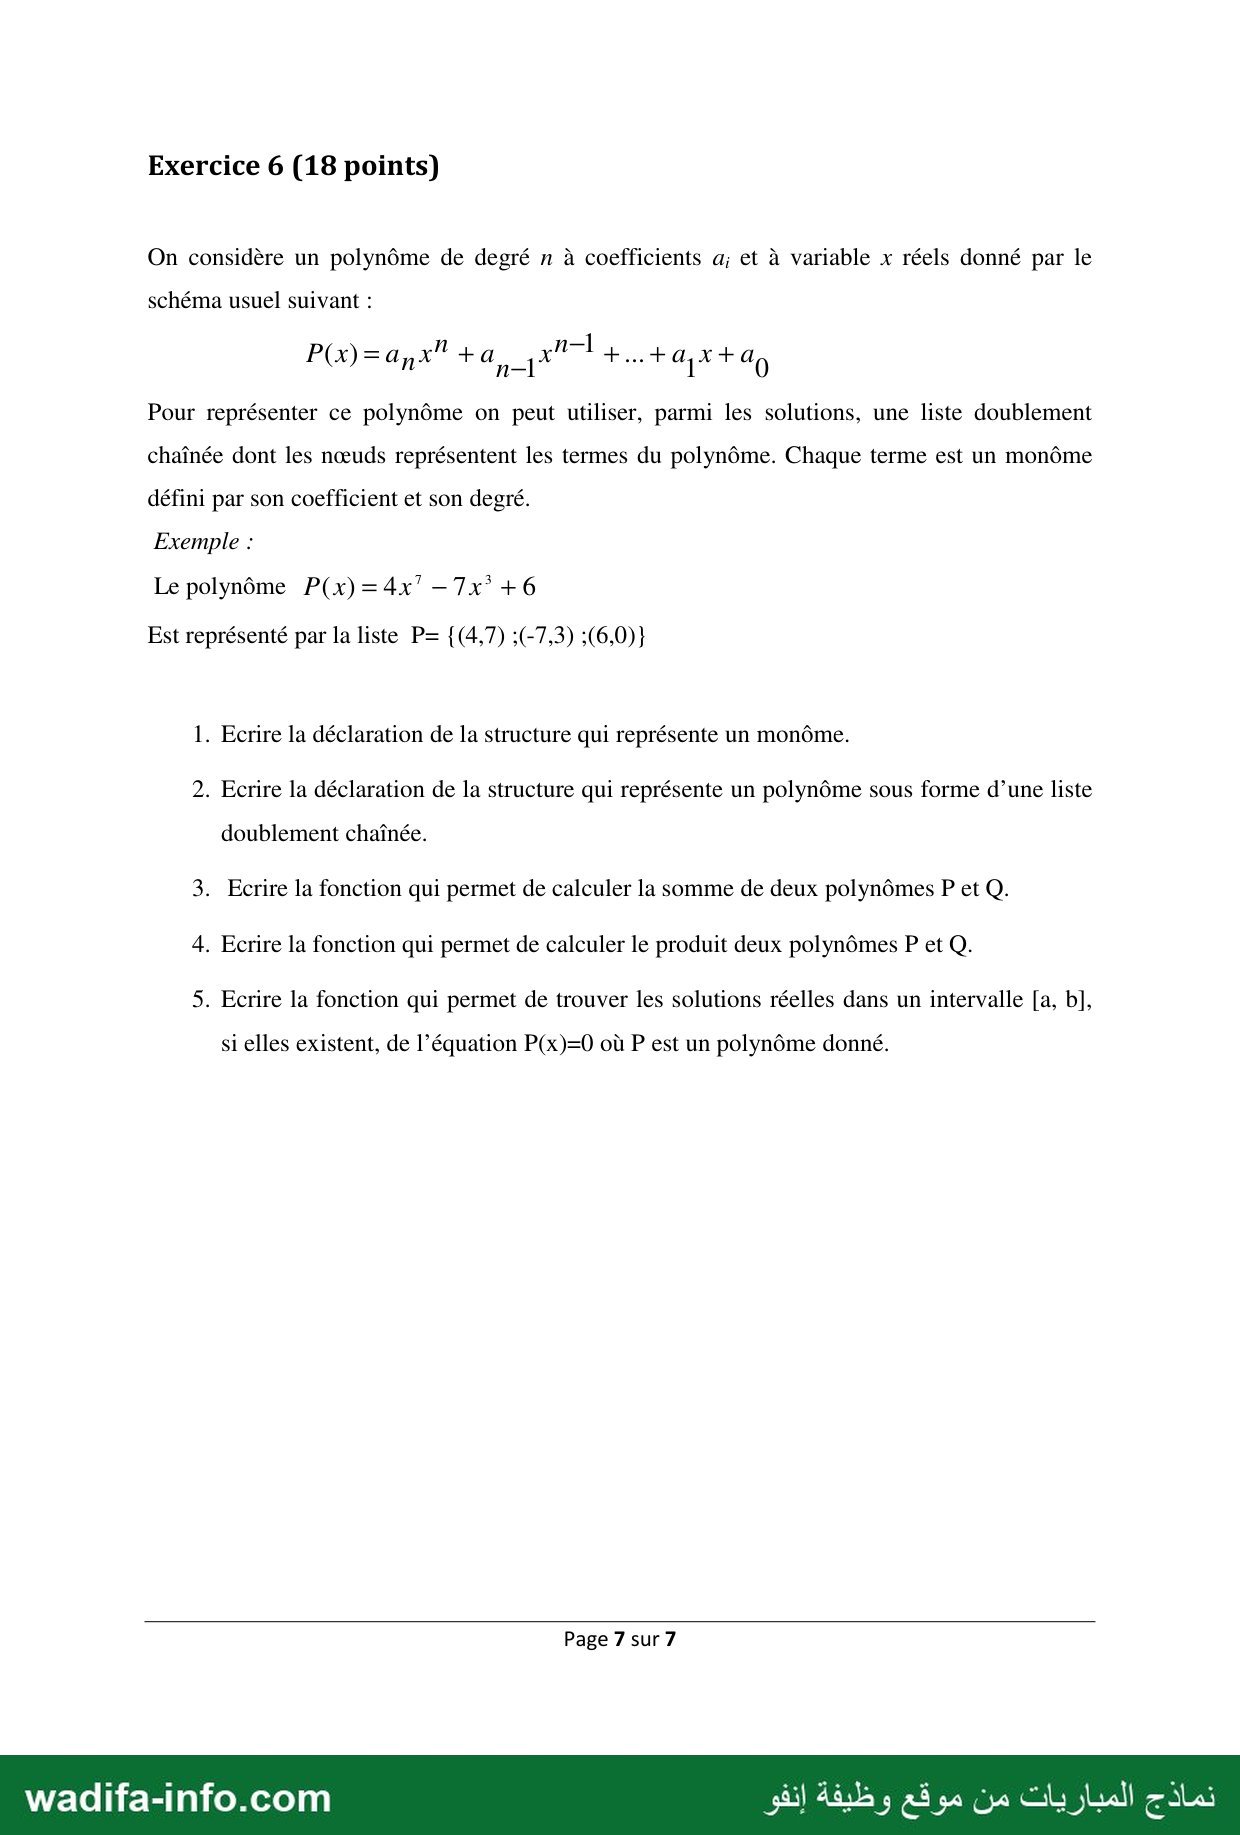
On considère un polynôme de degré n à coefficients a; et à variable x réels donné par le
schéma usuel suivant :
P(x)=à;,,x"7 + nl} وج و
(x)=a,x ay _1* 1 0
Pour représenter ce polynôme on peut utiliser, parmi les solutions, une liste doublement
chaînée dont les nœuds représentent les termes du polynôme. Chaque terme est un monôême
défini par son coefficient et son degré.
Exemple :
Le polynôme P(x)=4x’ -7 +6
Est représenté par la liste P= {(4,7) :(-7,3) :(6,0)}
1. Ecrire la déclaration de la structure qui représente un monôme.
2. Ecrire la déclaration de la structure qui représente un polynôme sous forme d’une liste
doublement chaînée.
3. Ecrire la fonction qui permet de calculer la somme de deux polynômes P et Q.
4. Ecrire la fonction qui permet de calculer le produit deux polynômes P et Q.
5. Ecrire la fonction qui permet de trouver les solutions réelles dans un intervalle [a, b],
si elles existent, de l’équation P(x)=0 où P est un polynôme donné.
Page 7 sur 7
wadifa-info.com نماذج المباريات من موقع وظيفة إنفو
✅ التصحيح المقترح
هذا تصحيح مقترح من إعداد فريق wadifa-info لمساعدتك على فهم منهجية الإجابة — وليس تصحيحاً رسمياً صادراً عن الإدارة المنظِّمة. أسئلة هذا الامتحان محررة بالفرنسية، لذلك التصحيح محرر بالفرنسية أيضاً.
Ce modèle est l'épreuve d'informatique du concours d'accès en 1re année du cycle d'ingénieurs GLSID (Génie du logiciel et des systèmes informatiques distribués) de l'ENSET Mohammedia, session de septembre 2014. Durée : 3 heures, sans calculatrice ni documents, notée sur 100 points : un QCM de 10 questions (10 points) et six exercices d'algorithmique. Les solutions peuvent être écrites en pseudo-code ou en C, C++, C#, Java ; la correction ci-dessous utilise le C. Voici une correction proposée.
💡 Ce que le jury regarde : un algorithme juste, lisible et commenté, avec sa complexité justifiée. Annoncez toujours vos hypothèses (indices à partir de 0, traitement des bords, cas d'égalité).
QCM (10 points)
- A) 9, 7, 12, 3, 4. Une pile est LIFO : le dernier entré sort le premier, donc l'ordre d'insertion est inversé.
- Réponse probable : B) 3, 4, 7, 9, 12. Un tas restitue ses éléments triés : B pour un tas-min, D pour un tas-max. La convention la plus courante (tas-min utilisé comme file de priorité) donne B.
- C) une table de hachage. Un tableau indexé par les sommets dont chaque case pointe sur une liste chaînée : c'est la structure d'une table de hachage à chaînage.
- C) Θ(h). La recherche suit un seul chemin depuis la racine ; au pire elle descend jusqu'à la profondeur h.
- A) une rotation droite. Le fils gauche 8 devient la racine, 24 passe à sa droite, et le sous-arbre 12 (avec 11 et 18) passe de la droite de 8 à la gauche de 24.
- B) On écrit l'équation de récurrence du coût (par exemple T(n) = 2T(n/2) + n) puis on la résout.
- B) Pile. Le parcours en profondeur explore d'abord le dernier nœud découvert (LIFO), qu'on l'écrive avec une pile explicite ou par récursivité (pile des appels).
- C) Le tri rapide. Il partitionne autour d'un pivot puis trie récursivement les deux parties : diviser pour régner.
- B) Bellman-Ford. Plus courts chemins depuis une source avec poids négatifs (sans cycle absorbant) : Dijkstra ne s'applique pas aux poids négatifs, le tri topologique exige un graphe sans cycle, et Floyd-Warshall traite toutes les paires (plus coûteux, O(n³)).
- C) sa complexité en pire cas. Le tri par tas est en O(n log n) même dans le pire cas (le tri rapide peut dégénérer en O(n²)), tout en triant sur place.
Exercice 1 (10 points) — développement limité de sin x
1. Algorithme
On ne recalcule ni la puissance ni la factorielle à chaque terme : chaque terme se déduit du précédent par tk+1 = −tk · x² / ((2k+2)(2k+3)), avec t0 = x. Le développement à l'ordre n contient les termes de degré 2k+1 ≤ n.
double dlSinus(double x, int n) {
    double terme = x, somme = 0;
    int k = 0;
    while (2 * k + 1 <= n) {
        somme += terme;
        terme = -terme * x * x / ((2 * k + 2) * (2 * k + 3));
        k++;
    }
    return somme;
}
Contrôle : pour x = 0,5 et n = 7, on obtient 0,47942553, contre sin 0,5 = 0,47942554.
2. Complexité
La boucle tourne ⌊(n+1)/2⌋ fois avec un nombre constant d'opérations : O(n). Une version naïve qui recalcule xk et k! à chaque terme coûterait O(n²).
Exercice 2 (16 points) — suite de Fibonacci
1. Algorithme récursif
long U(int n) {
    if (n <= 1) return n;          // U(0)=0, U(1)=1
    return U(n - 2) + U(n - 1);
}
2. Arbre des appels pour U(5)
U(5)
├── U(3)
│   ├── U(1)
│   └── U(2)
│       ├── U(0)
│       └── U(1)
└── U(4)
    ├── U(2)
    │   ├── U(0)
    │   └── U(1)
    └── U(3)
        ├── U(1)
        └── U(2)
            ├── U(0)
            └── U(1)
15 appels au total ; U(3) est calculé 2 fois, U(2) 3 fois, U(1) 5 fois. Résultat : U(5) = 5.
3. Complexité exponentielle
Soit C(n) le nombre d'appels : C(0) = C(1) = 1 et C(n) = 1 + C(n−1) + C(n−2). Posons A(n) = C(n) + 1 : A(n) = A(n−1) + A(n−2), avec A(0) = A(1) = 2. Notons φ = (1+√5)/2, qui vérifie φ² = φ + 1.
- Majoration : montrons A(n) ≤ 2φn. Vrai pour n = 0 (2 ≤ 2) et n = 1 (2 ≤ 2φ). Si c'est vrai aux rangs n−1 et n−2 : A(n) ≤ 2φn−1 + 2φn−2 = 2φn−2(φ + 1) = 2φn−2·φ² = 2φn.
- Minoration : de même A(n) ≥ φn−1 (vrai pour n = 0 et 1, et l'hérédité utilise la même identité φ + 1 = φ²).
Donc C(n) = Θ(φn) ≈ Θ(1,618n) : le coût est exponentiel.
4. Inconvénients
- Temps exponentiel : les mêmes termes sont recalculés un très grand nombre de fois (U(1) est calculé U(n) fois).
- Consommation de la pile d'appels (profondeur n), risque de débordement ; temps d'appel de fonction non négligeable.
5. Solution itérative
long Uiter(int n) {
    if (n <= 1) return n;
    long a = 0, b = 1, c;              // a = U(i-2), b = U(i-1)
    for (int i = 2; i <= n; i++) {
        c = a + b;
        a = b;
        b = c;
    }
    return b;
}
6. Complexité
O(n) en temps (une addition par tour) et O(1) en mémoire.
7. Convergence du rapport U(n−1)/U(n)
On calcule les rapports successifs et on s'arrête quand deux rapports consécutifs diffèrent de moins d'une précision ε. La limite est 1/φ = (√5 − 1)/2 ≈ 0,618034.
double convergence(double eps, int *rang) {
    long a = 1, b = 1, c;               // U(1), U(2)
    double r = (double)a / b, ancien;
    int n = 2;
    do {
        ancien = r;
        c = a + b; a = b; b = c; n++;   // b = U(n), a = U(n-1)
        r = (double)a / b;
        printf("n=%d  U(n-1)/U(n)=%.10f\n", n, r);
    } while (fabs(r - ancien) >= eps);
    *rang = n;
    return r;
}
Justification de la limite : si rn = U(n−1)/U(n) tend vers ℓ, alors 1/rn+1 = U(n+1)/U(n) = 1 + rn, d'où ℓ = 1/(1 + ℓ), soit ℓ² + ℓ − 1 = 0 et ℓ = (√5 − 1)/2.
Exercice 3 (12 points) — fusion de deux listes triées
// T doit avoir au moins N1 + N2 cases
void fusion(int T1[], int N1, int T2[], int N2, int T[]) {
    int i = 0, j = 0, k = 0;
    while (i < N1 && j < N2) {          // on prend le plus petit des deux en tête
        if (T1[i] <= T2[j]) T[k++] = T1[i++];
        else                T[k++] = T2[j++];
    }
    while (i < N1) T[k++] = T1[i++];     // reste de T1
    while (j < N2) T[k++] = T2[j++];     // reste de T2
}
Sur l'exemple : 1 (T1), 5, 6 (T2), 7 (T1), 8 (T2), 9, 15 (T1), puis le reste de T2 : 18, 22 → T = {1, 5, 6, 7, 8, 9, 15, 18, 22}. Chaque élément est copié une seule fois : complexité O(N1 + N2).
Exercice 4 (16 points) — les deux éléments les plus proches
1. Tableau non trié
Sans tri, il faut comparer toutes les paires. Les « éléments distincts » s'entendent de valeurs différentes : dans l'exemple, les deux 100 (positions 0 et 2) ont un écart nul mais ne sont pas retenus. Avec la comparaison stricte, la première paire d'écart minimal rencontrée est gardée : (3, 7) avant (4, 5), conformément au résultat attendu.
void plusProches(int T[], int n, int *p1, int *p2, int *ecart) {
    *ecart = -1;                                  // -1 : aucune paire trouvée
    for (int i = 0; i < n - 1; i++)
        for (int j = i + 1; j < n; j++) {
            int d = abs(T[i] - T[j]);
            if (d > 0 && (*ecart == -1 || d < *ecart)) {
                *ecart = d; *p1 = i; *p2 = j;
            }
        }
}
Sur l'exemple : écart 1 entre T[3] = 17 et T[7] = 18, positions 3 et 7.
2. Complexité
n(n−1)/2 comparaisons : O(n²).
3. Version avec tri préalable
Après tri, les deux valeurs les plus proches sont forcément voisines : un seul parcours suffit. Pour rendre les positions d'origine, on trie un tableau d'indices (ou des couples valeur–position) plutôt que les valeurs seules.
typedef struct { int val; int pos; } Elem;

void plusProchesTri(int T[], int n, int *p1, int *p2, int *ecart) {
    Elem E[n];
    for (int i = 0; i < n; i++) { E[i].val = T[i]; E[i].pos = i; }
    Tri_Rapide(E, n);                       // tri selon le champ val : O(n log n) en moyenne
    *ecart = -1;
    for (int i = 0; i < n - 1; i++) {        // un seul parcours des voisins
        int d = E[i + 1].val - E[i].val;
        if (d > 0 && (*ecart == -1 || d < *ecart)) {
            *ecart = d; *p1 = E[i].pos; *p2 = E[i + 1].pos;
        }
    }
}
4. Complexité et conclusion
O(n log n) pour le tri + O(n) pour le parcours = O(n log n) en moyenne. Conclusion : pour n grand, trier d'abord est nettement plus efficace que la comparaison de toutes les paires en O(n²) (pour n = 106 : environ 2·107 opérations contre 5·1011). Remarque : en cas d'égalité d'écarts, la paire rendue peut différer de la version 1 (ici, (4, 5) au lieu de (3, 7)), les deux étant correctes.
Exercice 5 (18 points) — histogramme et filtre de Sobel
1. Matrice → vecteur (ligne par ligne)
void matriceVersVecteur(int N, int M, int img[N][M], int vect[]) {
    for (int i = 0; i < N; i++)
        for (int j = 0; j < M; j++)
            vect[i * M + j] = img[i][j];      // le pixel (i, j) va à l'indice i*M + j
}
2. Histogramme
void histogramme(int vect[], int N, int M, int h[256]) {
    for (int g = 0; g < 256; g++) h[g] = 0;
    for (int p = 0; p < N * M; p++)
        h[vect[p]]++;
}
Complexité O(N·M).
3. Contour par l'opérateur de Sobel
Pour chaque pixel intérieur (les pixels du bord n'ont pas leurs 8 voisins ; on les met à 0), on applique la formule de l'énoncé Gx(i, j) = Σk Σl H(k, l)·A(i+k, j+l), de même pour Gy avec V, puis G = √(Gx² + Gy²), borné à 255.
int H[3][3] = {{-1, 0, 1}, {-2, 0, 2}, {-1, 0, 1}};
int V[3][3] = {{ 1, 2, 1}, { 0, 0, 0}, {-1,-2,-1}};

void sobel(int A[], int N, int M, int G[]) {
    for (int i = 0; i < N; i++)
        for (int j = 0; j < M; j++) {
            if (i == 0 || j == 0 || i == N - 1 || j == M - 1) { G[i * M + j] = 0; continue; }
            int gx = 0, gy = 0;
            for (int k = -1; k <= 1; k++)
                for (int l = -1; l <= 1; l++) {
                    int a = A[(i + k) * M + (j + l)];
                    gx += H[k + 1][l + 1] * a;   // indices k,l de -1..1 décalés en 0..2
                    gy += V[k + 1][l + 1] * a;
                }
            int g = (int) sqrt((double)(gx * gx + gy * gy));
            G[i * M + j] = (g > 255) ? 255 : g;
        }
}
Le résultat est écrit dans un vecteur G distinct de A (sinon les pixels déjà traités fausseraient les suivants). Complexité : 9 multiplications par filtre et par pixel, soit O(N·M).
Exercice 6 (18 points) — polynômes en liste doublement chaînée
Convention : les monômes sont rangés par degré décroissant, sans coefficient nul ni deux monômes de même degré (comme dans l'exemple {(4,7) ; (−7,3) ; (6,0)}).
1. Monôme
typedef struct {
    double coef;
    int    degre;
} Monome;
2. Polynôme
typedef struct Noeud {
    Monome m;
    struct Noeud *prec, *suiv;
} Noeud;

typedef struct {
    Noeud *tete;     // monôme de plus haut degré
    Noeud *queue;    // monôme de plus bas degré
} Polynome;

// ajout en fin de liste (utilisé quand on produit les termes par degré décroissant)
void ajouterFin(Polynome *P, double c, int d) {
    if (c == 0) return;
    Noeud *nd = malloc(sizeof(Noeud));
    nd->m.coef = c; nd->m.degre = d; nd->suiv = NULL; nd->prec = P->queue;
    if (P->queue) P->queue->suiv = nd; else P->tete = nd;
    P->queue = nd;
}
3. Somme
Même principe que la fusion de deux listes triées (exercice 3) :
Polynome somme(Polynome P, Polynome Q) {
    Polynome S = {NULL, NULL};
    Noeud *p = P.tete, *q = Q.tete;
    while (p && q) {
        if (p->m.degre > q->m.degre)      { ajouterFin(&S, p->m.coef, p->m.degre); p = p->suiv; }
        else if (p->m.degre < q->m.degre) { ajouterFin(&S, q->m.coef, q->m.degre); q = q->suiv; }
        else { ajouterFin(&S, p->m.coef + q->m.coef, p->m.degre); p = p->suiv; q = q->suiv; }
    }
    for (; p; p = p->suiv) ajouterFin(&S, p->m.coef, p->m.degre);
    for (; q; q = q->suiv) ajouterFin(&S, q->m.coef, q->m.degre);
    return S;
}
Complexité O(|P| + |Q|). Les termes qui s'annulent ne sont pas ajoutés (test c == 0).
4. Produit
On multiplie P par chaque monôme de Q et on additionne les résultats partiels :
Polynome produit(Polynome P, Polynome Q) {
    Polynome R = {NULL, NULL};
    for (Noeud *q = Q.tete; q; q = q->suiv) {
        Polynome partiel = {NULL, NULL};          // P × (c·x^d) : degrés toujours décroissants
        for (Noeud *p = P.tete; p; p = p->suiv)
            ajouterFin(&partiel, p->m.coef * q->m.coef, p->m.degre + q->m.degre);
        R = somme(R, partiel);                    // (libérer l'ancien R et partiel)
    }
    return R;
}
Complexité O(|P|·|Q|²) avec cette méthode simple (chaque somme parcourt R).
5. Racines réelles dans [a, b]
Il n'existe pas de formule générale pour les racines d'un polynôme de degré quelconque : on procède numériquement. On évalue P par le schéma de Horner adapté à la liste, on découpe [a, b] en petits pas, et on affine par dichotomie chaque intervalle où P change de signe.
double evaluer(Polynome P, double x) {
    double r = 0; int dPrec = P.tete ? P.tete->m.degre : 0;
    for (Noeud *p = P.tete; p; p = p->suiv) {
        for (int k = p->m.degre; k < dPrec; k++) r *= x;   // Horner avec degrés manquants
        r += p->m.coef; dPrec = p->m.degre;
    }
    for (int k = 0; k < dPrec; k++) r *= x;
    return r;
}

void racines(Polynome P, double a, double b, double pas, double eps) {
    for (double x = a; x < b; x += pas) {
        double g = x, d = (x + pas < b) ? x + pas : b;
        double fg = evaluer(P, g), fd = evaluer(P, d);
        if (fg == 0) { printf("racine : %g\n", g); continue; }
        if (fg * fd < 0) {                           // changement de signe : dichotomie
            while (d - g > eps) {
                double m = (g + d) / 2;
                if (fg * evaluer(P, m) <= 0) d = m; else { g = m; fg = evaluer(P, g); }
            }
            printf("racine : %g\n", (g + d) / 2);
        }
    }
    if (evaluer(P, b) == 0) printf("racine : %g\n", b);
}
Limite à signaler : une racine double (sans changement de signe) ou deux racines dans le même pas peuvent échapper à la recherche ; on réduit le pas, ou l'on cherche aussi les racines de la dérivée P' pour isoler chaque racine.
أسئلة شائعة حول هذا النموذج
هل يمكن تحميل هذا النموذج مجاناً؟
هل يتضمن هذا النموذج التصحيح؟
ما هي الجهة المنظمة والدرجة المعنية بهذا النموذج؟
ما هي دورة هذا الامتحان ولغة أسئلته؟
أين أجد نماذج أخرى لنفس المباراة؟
💬 ناقش هذا النموذج (0)
شارك إجاباتك أو صحّح التصحيح — إذا كان لديك رأي مختلف حول أي نقطة، اكتبه هنا ليستفيد باقي المترشحين.
لا يوجد نقاش بعد — شارك إجابتك أو سؤالك حول هذا النموذج.
⚠️ ممنوع نشر أرقام الهاتف أو الروابط أو أي عرض مقابل مال — تُحذف هذه المشاركات تلقائياً.
هل تحضّر لهذه المباراة؟
نماذج مشابهة قد تهمّك
المصدر: المواقع الرسمية للمؤسسات (نسخ أرشيفية من Wayback Machine)