
نموذج المباراة الوطنية المشتركة CNC 2017: المعلوميات - شعبة MP وPSI وTSI لولوج مدارس المهندسين
⬇️ تحميل PDF الرابط الدائم: https://www.wadifa-info.com/نموذج-مباراة/1745/نموذج-المباراة-الوطنية-المشتركة-CNC-2017-المعلوميات-شعبة-MP-وPSI-وTSI-لولوج-مدار
باختصار
هذا نموذج امتحان كتابي سابق لمباراة مباراة ولوج المدارس العليا للمهندسين لدى المباراة الوطنية المشتركة CNC (الأقسام التحضيرية) (2017)، منشور على وظيفة إنفو للاطلاع والتحميل المجاني بصيغة PDF مع تصحيح مقترح.
- الجهة المنظمة
- المباراة الوطنية المشتركة CNC (الأقسام التحضيرية)
- الدرجة
- مباراة ولوج المدارس العليا للمهندسين
- التخصص
- المعلوميات
- الدورة
- 2017
- عدد الصفحات
- 12
- لغة الأسئلة
- الفرنسية
- التصحيح
- تصحيح مقترح متوفر في هذه الصفحة
📝 نص أسئلة النموذج (مستخرج آلياً من الصفحات الممسوحة)
استُخرج هذا النص آلياً من صور الامتحان وقد يحتوي على أخطاء في القراءة — الصور أعلاه هي المرجع.
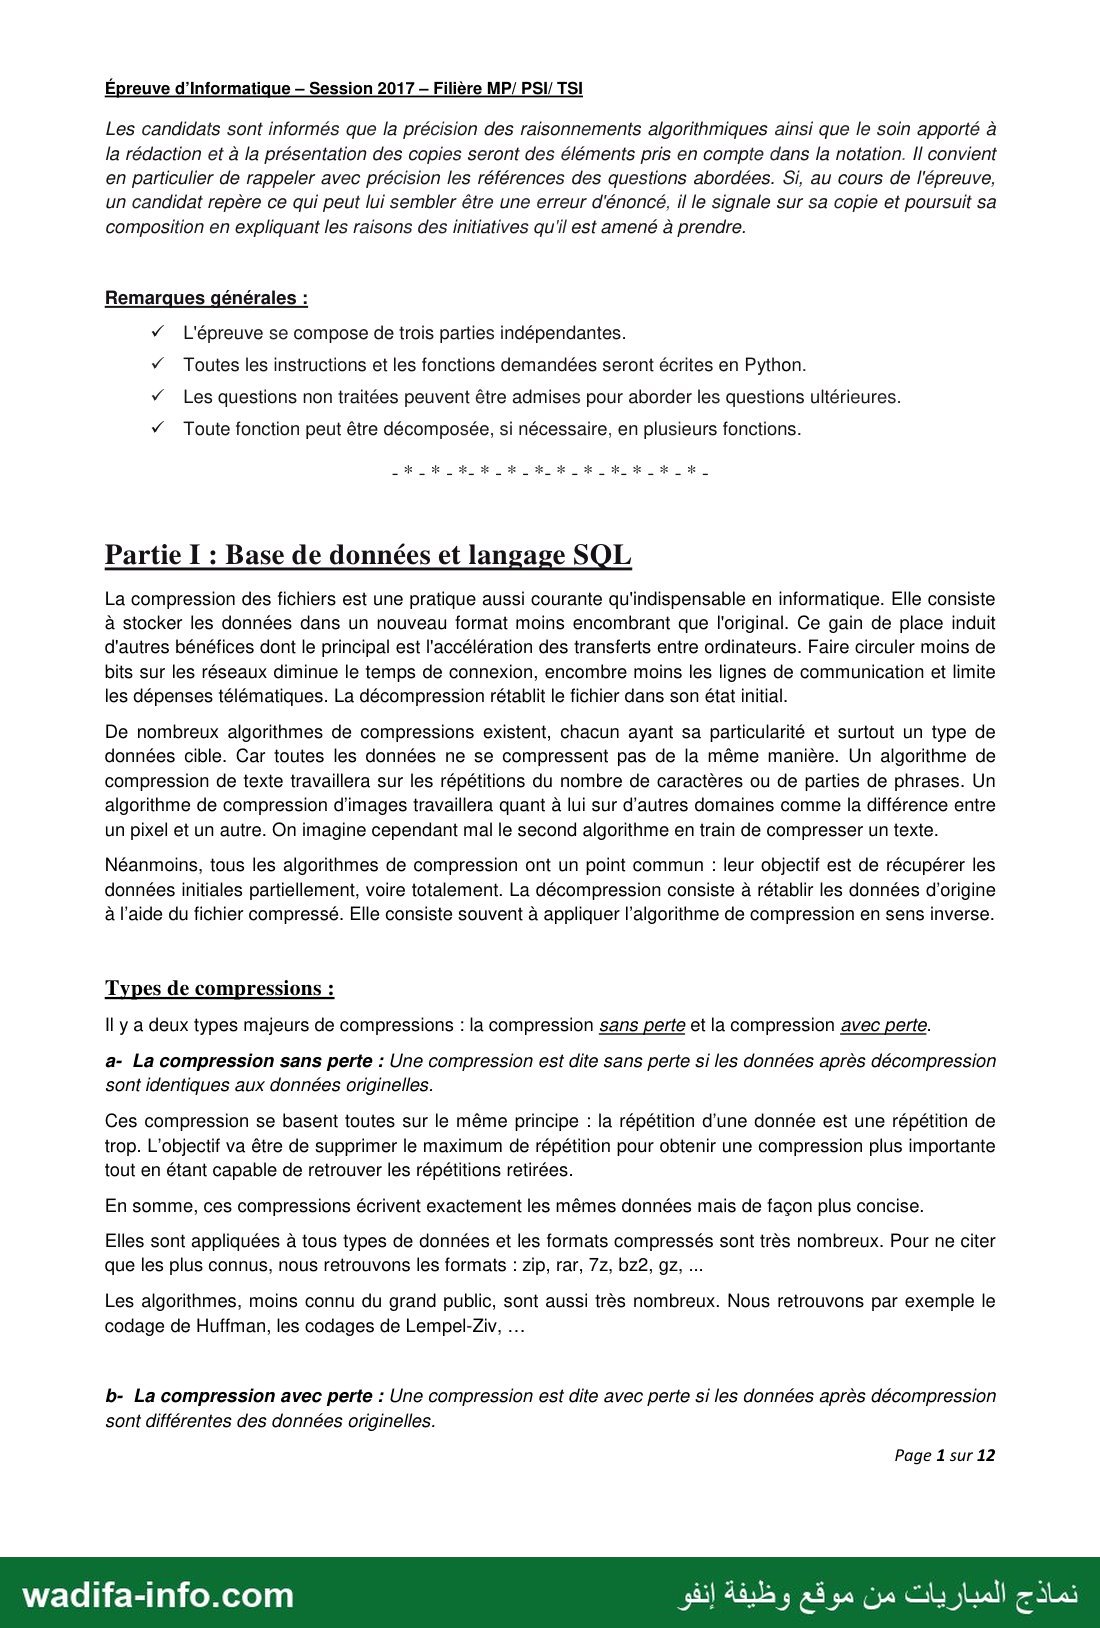
— صفحة 1 —
Épreuve d’Informatique — Session 2017 — Filière MP/ PSI/ TSI
Les candidats sont informés que la précision des raisonnements algorithmiques ainsi que le soin apporté à
la rédaction et à la présentation des copies seront des éléments pris en compte dans la notation. ١ convient
en particulier de rappeler avec précision les références des questions abordées. Si, au cours de l'épreuve,
un candidat repère ce qui peut lui sembler être une erreur d'énoncé, il le signale sur sa copie et poursuit sa
composition en expliquant les raisons des initiatives qu'il est amené à prendre.
Remarques générales :
y L'épreuve se compose de trois parties indépendantes.
y Toutes les instructions et les fonctions demandées seront écrites en Python.
y Les questions non traitées peuvent être admises pour aborder les questions ultérieures.
y Toute fonction peut être décomposée, si nécessaire, en plusieurs fonctions.
Partie I : Base de données et langage SQL
La compression des fichiers est une pratique aussi courante qu'indispensable en informatique. Elle consiste
à stocker les données dans un nouveau format moins encombrant que l'original. Ce gain de place induit
d'autres bénéfices dont le principal est l'accélération des transferts entre ordinateurs. Faire circuler moins de
bits sur les réseaux diminue le temps de connexion, encombre moins les lignes de communication et limite
les dépenses télématiques. La décompression rétablit le fichier dans son état initial.
De nombreux algorithmes de compressions existent, chacun ayant sa particularité et surtout un type de
données cible. Car toutes les données ne se compressent pas de la même manière. Un algorithme de
compression de texte travaillera sur les répétitions du nombre de caractères ou de parties de phrases. Un
algorithme de compression d'images travaillera quant à lui sur d’autres domaines comme la différence entre
un pixel et un autre. On imagine cependant mal le second algorithme en train de compresser un texte.
Néanmoins, tous les algorithmes de compression ont un point commun : leur objectif est de récupérer les
données initiales partiellement, voire totalement. La décompression consiste à rétablir les données d'origine
à l’aide du fichier compressé. Elle consiste souvent à appliquer l’algorithme de compression en sens inverse.
Types de compressions :
Il y a deux types majeurs de compressions : la compression sans perte et la compression avec perte.
a- La compression sans perte : Une compression est dite sans perte si les données après décompression
sont identiques aux données originelles.
Ces compression se basent toutes sur le même principe : la répétition d'une donnée est une répétition de
trop. L'objectif va être de supprimer le maximum de répétition pour obtenir une compression plus importante
tout en étant capable de retrouver les répétitions retirées.
En somme, ces compressions écrivent exactement les mêmes données mais de façon plus concise.
Elles sont appliquées à tous types de données et les formats compressés sont très nombreux. Pour ne citer
que les plus connus, nous retrouvons les formats : zip, rar, 72, 022, gz, …
Les algorithmes, moins connu du grand public, sont aussi très nombreux. Nous retrouvons par exemple le
codage de Huffman, les codages de Lempel-Ziv, …
b- La compression avec perte : Une compression est dite avec perte si les données après décompression
sont différentes des données originelles.
Page 1 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 2 —
Épreuve d’Informatique — Session 2017 — Filière MP/ PSI/ TSI
Elles sont appliquées à des données perceptibles, c'est-à-dire à des images, des sons ou des vidéos. Le
principe va consister à supprimer les informations là où les sens de la vue et de l’ouïe ne les perçoivent que
très peu. Par exemple, l'œil humain ne distingue que très peu les zones de contraste. Aussi, nous pouvons
retirer des détails à ces zones sans trop impacter sur la qualité de l'image. Le nom de format représente
directement le type de compression employé : jpeg, mpeg, mp3, divx, …
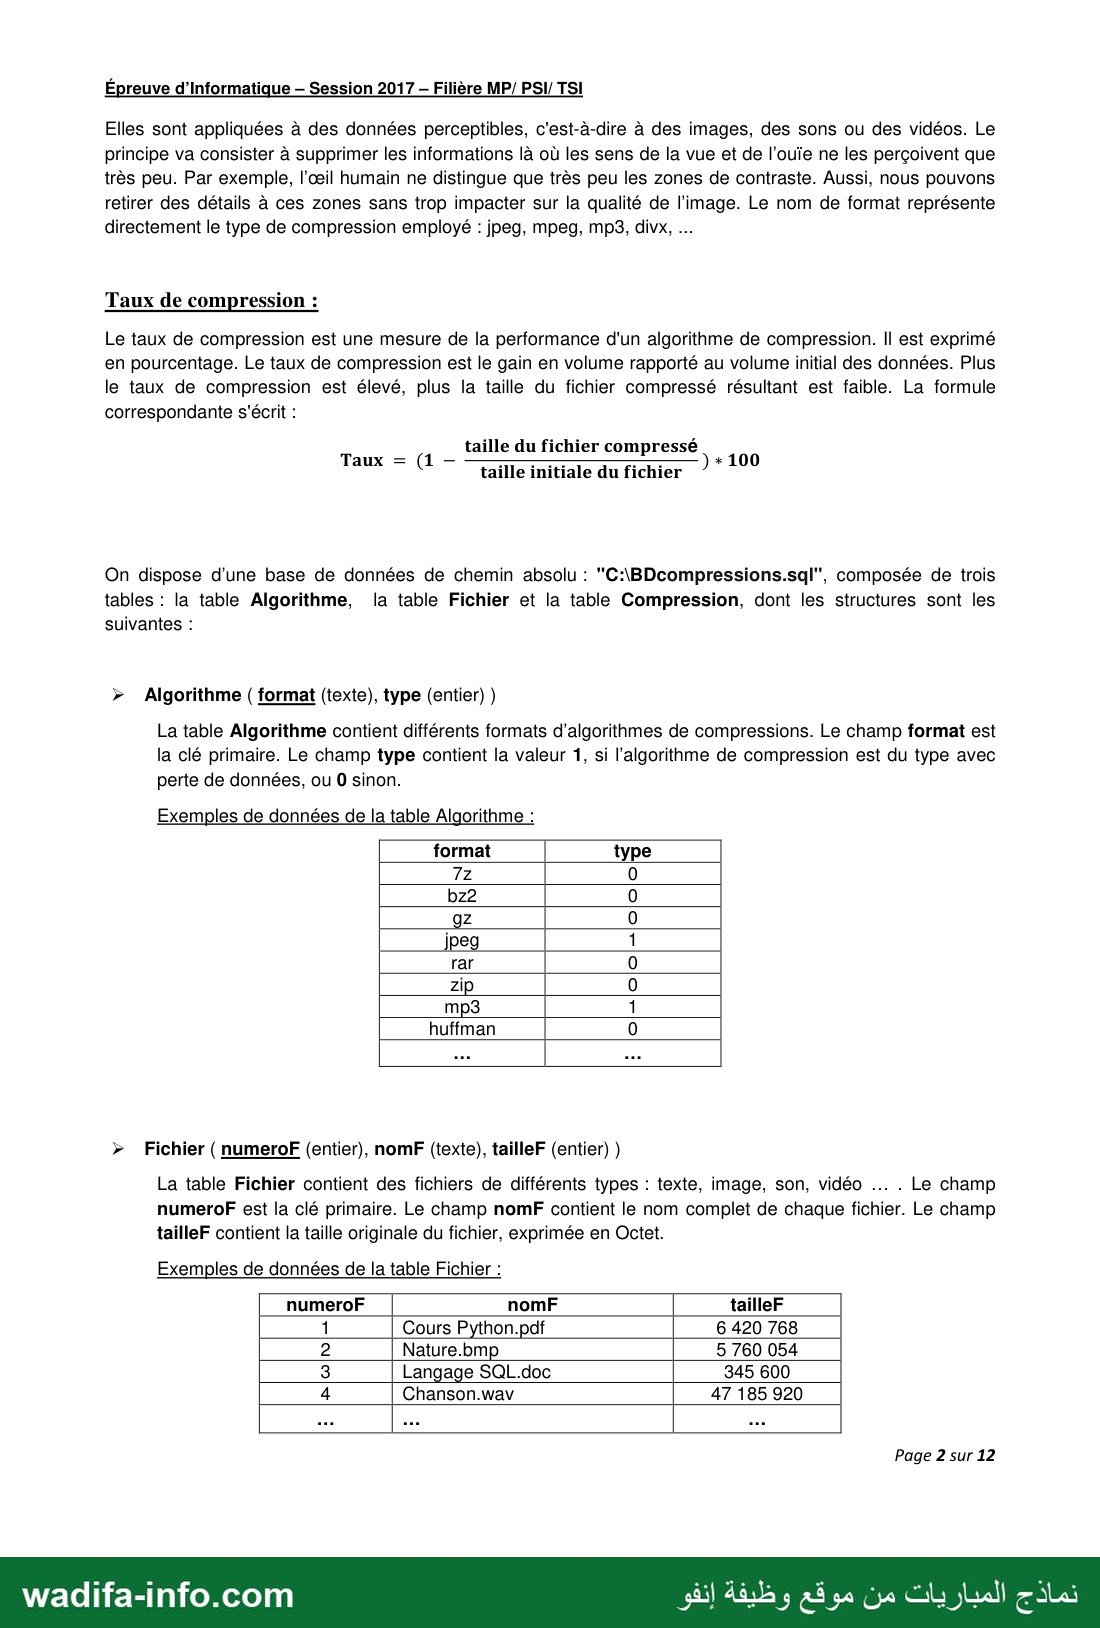
Taux de compression :
Le taux de compression est une mesure de la performance d'un algorithme de compression. ١١ est exprimé
en pourcentage. Le taux de compression est le gain en volume rapporté au volume initial des données. Plus
le taux de compression est élevé, plus la taille du fichier compressé résultant est faible. La formule
correspondante s'écrit :
taille du fichier compressé
taille initiale du fichier 3+100
Taux = (1 —
On dispose d'une base de données de chemin absolu : "C:\BDcompressions.sql', composée de trois
tables : la table Algorithme, la table Fichier et la table Compression, dont les structures sont les
suivantes :
› Algorithme ( format (texte), type (entier) )
La table Algorithme contient différents formats d’'algorithmes de compressions. Le champ format est
la clé primaire. Le champ type contient la valeur 1, si l'algorithme de compression est du type avec
perte de données, ou 0 sinon.
Exemples de données de la table Algorithme :
format
huffman
› Fichier (numeroF (entier), nomF (texte), tailleF (entier) )
La table Fichier contient des fichiers de différents types : texte, image, son, vidéo … . Le champ
numeroF est la clé primaire. Le champ nomF contient le nom complet de chaque fichier. Le champ
tailleF contient la taille originale du fichier, exprimée en Octet.
Exemples de données de la table Fichier :
numeroF nomF tailleF
1
2 Nature.bomp 5 760 054
3 Langage SQL.doc 345 600
4 Chanson.wav 47 185 920
Page 2 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 3 —
Épreuve d’Informatique — Session 2017 — Filière MP/ PSI/ TSI
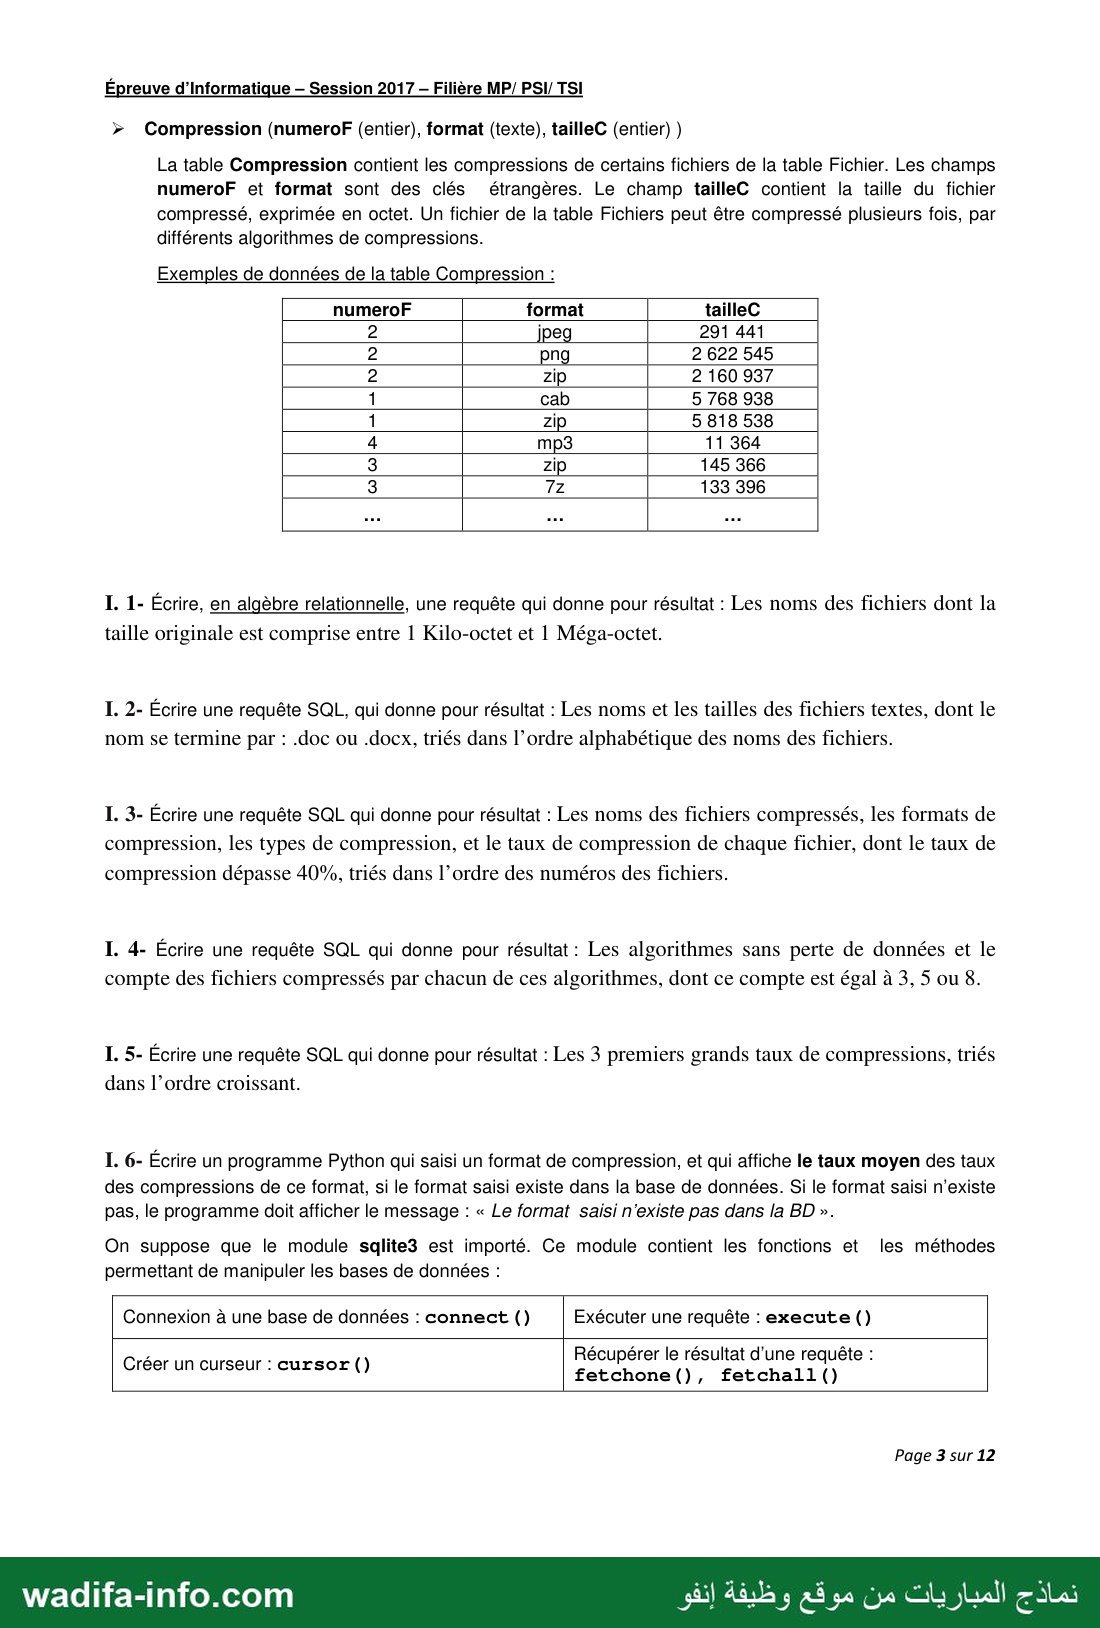
› Compression (numeroF (entier), format (texte), tailleC (entier) )
La table Compression contient les compressions de certains fichiers de la table Fichier. Les champs
numeroF et format sont des clés étrangères. Le champ tailleC contient la taille du fichier
compressé, exprimée en octet. Un fichier de la table Fichiers peut être compressé plusieurs fois, par
différents algorithmes de compressions.
Exemples de données de la table Compression :
numeroF format tailleC
2 jpeg 291 441
2 622 545
5 768 938
5 818 538
145 366
133 396
2
2
1
1
4 11 364
3
1. 1- Écrire, en algèbre relationnelle, une requête qui donne pour résultat : Les noms des fichiers dont la
taille originale est comprise entre 1 Kilo-octet et 1 Méga-octet.
L. 2- Écrire une requête SQL, qui donne pour résultat : Les noms et les tailles des fichiers textes, dont le
nom se termine par : .doc ou .docx, triés dans l’ordre alphabétique des noms des fichiers.
I. 3- Écrire une requête SQL qui donne pour résultat : Les noms des fichiers compressés, les formats de
compression, les types de compression, et le taux de compression de chaque fichier, dont le taux de
compression dépasse 40%, triés dans l’ordre des numéros des fichiers.
I. 4- Écrire une requête SQL qui donne pour résultat : Les algorithmes sans perte de données et le
compte des fichiers compressés par chacun de ces algorithmes, dont ce compte est égal à 3, 5 ou 8.
I. 5- Écrire une requête SQL qui donne pour résultat : Les 3 premiers grands taux de compressions, triés
dans l’ordre croissant.
1. 6- Écrire un programme Python qui saisi un format de compression, et qui affiche le taux moyen des taux
des compressions de ce format, si le format saisi existe dans la base de données. Si le format saisi n'existe
pas, le programme doit afficher le message : « Le format saisi n'existe pas dans la BD ».
On suppose que le module sqlite3 est importé. Ce module contient les fonctions et les méthodes
permettant de manipuler les bases de données :
| Connexion à une base de données : connect () | Exécuter une requête : execute () |
Récupérer le résultat d'une requête :
Créer un curseur : cursor () fetchone(). fetehellf)
Page 3 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 4 —
Épreuve d’Informatique — Session 2017 — Filière MP/ PSI/ TSI
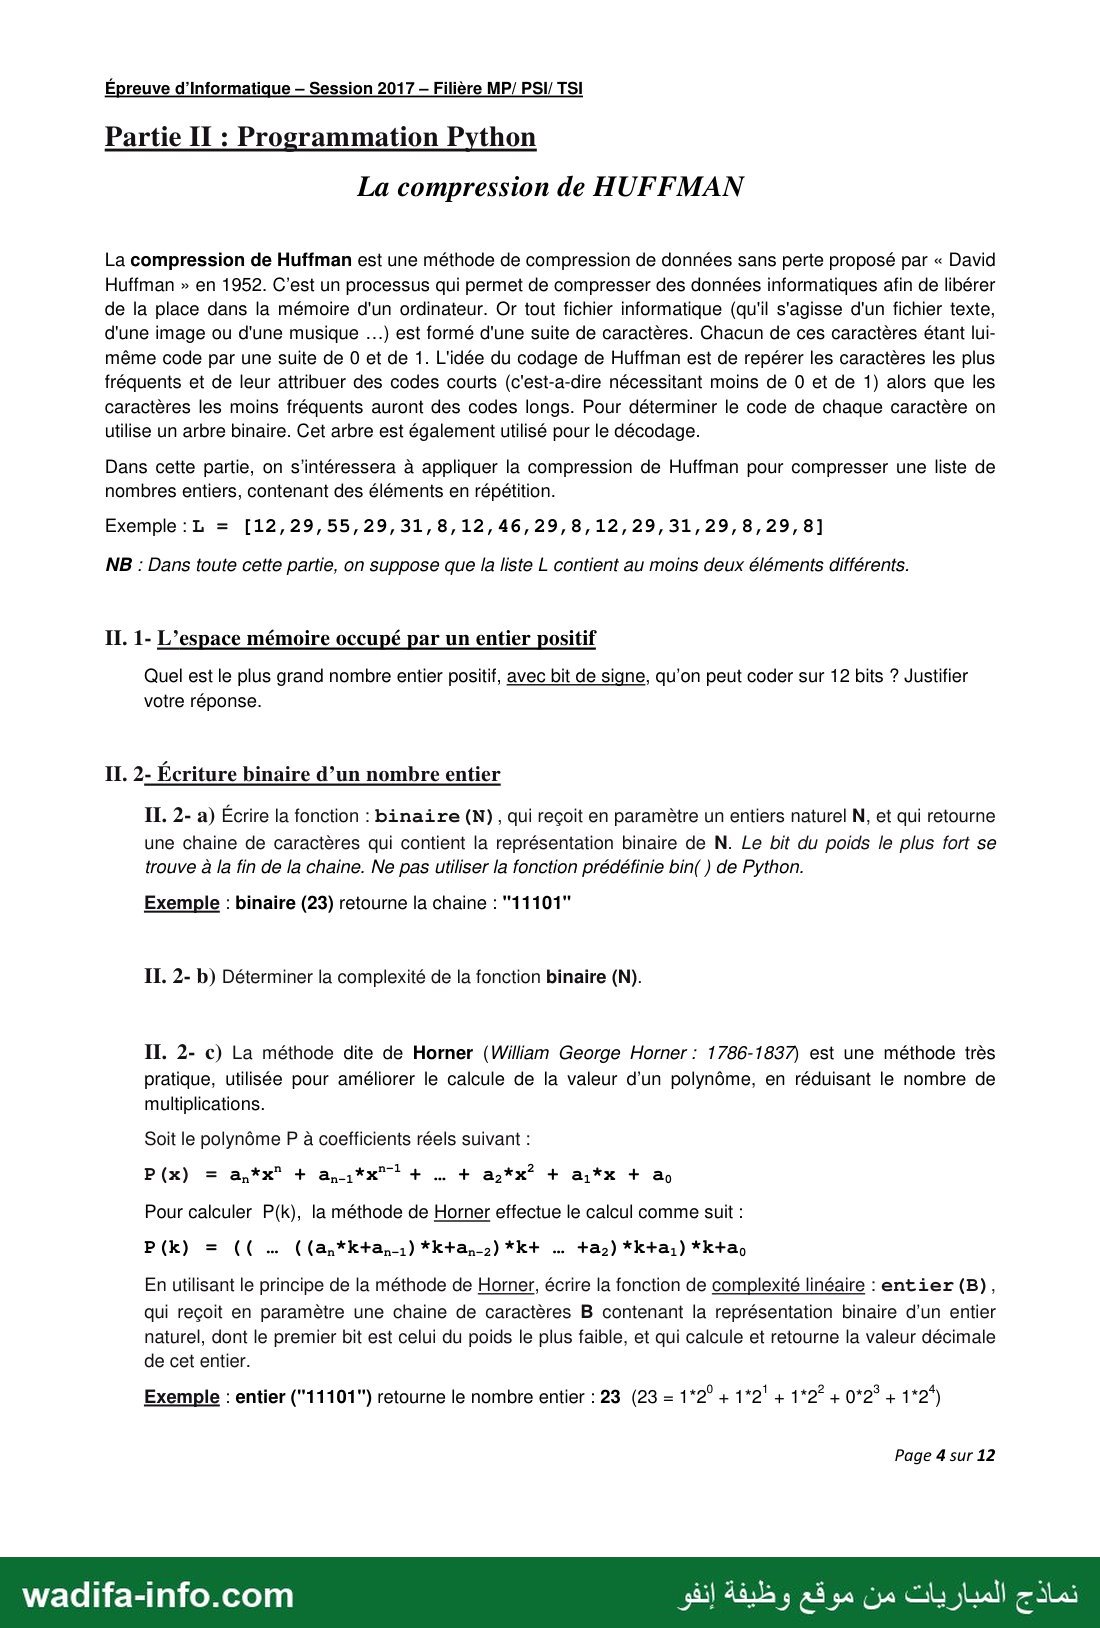
Partie II : Programmation Python
La compression de HUFFMAN
La compression de Huffman est une méthode de compression de données sans perte proposé par « David
Huffman » en 1952. C’est un processus qui permet de compresser des données informatiques afin de libérer
de la place dans la mémoire d'un ordinateur. Or tout fichier informatique (qu'il s'agisse d'un fichier texte,
d'une image ou d'une musique …) est formé d'une suite de caractères. Chacun de ces caractères étant lui-
même code par une suite de 0 et de 1. L'idée du codage de Huffman est de repérer les caractères les plus
fréquents et de leur attribuer des codes courts (c'est-a-dire nécessitant moins de O et de 1) alors que les
caractères les moins fréquents auront des codes longs. Pour déterminer le code de chaque caractère on
utilise un arbre binaire. Cet arbre est également utilisé pour le décodage.
Dans cette partie, on s'intéressera à appliquer la compression de Huffman pour compresser une liste de
nombres entiers, contenant des éléments en répétition.
Exemple :L = [12,29,55,29,31,8,12,46,29,8,12,29,31,29,8,29,8]
NB : Dans toute cette partie, on suppose que la liste L contient au moins deux éléments différents.
II. 1- L’espace mémoire occupé par un entier positif
Quel est le plus grand nombre entier positif, avec bit de signe, qu’on peut coder sur 12 bits ? Justifier
votre réponse.
II. 2- Écriture binaire d’un nombre entier
II. 2- a) Écrire la fonction : binaire )11( , qui reçoit en paramètre un entiers naturel N, et qui retourne
une chaine de caractères qui contient la représentation binaire de N. Le bit du poids le plus fort se
trouve à la fin de la chaine. Ne pas utiliser la fonction prédéfinie bin( ) de Python.
Exemple : binaire (23) retourne la chaine : "11101"
IT. 2- b) Déterminer la complexité de la fonction binaire (N).
11. 2- c) La méthode dite de Horner (William George Horner : 1786-1837) est une méthode très
pratique, utilisée pour améliorer le calcule de la valeur d’un polynôme, en réduisant le nombre de
multiplications.
Soit le polynôme P à coefficients réels suivant :
Pour calculer P(k), la méthode de Horner effectue le calcul comme suit :
En utilisant le principe de la méthode de Horner, écrire la fonction de complexité linéaire : entier (B),
qui reçoit en paramètre une chaine de caractères B contenant la représentation binaire d'un entier
naturel, dont le premier bit est celui du poids le plus faible, et qui calcule et retourne la valeur décimale
de cet entier.
Exemple : entier ("11101") retourne le nombre entier : 23 (23 = 1 *20 104 1*2 0*2 +1 *2*)
Page 4 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 5 —
Épreuve d’Informatique — Session 2017 — Filière MP/ PSI/ TSI
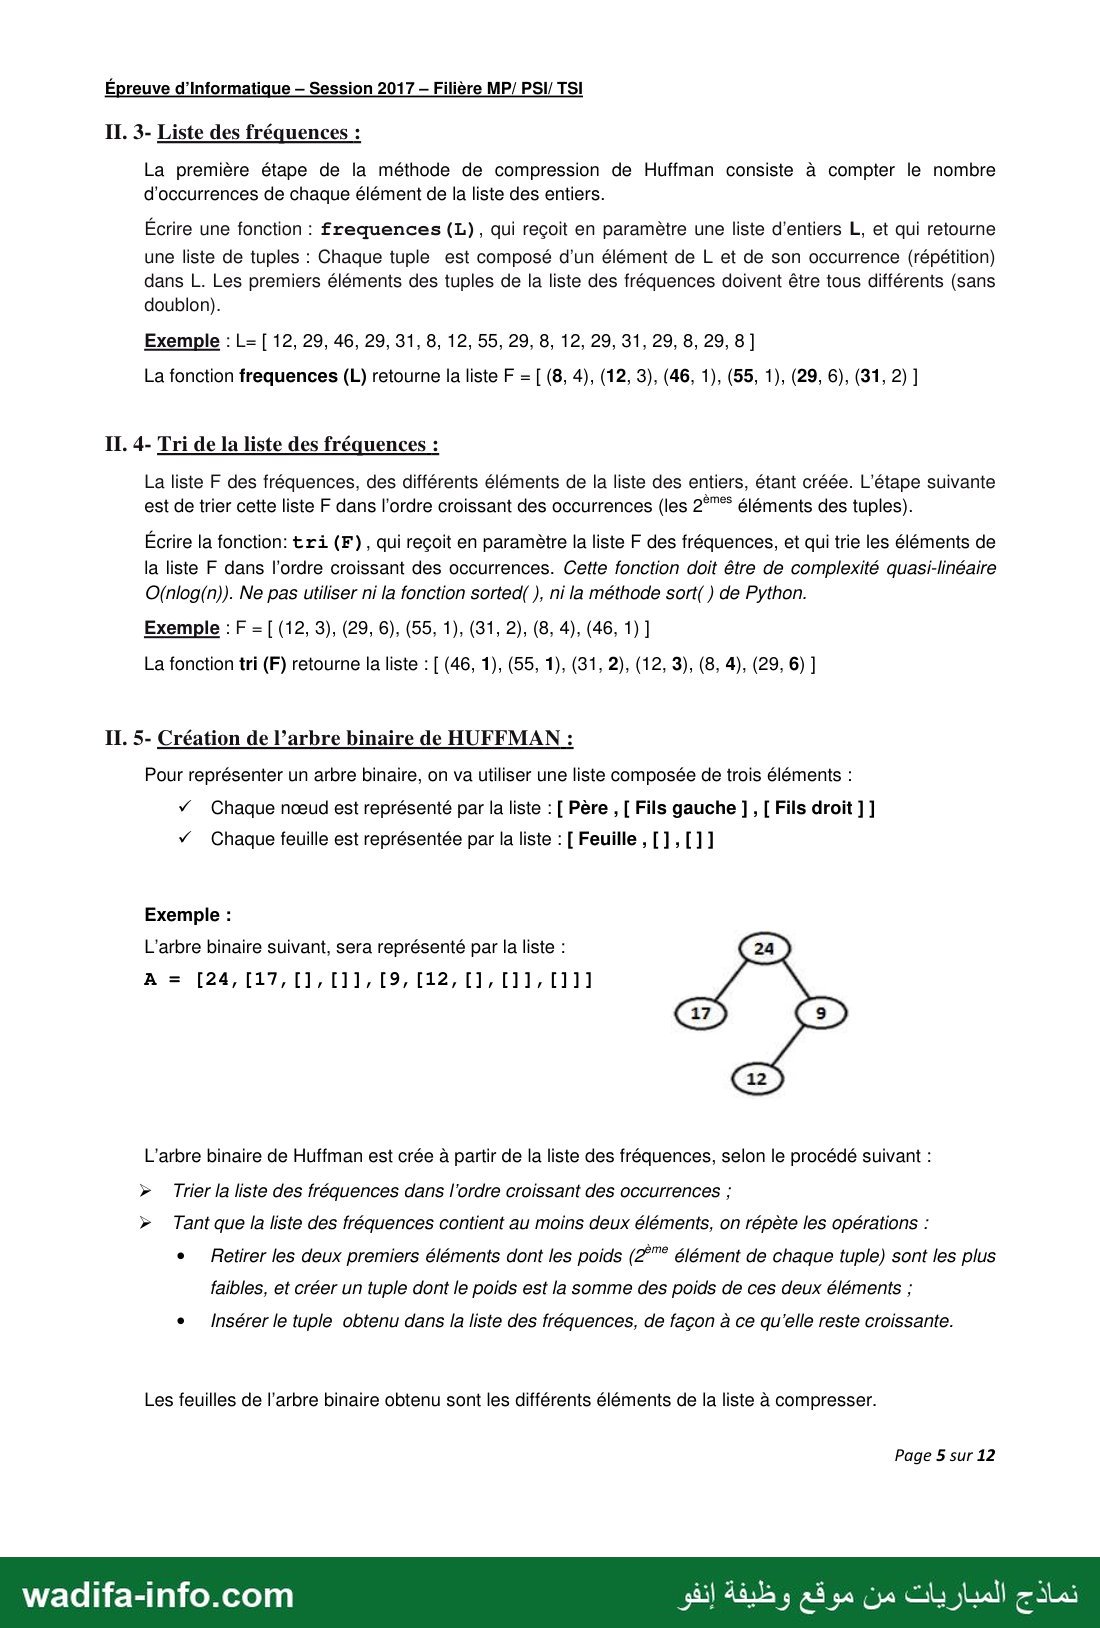
11. 3- Liste des fréquences :
La première étape de la méthode de compression de Huffman consiste à compter le nombre
d'occurrences de chaque élément de la liste des entiers.
Écrire une fonction : frequences (L), qui reçoit en paramètre une liste d'entiers L, et qui retourne
une liste de tuples : Chaque tuple est composé d’un élément de L et de son occurrence (répétition)
dans L. Les premiers éléments des tuples de la liste des fréquences doivent être tous différents (sans
doublon).
Exemple : حا [ 12, 29, 46, 29, 31, 8, 12, 55, 29, 8, 12, 29, 31, 29, 8, 29, 8]
La fonction frequences (L) retourne la liste F = [ (8, 4), (12, 3), (46, 1), (55, 1), (29, 6), (31, 2) ]
IT. 4- Tri de la liste des fréquences :
La liste F des fréquences, des différents éléments de la liste des entiers, étant créée. L'étape suivante
est de trier cette liste F dans l'ordre croissant des occurrences (les 29099 éléments des tuples).
Écrire la fonction: tri (F), qui reçoit en paramètre la liste F des fréquences, et qui trie les éléments de
la liste F dans l’ordre croissant des occurrences. Cette fonction doit être de complexité quasi-linéaire
O(nlog(n)). Ne pas utiliser ni la fonction sorted( ), ni la méthode sort( ) de Python.
La fonction tri (F) retourne la liste : [ (46, 1), (55, 1), (31, 2), (12, 3), (8, 4), (29, 6) ]
II. 5- Création de l’arbre binaire de HUFFMAN :
Pour représenter un arbre binaire, on va utiliser une liste composée de trois éléments :
y Chaque nœud est représenté par la liste : [ Père , [ Fils gauche ] , [ Fils droit ] ]
y Chaque feuille est représentée par la liste : [ Feuille ,[],[]]
Exemple :
L'arbre binaire suivant, sera représenté par la liste : (24)
G2)
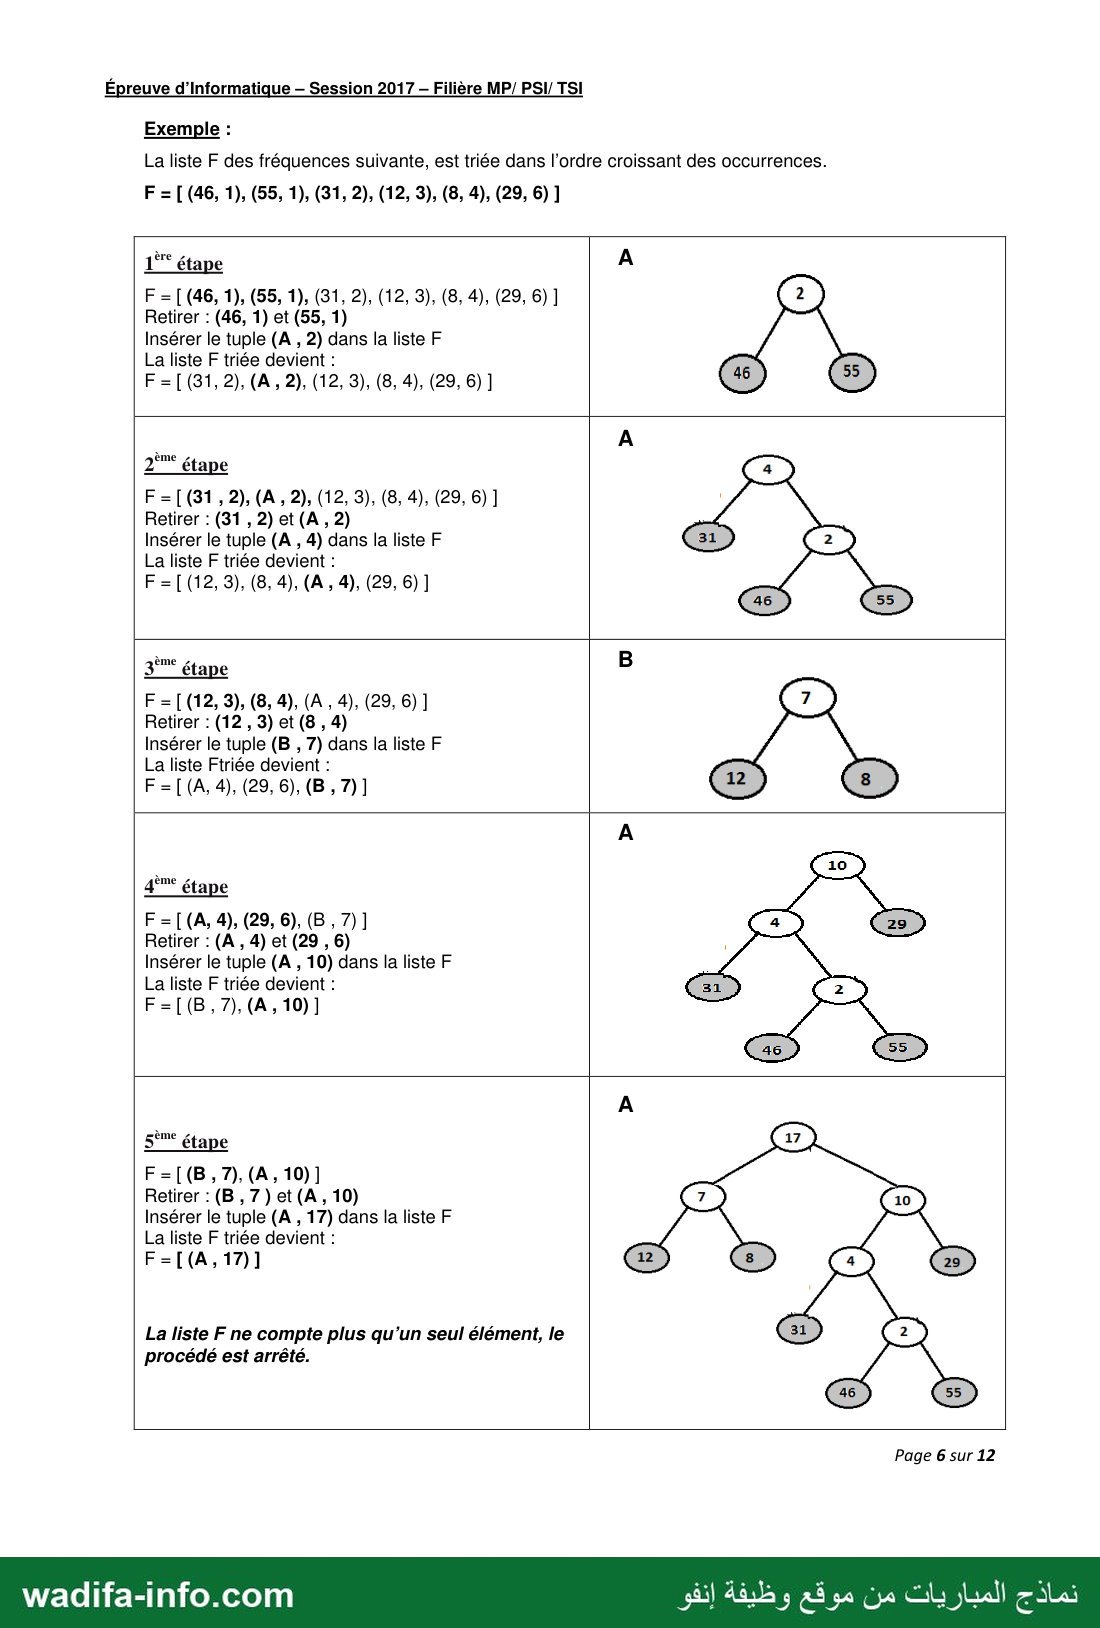
L'arbre binaire de Huffman est crée à partir de la liste des fréquences, selon le procédé suivant :
› Trier la liste des fréquences dans l’ordre croissant des occurrences ;
› Tant que la liste des fréquences contient au moins deux éléments, on répète les opérations :
e Retirer les deux premiers éléments dont les poids (2"° élément de chaque tuple) sont les plus
faibles, et créer un tuple dont le poids est la somme des poids de ces deux éléments ;
e Insérer le tuple obtenu dans la liste des fréquences, de façon à ce qu'elle reste croissante.
Les feuilles de l'arbre binaire obtenu sont les différents éléments de la liste à compresser.
Page 5 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 6 —
Épreuve d’Informatique — Session 2017 — Filière MP/ PSI/ TSI
Exemple :
La liste F des fréquences suivante, est triée dans l’ordre croissant des occurrences.
1°" étape A
Retirer : (46, 1) et (55, 1)
Insérer le tuple (A , 2) dans la liste F
La liste F triée devient :
2°" étape Ca)
Retirer : (31 , 2) et (A , 2)
Insérer le tuple (A , 4) dans la liste F G1) Ca)
La liste F triée devient :
ème ردي 8
3 étape
Retirer : (12 , 3) et (8 , 4)
Insérer le tuple (B , 7) dans la liste F
La liste Ftriée devient :
4°" étape
Retirer : (A , 4) et (29 , 6) :
Insérer le tuple (A , 10) dans la liste F
La liste F triée devient :
2
55
5°" étape 5
Retirer : (B, 7 ) et (A, 10) 7 (10)
Insérer le tuple (A , 17) dans la liste F
La liste F triée devient :
La liste F ne compte plus qu’un seul élément, le 31 (a)
procédé est arrêté.
Page 6 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 7 —
Épreuve d’Informatique — Session 2017 — Filière MP/ PSI/ TSI
II. 5- a) Écrire la fonction de complexité linéaire : insere (F, T), qui reçoit en paramètre la liste ع
des fréquences triée dans l’ordre croissant des occurrences, et un tuple T, de même nature que les
éléments de F. La fonction insère le tuple T dans F de façon à ce que la liste F reste triée dans l'ordre
croissant des occurrences.
Après l'appel de la fonction : insere (F, T), la liste F devient :
II. 5- b) Écrire la fonction : arbre_Huffman )2( , qui reçoit en paramètre la liste des fréquences F,
composée des tuples formés des différents éléments de la liste à compresser, et de leurs occurrences.
La fonction retourne un arbre binaire de Huffman, crée selon le principe décrit ci-dessus.
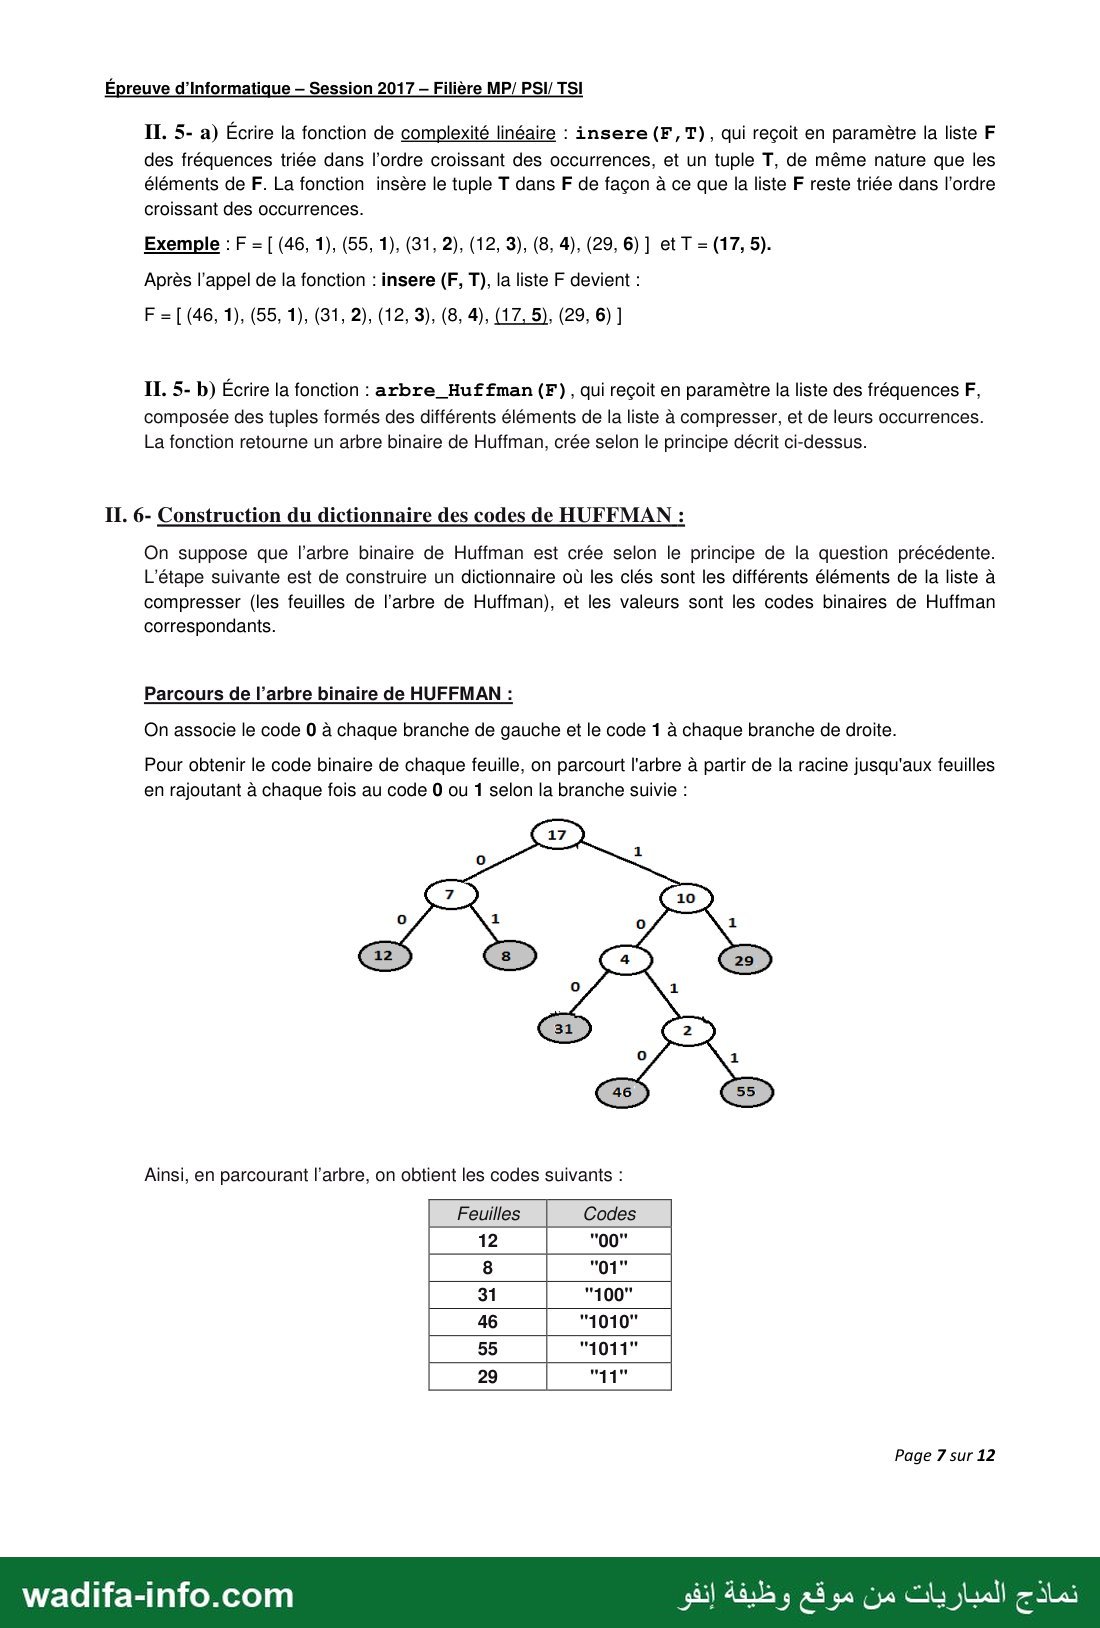
11. 6- Construction du dictionnaire des codes de HUFFMAN :
On suppose que l’arbre binaire de Huffman est crée selon le principe de la question précédente.
L'étape suivante est de construire un dictionnaire où les clés sont les différents éléments de la liste à
compresser (les feuilles de l'arbre de Huffman), et les valeurs sont les codes binaires de Huffman
correspondants.
Parcours de l’arbre binaire de HUFFMAN :
On associe le code 0 à chaque branche de gauche et le code 1 à chaque branche de droite.
Pour obtenir le code binaire de chaque feuille, on parcourt l'arbre à partir de la racine jusqu'aux feuilles
en rajoutant à chaque fois au code 0 ou 1 selon la branche suivie :
Ainsi, en parcourant l'arbre, on obtient les codes suivants :
8
31
46
55
29
"100"
"1010"
"1011"
"11
Page 7 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 8 —
Épreuve d’Informatique — Session 2017 — Filière MP/ PSI/ TSI
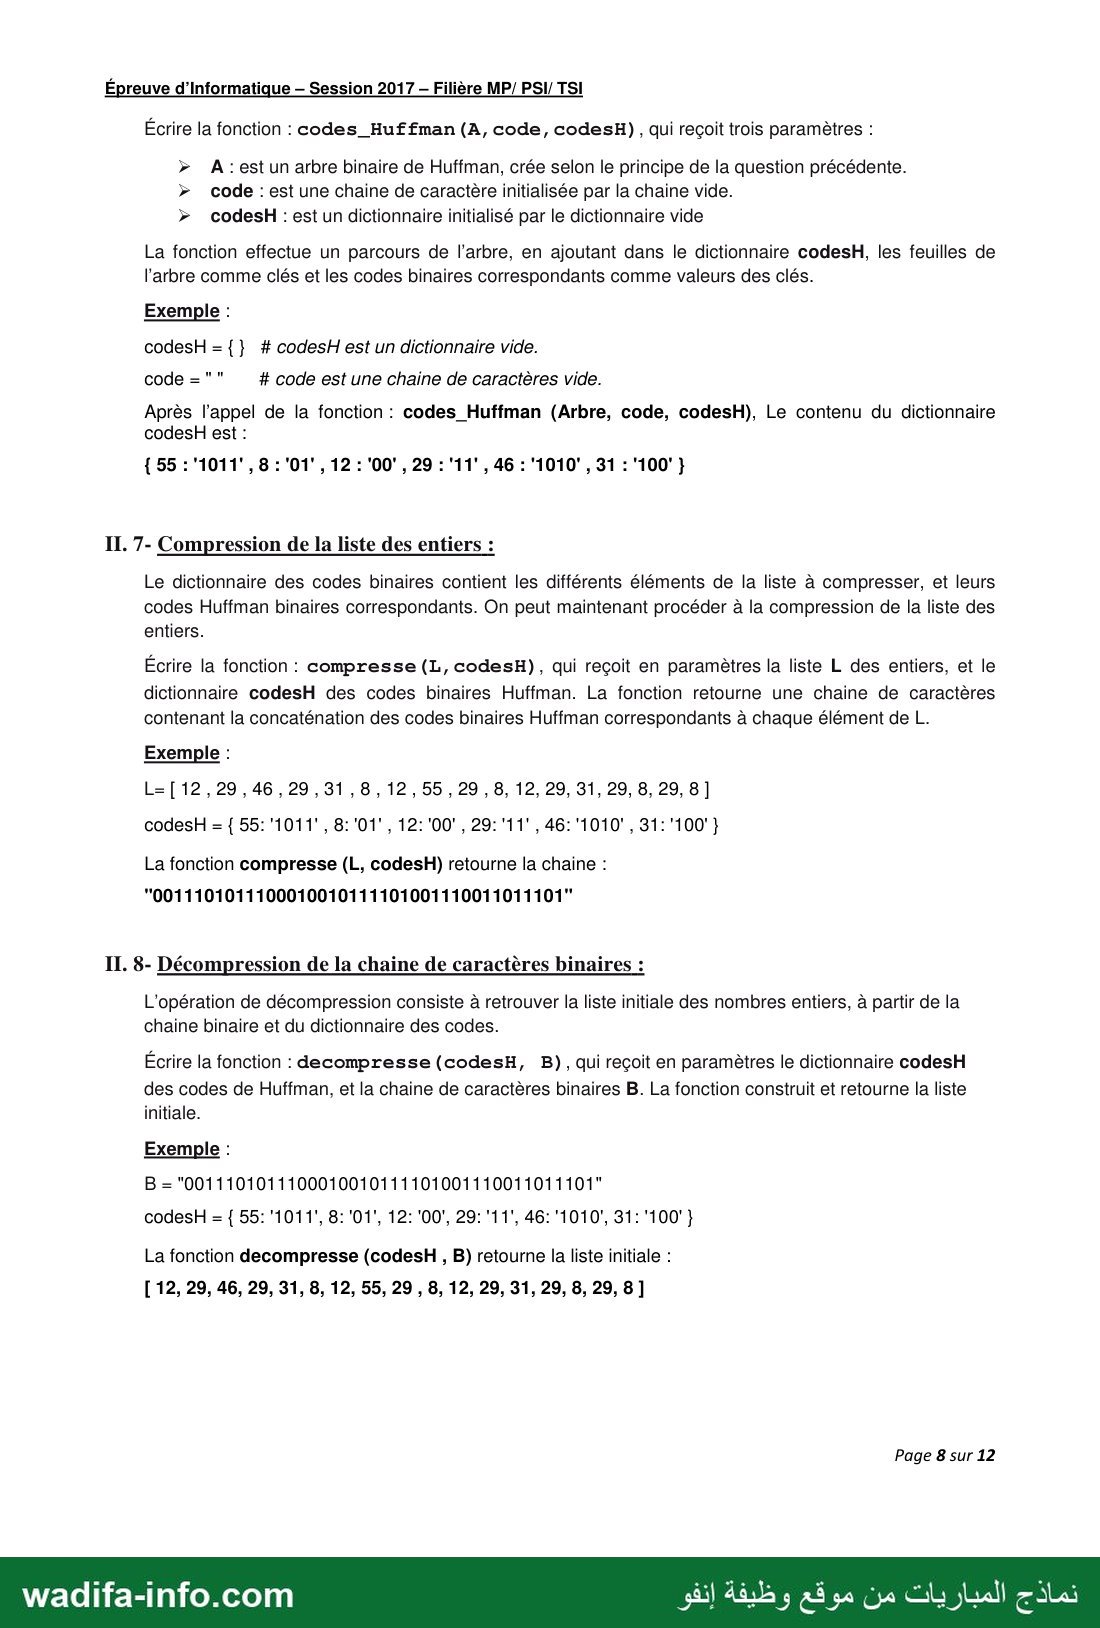
Écrire la fonction : codes_Huffman (A, code, codesH), qui reçoit trois paramètres :
› A : est un arbre binaire de Huffman, crée selon le principe de la question précédente.
› code : est une chaine de caractère initialisée par la chaine vide.
› codesH : est un dictionnaire initialisé par le dictionnaire vide
La fonction effectue un parcours de l’arbre, en ajoutant dans le dictionnaire codesH, les feuilles de
l’arbre comme clés et les codes binaires correspondants comme valeurs des clés.
Exemple :
codesH = {} # codesH est un dictionnaire vide.
code = # code est une chaine de caractères vide.
Après l’appel de la fonction : codes_Huffman (Arbre, code, codesH), Le contenu du dictionnaire
codesH est :
II. 7- Compression de la liste des entiers :
Le dictionnaire des codes binaires contient les différents éléments de la liste à compresser, et leurs
codes Huffman binaires correspondants. On peut maintenant procéder à la compression de la liste des
entiers.
Écrire la fonction : compresse (L, codesH), qui reçoit en paramètres la liste L des entiers, et le
dictionnaire codesH des codes binaires Huffman. La fonction retourne une chaine de caractères
contenant la concaténation des codes binaires Huffman correspondants à chaque élément de L.
Exemple :
L=[12,29,46,29,31,8,12,55, 29,8, 12, 29, 31, 29, 8,29, 8]
La fonction compresse (L, codesH) retourne la chaine :
"0011101011100010010111101001110011011101"
11. 8- Décompression de la chaine de caractères binaires :
L'opération de décompression consiste à retrouver la liste initiale des nombres entiers, à partir de la
chaine binaire et du dictionnaire des codes.
Écrire la fonction : decompresse (codesH, PB), qui reçoit en paramètres le dictionnaire codesH
des codes de Huffman, et la chaine de caractères binaires 8. La fonction construit et retourne la liste
initiale.
Exemple :
B = "0011101011100010010111101001110011011101"
La fonction decompresse (codesH , B) retourne la liste initiale :
[ 12, 29, 46, 29, 31, 8, 12, 55, 29 , 8, 12, 29, 31, 29, 8, 29, 8]
Page 8 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 9 —
Épreuve d’Informatique — Session 2017 — Filière MP/ PSI/ TSI
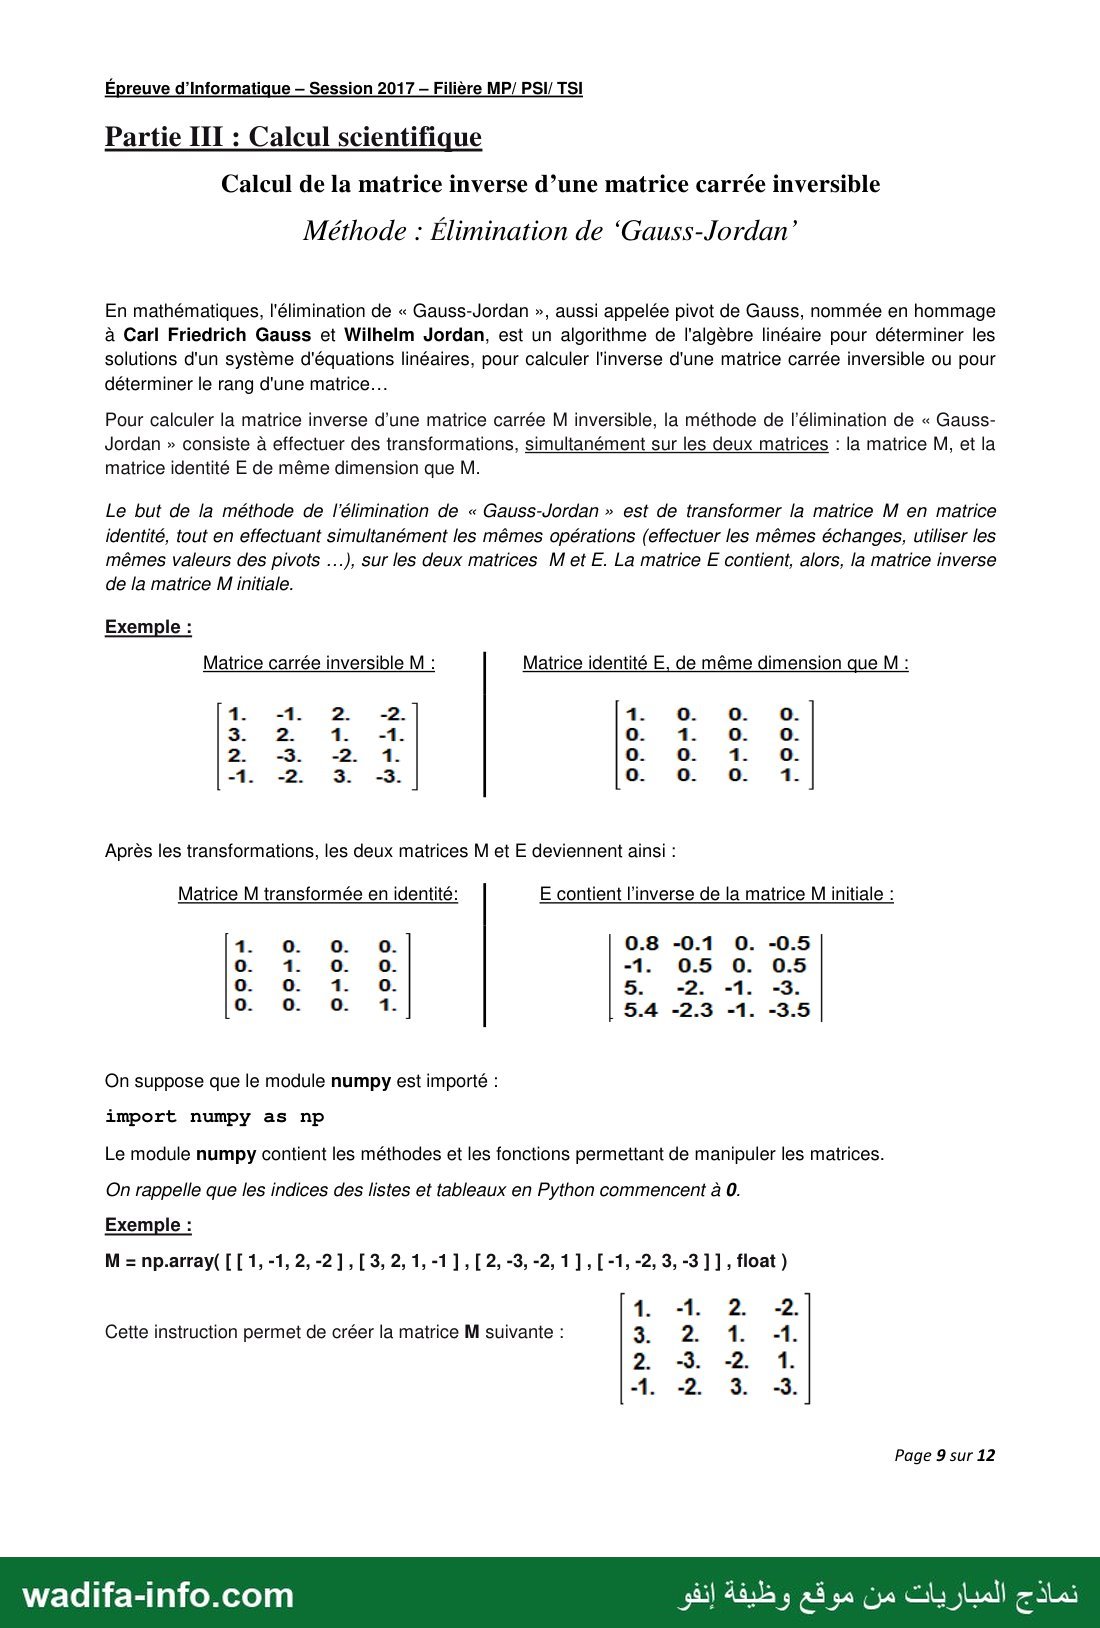
Partie III : Calcul scientifique
Calcul de la matrice inverse d’une matrice carrée inversible
Méthode : Élimination de ‘Gauss-Jordan’
En mathématiques, l'élimination de « Gauss-Jordan », aussi appelée pivot de Gauss, nommée en hommage
à Carl Friedrich Gauss et Wilhelm Jordan, est un algorithme de l'algèbre linéaire pour déterminer les
solutions d'un système d'équations linéaires, pour calculer l'inverse d'une matrice carrée inversible ou pour
déterminer le rang d'une matrice…
Pour calculer la matrice inverse d’une matrice carrée M inversible, la méthode de l'élimination de « Gauss-
Jordan » consiste à effectuer des transformations, simultanément sur les deux matrices : la matrice M, et la
matrice identité E de même dimension que M.
Le but de la méthode de l'élimination de « Gauss-Jordan » est de transformer la matrice M en matrice
identité, tout en effectuant simultanément les mêmes opérations (effectuer les mêmes échanges, utiliser les
mêmes valeurs des pivots …), sur les deux matrices M et E. La matrice E contient, alors, la matrice inverse
de la matrice M initiale.
Exemple :
Matrice carrée inversible M : Matrice identité E, de même dimension que M :
1 -1l 2 2. 4. 0 © 0
Après les transformations, les deux matrices M et E deviennent ainsi :
Matrice M transformée en identité: E contient l'inverse de la matrice M initiale :
ps9P
#000
On suppose que le module numpy est importé :
import numpy as np
Le module numpy contient les méthodes et les fonctions permettant de manipuler les matrices.
On rappelle que les indices des listes et tableaux en Python commencent à 0.
Exemple :
Cette instruction permet de créer la matrice M suivante : 3 2 1 A.
Page 9 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 10 —
Épreuve d’Informatique — Session 2017 — Filière MP/ PSI/ TSI
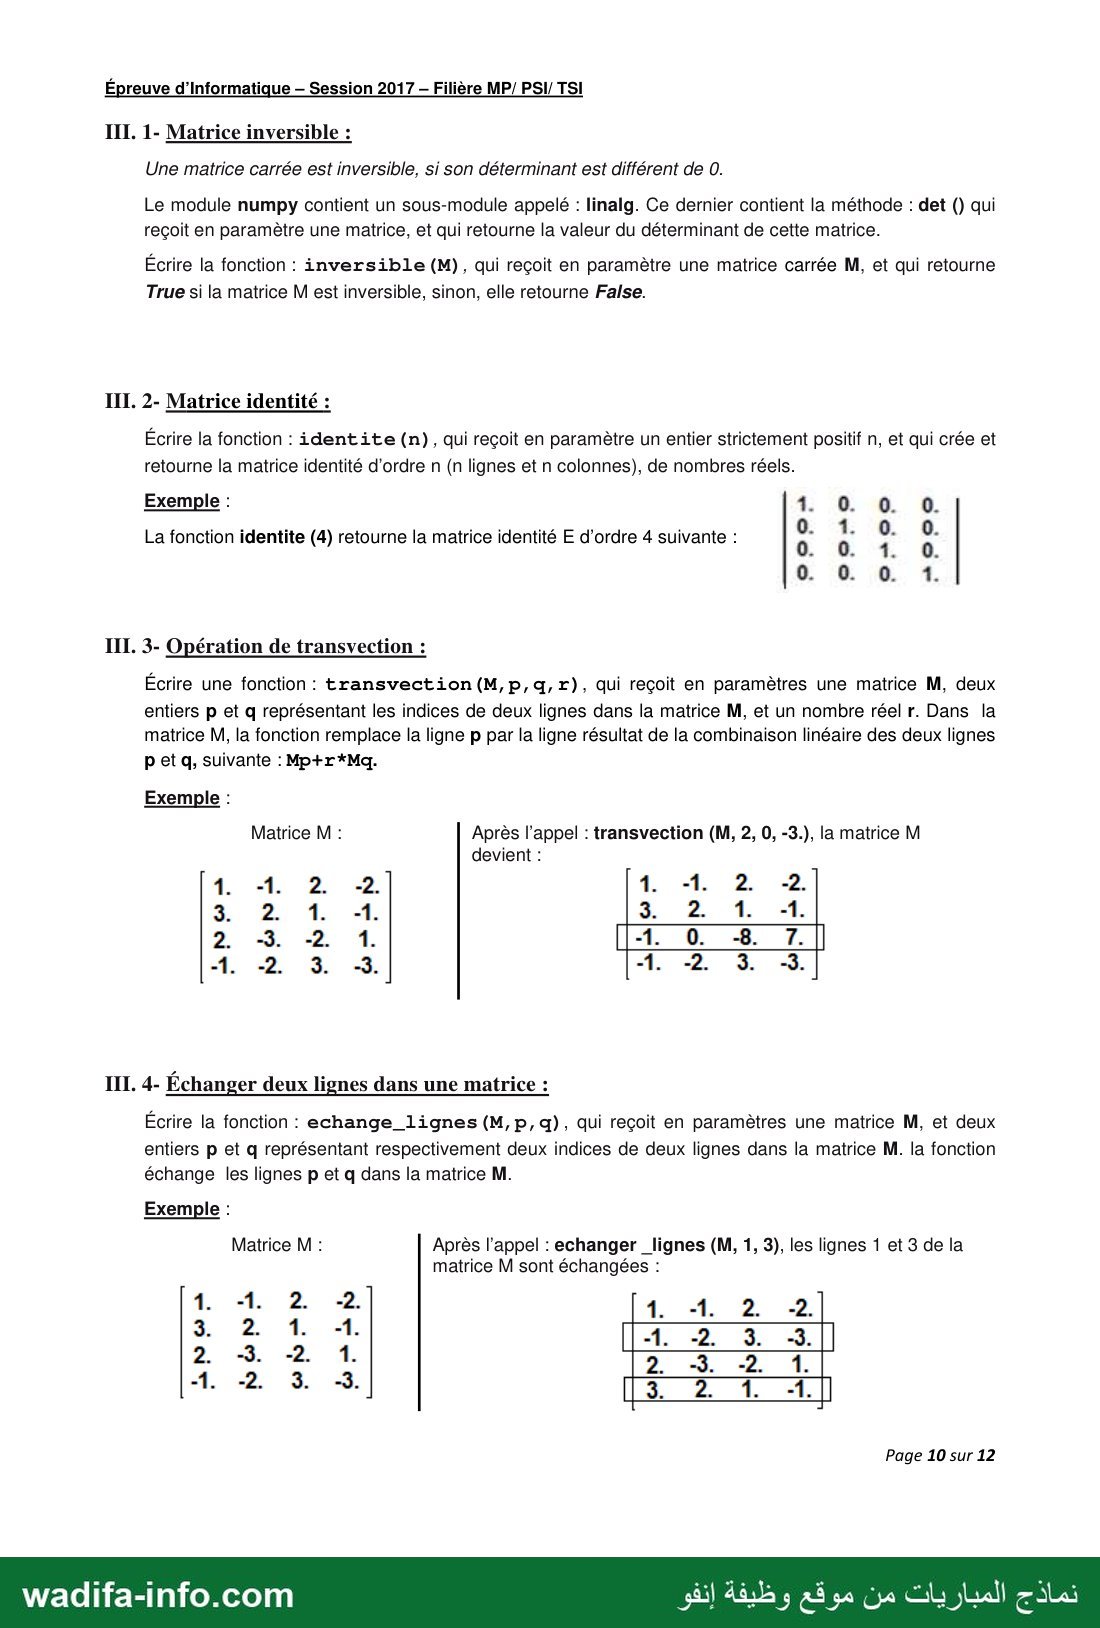
111. 1- Matrice inversible :
Une matrice carrée est inversible, si son déterminant est différent de 0.
Le module numpy contient un sous-module appelé : linalg. Ce dernier contient la méthode : det () qui
reçoit en paramètre une matrice, et qui retourne la valeur du déterminant de cette matrice.
Écrire la fonction : inversible (M), qui reçoit en paramètre une matrice carrée M, et qui retourne
True si la matrice M est inversible, sinon, elle retourne False.
III. 2- Matrice identité :
Écrire la fonction : identite (n), qui reçoit en paramètre un entier strictement positif n, et qui crée et
retourne la matrice identité d'ordre n (n lignes et n colonnes), de nombres réels.
Exemple :
La fonction identite (4) retourne la matrice identité E d’ordre 4 suivante :
بوه مهم
soso
e…no0
111. 3- Opération de transvection :
Écrire une fonction : transvection (M, P,4,r), qui reçoit en paramètres une matrice M, deux
entiers p et q représentant les indices de deux lignes dans la matrice M, et un nombre réel r. Dans la
matrice M, la fonction remplace la ligne p par la ligne résultat de la combinaison linéaire des deux lignes
p et q, suivante : Mp+r*Mq.
Exemple :
Matrice M : Après l’appel : transvection (M, 2, 0, -3.), la matrice M
devient :
3 2 1. -1
111. 4- Échanger deux lignes dans une matrice :
Écrire la fonction : echange_lignes (M, p, q), qui reçoit en paramètres une matrice M, et deux
entiers p et q représentant respectivement deux indices de deux lignes dans la matrice M. la fonction
échange les lignes p et q dans la matrice M.
Exemple :
Matrice M : Après l’appel : echanger _lignes (M, 1, 3), les lignes 1 et 3 de la
matrice M sont échangées :
Page 10 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 11 —
Épreuve d’Informatique — Session 2017 — Filière MP/ PSI/ TSI
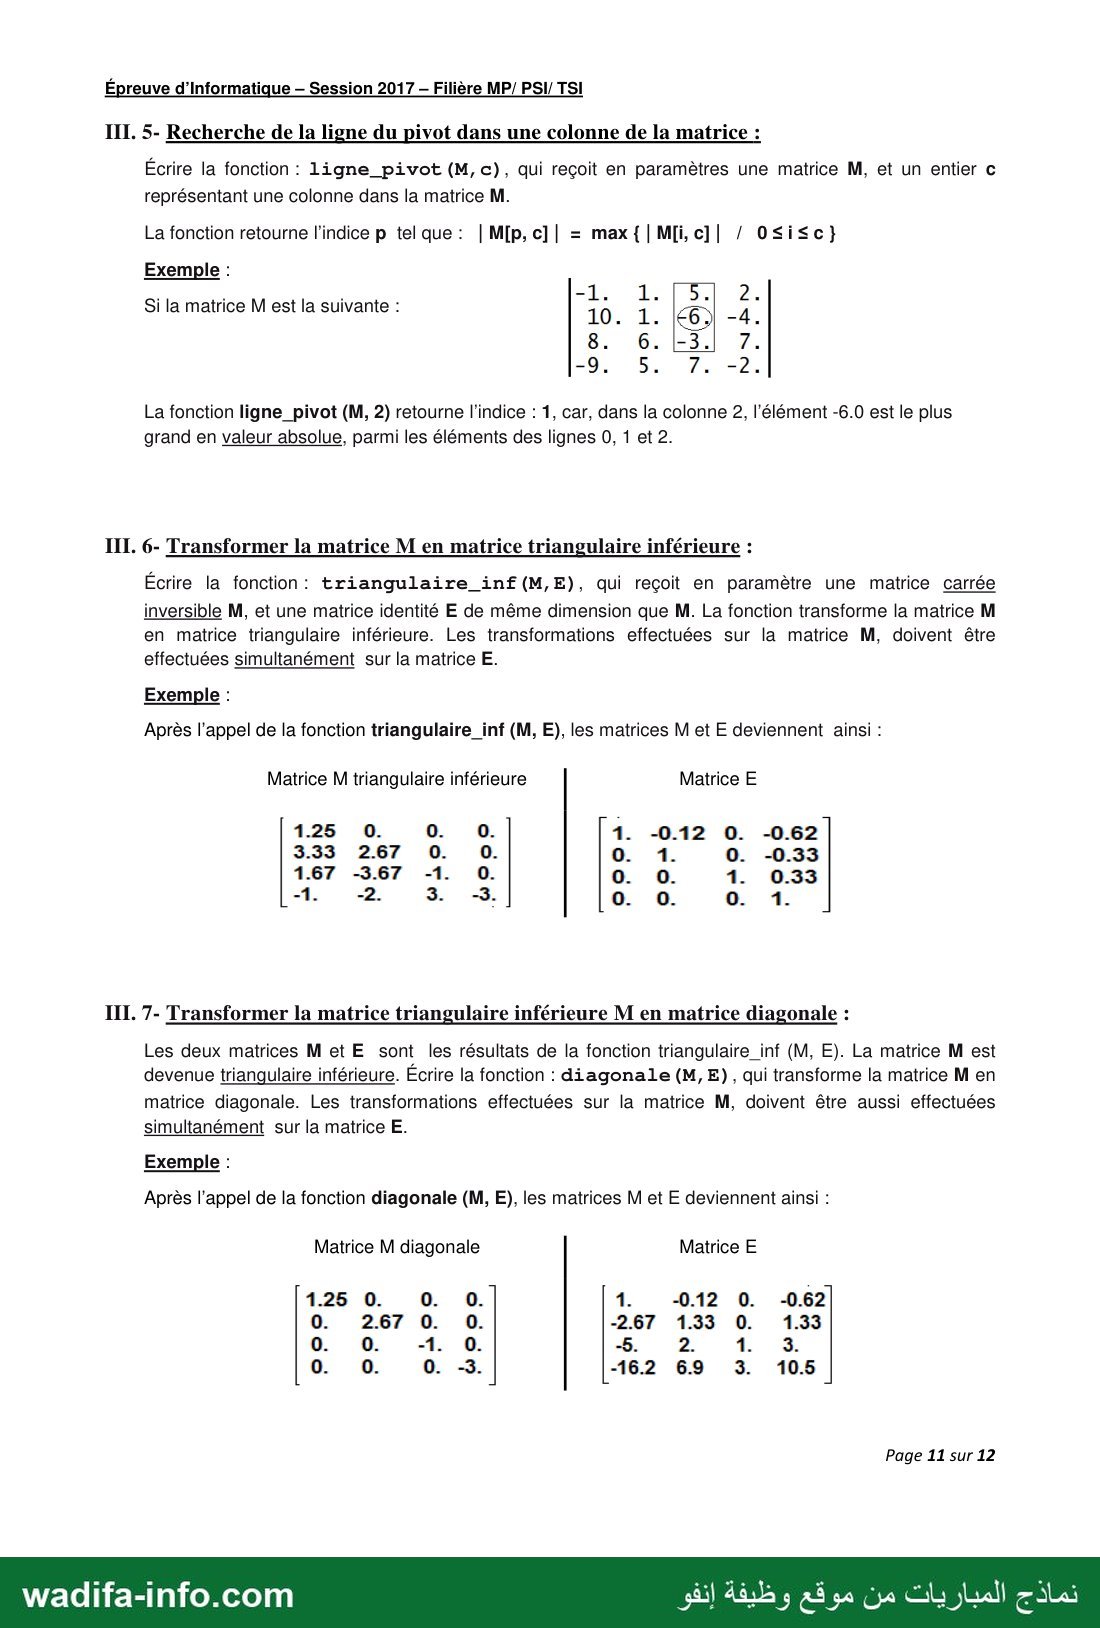
111. 5- Recherche de la ligne du pivot dans une colonne de la matrice :
Écrire la fonction : ligne_pivot (M, c), qui reçoit en paramètres une matrice M, et un entier ©
représentant une colonne dans la matrice M.
La fonction retourne l'indice م tel que : | M[p,c]| = max {| 0]. 0١ / O‹i‹c}
Exemple :
Si la matrice M est la suivante : 0 1: : ٍ
La fonction ligne_pivot (M, 2) retourne l'indice : 1, car, dans la colonne 2, l'élément -6.0 est le plus
grand en valeur absolue, parmi les éléments des lignes 0,1 et 2.
111. 6- Transformer la matrice M en matrice triangulaire inférieure :
Écrire la fonction : triangulaire _inf(M,E), qui reçoit en paramètre une matrice carrée
inversible M, et une matrice identité E de même dimension que M. La fonction transforme la matrice M
en matrice triangulaire inférieure. Les transformations effectuées sur la matrice M, doivent être
effectuées simultanément sur la matrice E.
Exemple :
Après l'appel de la fonction triangulaire_inf (M, E), les matrices M et E deviennent ainsi :
Matrice M triangulaire inférieure Matrice E
3.33 2.67 0. CO. © 1. 0. -0.33
1.67 -3.67 -1. 0 0. 0 1. 0-3
111.7- Transformer la matrice triangulaire inférieure M en matrice diagonale :
Les deux matrices M et E sont les résultats de la fonction triangulaire_inf (M, E). La matrice M est
devenue triangulaire inférieure. Écrire la fonction : diagonale (M, E), qui transforme la matrice M en
matrice diagonale. Les transformations effectuées sur la matrice M, doivent être aussi effectuées
simultanément sur la matrice E.
Exemple :
Après l'appel de la fonction diagonale (M, E), les matrices M et E deviennent ainsi :
Matrice M diagonale Matrice E
0 0 4. -0.12 0. -0.62
0. 2 0. -2.67 1.33 0.2 1.33
0 0 -3 -162 69 3. 10.5
Page 11 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
— صفحة 12 —
Épreuve d’Informatique — Session 2017 — Filière MP/ PSI/ TSI
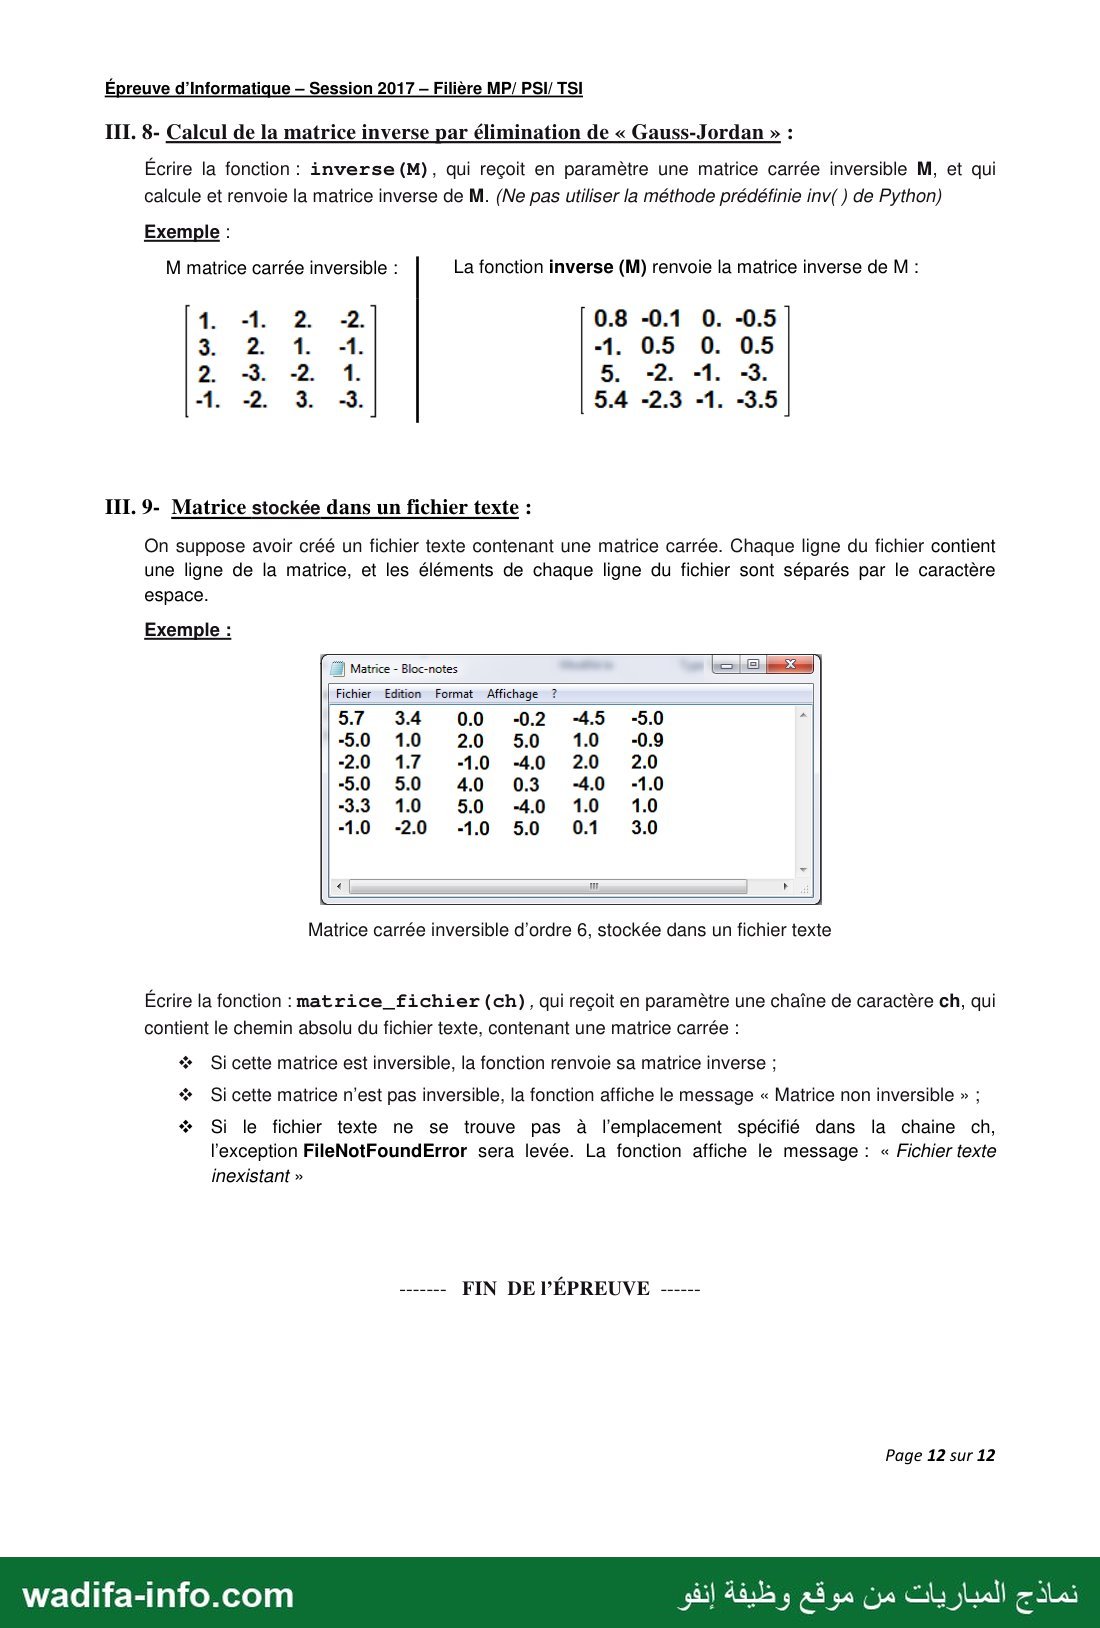
111. 8- Calcul de la matrice inverse par élimination de « Gauss-Jordan » :
Écrire la fonction : inverse (M), qui reçoit en paramètre une matrice carrée inversible M, et qui
calcule et renvoie la matrice inverse de M. (Ne pas utiliser la méthode prédéfinie inv( ) de Python)
Exemple :
M matrice carrée inversible : La fonction inverse (M) renvoie la matrice inverse de M :
41; À 2 -2 0.8 -0.1 0. -0.5
3. 2 1 À -1. 0.5 0. 5
III. 9- Matrice stockée dans un fichier texte :
On suppose avoir créé un fichier texte contenant une matrice carrée. Chaque ligne du fichier contient
une ligne de la matrice, et les éléments de chaque ligne du fichier sont séparés par le caractère
espace.
Exemple :
3 Matrice - Bloc-notes :اكد (El
Fichier Edition Format Affichage ?
5.7 4 00 -02 -45 -0 ب
-5.0 10 20 50 1.0 -09
-20 1.7 -1.0 -40 20 0
-50 50 4.0 03 -40 -1.0
-3.3 10 50 -40 10 1.0
-10 -20 -10 50 01 0
Matrice carrée inversible d'ordre 6, stockée dans un fichier texte
Écrire la fonction : matrice_fichier (ch), qui reçoit en paramètre une chaîne de caractère ch, qui
contient le chemin absolu du fichier texte, contenant une matrice carrée :
* Si cette matrice est inversible, la fonction renvoie sa matrice inverse ;
* Si cette matrice n'est pas inversible, la fonction affiche le message « Matrice non inversible » ;
* Si le fichier texte ne se trouve pas à l'emplacement spécifié dans la chaine ch,
l'exception FileNotFoundError sera levée. La fonction affiche le message : « Fichier texte
inexistant »
Page 12 sur 12
نماذج المباريات من موقع وظيفة إنفو wadifa-info.com
✅ التصحيح المقترح
هذا تصحيح مقترح من إعداد فريق wadifa-info لمساعدتك على فهم منهجية الإجابة — وليس تصحيحاً رسمياً صادراً عن الإدارة المنظِّمة. أسئلة هذا الامتحان محررة بالفرنسية، لذلك التصحيح محرر بالفرنسية أيضاً.
Ce sujet est l'épreuve d'Informatique du Concours National Commun (CNC), session 2017. Elle est commune aux filières MP, PSI et TSI et donne accès aux écoles d'ingénieurs marocaines. Le sujet fait 12 pages ; sa durée n'est pas indiquée sur les pages scannées. C'est une épreuve d'exercices de programmation en trois parties indépendantes. La partie I porte sur une base de données de compression de fichiers (algèbre relationnelle, SQL, sqlite3). La partie II traite la compression de Huffman d'une liste d'entiers : représentation binaire, méthode de Horner, tri en O(n log n), arbre binaire, codage et décodage. La partie III relève du calcul scientifique, avec l'inversion d'une matrice par élimination de Gauss-Jordan en numpy. Voici une correction méthodologique proposée.
💡 Avant de commencer : les trois parties sont indépendantes. Commencez par le SQL et par les petites fonctions de la partie II (binaire, entier, frequences), qui rapportent vite. Chaque exemple de l'énoncé sert de test : les fonctions ci-dessous ont été vérifiées sur les exemples du sujet. On retrouve le dictionnaire des codes {12:'00', 8:'01', 31:'100', 46:'1010', 55:'1011', 29:'11'}, la chaîne compressée et la matrice inverse. Pour le SQL, pensez à la division entière : tailleC/tailleF entre deux entiers donne 0 en SQLite. Multipliez par 1.0.
Partie I : base de données et langage SQL
On a Taux = (1 − tailleC/tailleF) × 100. Les jointures se font sur Compression.numeroF = Fichier.numeroF et sur Compression.format = Algorithme.format.
I.1. Algèbre relationnelle : fichiers entre 1 Ko et 1 Mo
πnomF( σ1024 ≤ tailleF ≤ 1048576(Fichier) )
On prend ici 1 Ko = 1024 octets et 1 Mo = 10242 = 1 048 576 octets. Si l'on adopte la convention décimale, les bornes deviennent 1000 et 106 : il suffit de l'indiquer sur la copie.
I.2. Fichiers .doc ou .docx triés par nom
SELECT nomF, tailleF
FROM Fichier
WHERE nomF LIKE '%.doc' OR nomF LIKE '%.docx'
ORDER BY nomF ASC;
I.3. Compressions dont le taux dépasse 40 %
SELECT F.nomF, C.format, A.type,
(1 - 1.0 * C.tailleC / F.tailleF) * 100 AS taux
FROM Fichier F
JOIN Compression C ON F.numeroF = C.numeroF
JOIN Algorithme A ON C.format = A.format
WHERE (1 - 1.0 * C.tailleC / F.tailleF) * 100 > 40
ORDER BY F.numeroF;
Avec les données d'exemple, Nature.bmp compressé en jpeg donne un taux d'environ 94,9 %. Répéter l'expression dans le WHERE est la forme la plus portable, car tous les SGBD n'acceptent pas l'alias à cet endroit.
I.4. Algorithmes sans perte ayant compressé 3, 5 ou 8 fichiers
SELECT A.format, COUNT(DISTINCT C.numeroF) AS nb
FROM Algorithme A
JOIN Compression C ON A.format = C.format
WHERE A.type = 0
GROUP BY A.format
HAVING COUNT(DISTINCT C.numeroF) IN (3, 5, 8);
La condition sur type va dans le WHERE, car elle filtre des lignes. La condition sur le compte va dans le HAVING, car elle filtre des groupes.
I.5. Les 3 plus grands taux, triés par ordre croissant
SELECT taux FROM
(SELECT (1 - 1.0 * C.tailleC / F.tailleF) * 100 AS taux
FROM Compression C JOIN Fichier F ON C.numeroF = F.numeroF
ORDER BY taux DESC
LIMIT 3)
ORDER BY taux ASC;
La sous-requête garde les 3 plus grands taux (tri décroissant puis LIMIT 3). La requête externe les remet en ordre croissant.
I.6. Programme Python : taux moyen d'un format
fmt = input("Format de compression : ")
cnx = sqlite3.connect("C:\\BDcompressions.sql")
cur = cnx.cursor()
cur.execute("SELECT AVG((1 - 1.0*C.tailleC/F.tailleF)*100) FROM Compression C JOIN Fichier F ON C.numeroF = F.numeroF WHERE C.format = ?", (fmt,))
res = cur.fetchone()
if res[0] is None:
print("Le format saisi n'existe pas dans la BD")
else:
print("Taux moyen :", res[0])
cnx.close()
AVG renvoie NULL, c'est-à-dire None en Python, quand aucune ligne ne correspond. On peut aussi tester d'abord l'existence du format avec SELECT COUNT(*) FROM Algorithme WHERE format = ?. La requête paramétrée (?) évite l'injection SQL. Dans la chaîne Python, le chemin s'écrit "C:\\BDcompressions.sql", avec la barre oblique inverse doublée.
Partie II : compression de Huffman
II.1. Plus grand entier positif sur 12 bits avec bit de signe
Un bit est réservé au signe, il reste 11 bits pour la valeur. Le maximum est donc 11 bits à 1, soit 211 − 1 = 2047. En complément à deux, l'intervalle représentable est [−2048, 2047] : le maximum positif est le même.
II.2.a. binaire(N), bit de poids faible en tête
def binaire(N):
if N == 0:
return "0"
s = ""
while N > 0:
s = s + str(N % 2)
N = N // 2
return s
On a bien binaire(23) = "11101", car 23 → reste 1, 11 → 1, 5 → 1, 2 → 0, 1 → 1.
II.2.b. Complexité
La boucle s'exécute autant de fois que N a de bits, soit ⌊log2 N⌋ + 1 fois. Chaque tour fait un nombre borné d'opérations élémentaires. La complexité est donc O(log N), logarithmique en N et linéaire en la taille de l'écriture binaire.
II.2.c. entier(B) par la méthode de Horner
Le caractère B[i] est le coefficient ai de 2i. Horner part du coefficient de plus haut degré, donc du dernier caractère : v ← 2v + ai.
def entier(B):
v = 0
for i in range(len(B) - 1, -1, -1):
v = 2 * v + int(B[i])
return v
La fonction fait un seul passage, avec une multiplication par bit : O(len(B)). On vérifie que entier("11101") = 23.
II.3. frequences(L)
def frequences(L):
d = {}
for x in L:
d[x] = d.get(x, 0) + 1
return list(d.items())
La complexité est O(n) avec un dictionnaire. On obtient les mêmes couples que l'exemple : (8,4), (12,3), (46,1), (55,1), (29,6), (31,2). Sans dictionnaire, une double boucle donnerait O(n·k).
II.4. tri(F) en O(n log n) : tri fusion sur les occurrences
def tri(F):
if len(F) <= 1:
return F[:]
m = len(F) // 2
G = tri(F[:m])
D = tri(F[m:])
R = []
i = j = 0
while i < len(G) and j < len(D):
if G[i][1] <= D[j][1]:
R.append(G[i]); i += 1
else:
R.append(D[j]); j += 1
return R + G[i:] + D[j:]
La complexité vérifie C(n) = 2C(n/2) + O(n), d'où O(n log n). Le tri fusion est stable. L'ordre entre deux poids égaux n'est pas imposé par Huffman : il change les codes, mais pas l'optimalité.
II.5.a. insere(F, T) en temps linéaire
def insere(F, T):
F.append(T)
i = len(F) - 1
while i > 0 and F[i-1][1] > T[1]:
F[i] = F[i-1]
i -= 1
F[i] = T
C'est le principe du tri par insertion : on décale vers la droite les éléments de poids strictement supérieur. Le tuple est donc placé après les poids égaux, comme dans l'exemple où (A,2) se retrouve après (31,2). L'appel avec T = (17,5) donne bien […, (8,4), (17,5), (29,6)]. Il y a au plus n décalages : O(n).
II.5.b. arbre_Huffman(F)
On remplace chaque élément x par la feuille [x, [], []]. Chaque tuple de la liste contient alors (sous-arbre, poids). Un nouveau nœud a pour valeur la somme des poids, comme sur les figures (17, 7, 10, 4, 2).
def arbre_Huffman(F):
G = tri([([x, [], []], p) for (x, p) in F])
while len(G) >= 2:
g, pg = G.pop(0)
d, pd = G.pop(0)
insere(G, ([pg + pd, g, d], pg + pd))
return G[0][0]
Sur l'exemple, on obtient [17, [7, [12,[],[]], [8,[],[]]], [10, [4, [31,[],[]], [2, [46,[],[]], [55,[],[]]]], [29,[],[]]]]. C'est exactement l'arbre de la 5e étape. Le premier élément retiré devient le fils gauche.
II.6. codes_Huffman(A, code, codesH)
On fait un parcours récursif en profondeur. Une feuille se reconnaît à ses deux sous-arbres vides, et non à sa valeur, car une valeur de feuille peut égaler un poids.
def codes_Huffman(A, code, codesH):
if A[1] == [] and A[2] == []:
codesH[A[0]] = code
else:
codes_Huffman(A[1], code + "0", codesH)
codes_Huffman(A[2], code + "1", codesH)
L'arbre de Huffman est complet : chaque nœud a 0 ou 2 fils. Comme L contient au moins deux valeurs distinctes, la racine n'est pas une feuille et aucun code n'est vide. On obtient {12:'00', 8:'01', 31:'100', 46:'1010', 55:'1011', 29:'11'}.
II.7. compresse(L, codesH)
def compresse(L, codesH):
return "".join(codesH[x] for x in L)
On retrouve la chaîne de l'énoncé, "0011101011100010010111101001110011011101", soit 40 bits. Pour comparaison, 17 entiers codés sur 12 bits en occupent 204.
II.8. decompresse(codesH, B)
Le code de Huffman est préfixe : aucun code n'est le début d'un autre. On lit donc les bits un à un et on émet un élément dès que le tampon est un code connu.
def decompresse(codesH, B):
inv = {c: x for x, c in codesH.items()}
L = []
c = ""
for b in B:
c = c + b
if c in inv:
L.append(inv[c])
c = ""
return L
On retrouve la liste initiale. Une variante consiste à descendre dans l'arbre : 0 à gauche, 1 à droite, et retour à la racine à chaque feuille atteinte.
Partie III : inverse d'une matrice par Gauss-Jordan (numpy)
III.1. inversible(M)
def inversible(M):
return abs(np.linalg.det(M)) > 1e-12
La réponse attendue est np.linalg.det(M) != 0. Avec des flottants, comparer à un petit seuil est plus sûr, car le déterminant calculé d'une matrice singulière vaut rarement 0 exactement.
III.2. identite(n)
def identite(n):
E = np.zeros((n, n), float)
for i in range(n):
E[i, i] = 1.0
return E
III.3. transvection(M, p, q, r) : Lp ← Lp + r·Lq
def transvection(M, p, q, r):
M[p] = M[p] + r * M[q]
Avec l'exemple transvection(M, 2, 0, −3.), la ligne 2 devient [−1, 0, −8, 7]. La modification se fait en place, donc rien n'est renvoyé.
III.4. echange_lignes(M, p, q)
def echange_lignes(M, p, q):
t = M[p].copy()
M[p] = M[q]
M[q] = t
Le .copy() est indispensable : M[p] est une vue sur le tableau. Sans copie, on écraserait la ligne avant de l'avoir sauvegardée. On peut aussi écrire M[[p, q]] = M[[q, p]].
III.5. ligne_pivot(M, c) : maximum de |M[i,c]| pour 0 ≤ i ≤ c
def ligne_pivot(M, c):
p = 0
for i in range(1, c + 1):
if abs(M[i, c]) > abs(M[p, c]):
p = i
return p
Sur l'exemple, ligne_pivot(M, 2) renvoie 1, car |−6| est le maximum parmi 5, −6 et −3. Choisir le pivot de plus grande valeur absolue (pivot partiel) limite les erreurs d'arrondi.
III.6. triangulaire_inf(M, E)
On déduit le procédé de l'exemple (lignes 3 et 0 de M, ligne 3 de E inchangées). On traite les colonnes de la dernière vers la deuxième. Pour chaque colonne c, on cherche le pivot parmi les lignes 0..c et on le ramène en ligne c. On annule ensuite les coefficients situés au-dessus dans la colonne c. Chaque opération est faite en même temps sur E.
def triangulaire_inf(M, E):
n = len(M)
for c in range(n - 1, 0, -1):
p = ligne_pivot(M, c)
if p != c:
echange_lignes(M, p, c)
echange_lignes(E, p, c)
for i in range(c):
r = -M[i, c] / M[c, c]
transvection(M, i, c, r)
transvection(E, i, c, r)
Cette fonction reproduit exactement les matrices de l'exemple : M a pour première colonne [1.25, 3.33, 1.67, −1] et E a pour première ligne [1, −0.12, 0, −0.62]. Le pivot M[c,c] est non nul. En effet, après le traitement des colonnes suivantes, le bloc formé des lignes et colonnes 0..c est inversible, sinon M ne le serait pas.
III.7. diagonale(M, E)
M est maintenant triangulaire inférieure. On annule les coefficients sous la diagonale, colonne par colonne de gauche à droite, avec la ligne c comme pivot. Cette ligne n'a que des zéros à droite de c, donc la structure est préservée.
def diagonale(M, E):
n = len(M)
for c in range(n - 1):
for i in range(c + 1, n):
r = -M[i, c] / M[c, c]
transvection(M, i, c, r)
transvection(E, i, c, r)
On retrouve M = diag(1.25, 2.67, −1, −3) et la ligne 3 de E égale à [−16.2, 6.9, 3, 10.5], comme dans l'énoncé.
III.8. inverse(M)
Il reste à diviser chaque ligne par son coefficient diagonal. On travaille sur une copie pour ne pas détruire M.
def inverse(M):
M = M.copy()
n = len(M)
E = identite(n)
triangulaire_inf(M, E)
diagonale(M, E)
for i in range(n):
E[i] = E[i] / M[i, i]
return E
Sur l'exemple, on obtient [[0.8, −0.1, 0, −0.5], [−1, 0.5, 0, 0.5], [5, −2, −1, −3], [5.4, −2.3, −1, −3.5]], conforme à l'énoncé. La complexité est O(n3).
III.9. matrice_fichier(ch)
def matrice_fichier(ch):
try:
f = open(ch, "r")
except FileNotFoundError:
print("Fichier texte inexistant")
return None
T = []
for ligne in f:
if ligne.strip() != "":
T.append([float(x) for x in ligne.split()])
f.close()
M = np.array(T, float)
if not inversible(M):
print("Matrice non inversible")
return None
return inverse(M)
Sans argument, split() découpe sur n'importe quelle suite d'espaces, ce qui gère les alignements du fichier. Le test sur les lignes vides évite une ligne parasite en fin de fichier.
💡 À réviser pour l'informatique du CNC (MP/PSI/TSI) : SQL (jointures multiples, GROUP BY / HAVING, sous-requête avec LIMIT, piège de la division entière) ; module sqlite3 (connect, cursor, execute avec paramètre ?, fetchone/fetchall) ; conversions binaire/décimal et méthode de Horner ; tris en O(n log n) (fusion, rapide) et insertion dans une liste triée ; arbres binaires représentés par des listes et leurs parcours récursifs ; codage de Huffman et propriété du préfixe ; pivot de Gauss avec numpy (vues et copies de lignes, pivot partiel, transvections) ; lecture de fichiers texte avec try/except. Testez systématiquement chaque fonction sur l'exemple de l'énoncé : c'est ce que font les correcteurs.
أسئلة شائعة حول هذا النموذج
هل يمكن تحميل هذا النموذج مجاناً؟
هل يتضمن هذا النموذج التصحيح؟
ما هي الجهة المنظمة والدرجة المعنية بهذا النموذج؟
ما هي دورة هذا الامتحان ولغة أسئلته؟
أين أجد نماذج أخرى لنفس المباراة؟
💬 ناقش هذا النموذج (0)
شارك إجاباتك أو صحّح التصحيح — إذا كان لديك رأي مختلف حول أي نقطة، اكتبه هنا ليستفيد باقي المترشحين.
لا يوجد نقاش بعد — شارك إجابتك أو سؤالك حول هذا النموذج.
⚠️ ممنوع نشر أرقام الهاتف أو الروابط أو أي عرض مقابل مال — تُحذف هذه المشاركات تلقائياً.
هل تحضّر لهذه المباراة؟
نماذج مشابهة قد تهمّك
المصدر: مباريات ولوج المدارس والمعاهد العليا
📎 كيف تستشهد بهذه الصفحة؟
صحفي أو مدوّن أو أستاذ؟ انسخ المرجع أسفله وضع رابطاً نحو هذه الصفحة.
الرابط الدائم: https://www.wadifa-info.com/نموذج-مباراة/1745/نموذج-المباراة-الوطنية-المشتركة-CNC-2017-المعلوميات-شعبة-MP-وPSI-وTSI-لولوج-مدار
